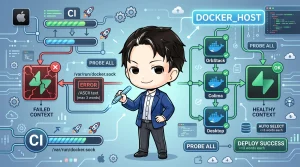
CIのsupabase startが即死する原因はdocker contextのズレ。リトライ前にprobeで防ぐ方法
self-hostedランナーで複数のDocker実装が同居すると、Supabase CLIが死んだdefault contextへ直行してE2Eが即失敗します。起動前にdocker contextをprobeしてDOCKER_HOSTを固定する対策を、コード付きで解説します。
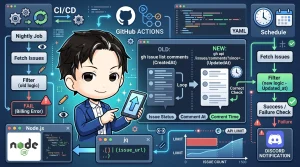
GitHub Actionsの夜間バッチが21晩失敗していた話:bot自身の編集で再判定が止まらない問題と失敗通知の作り方
Issueを夜間に自動分類するCIジョブが3週間ほど毎晩失敗していました。原因はbotが自分のコメント編集で判定済みIssueが候補に戻ってしまうループと、失敗を知らせる通知が無かったことです。判定基準をupdated_atへ切り替え、失敗時だけDiscordに通知するjobを追加して解決しました。
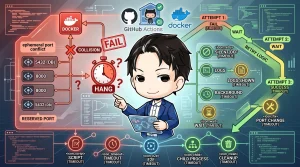
CIでローカルDBがポート競合で落ちる原因はephemeral portだった:ハングも拾うリトライ設計
CI でローカル DB(Docker ベースのバックエンドスタック)を起動すると、ごくまれに「ポートが既に使用されています」というエラーで落ちることがあります。
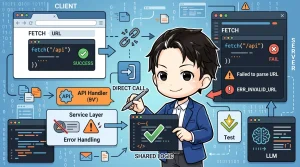
Next.jsのサーバー内で自分のAPIを相対URLのfetchで呼ぶと失敗する理由と、直接呼び出しへの直し方
実運用中のサービスで「LLMの返信だけ保存されない」不具合が発生。原因はサーバー内で自分のAPIを相対URLのfetchで呼んでいたことです。Node上では相対URLが解決できず失敗し、エラーも握りつぶされ気づけない構成でした。解決策と回帰テストまで解説します。
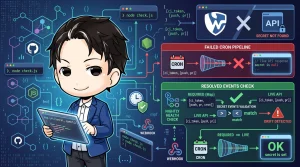
Woodpecker CIのcronだけ「secret not found」で止まる原因と、Events設定ずれを夜間に検出する方法
Woodpecker CI で cron のときだけ secret not found になるのは、repo secret の Events 設定が cron に対応していないためです。Node.js と GitHub Actions を使い、この設定ずれ(drift)を夜間ヘルスチェックで自動検出する方法を紹介します。
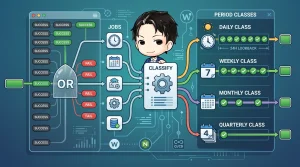
cron監視の「どれか1本成功すればOK」をやめる:ジョブごとの死活監視を周期クラスで設計する
定期ジョブの監視を「直近24時間に1件でも成功していれば green」で済ませていませんか。cron式から周期クラスを自動推定し、ジョブごとに適切な期間で成功を評価、失敗原因まで分類するper-cronヘルスチェックの設計を解説します。
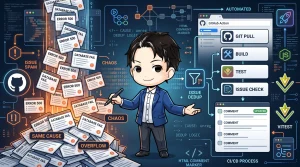
夜間監視の自動起票が『同じ原因なのに量産される』を止めた話
夜間の監視ジョブが失敗するたびにGitHub Issueを自動起票する仕組みは便利ですが、同じ原因の失敗が続くと毎晩issueが積み上がります。本記事では同一原因のopenなissueに追記し、なければ新規作成するdedupロジックで増殖を解消した設計を紹介します。
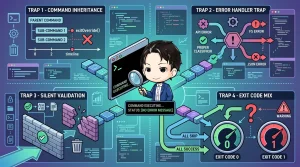
CLIの「エラーは出ているはずなのに何も表示されない」を追ったら見えた4つの罠
社内向けのCLIツールで、「エラーは出ているはずなのに何も表示されず、終了コードだけがおかしい」という不具合を追いかけたことはないでしょうか。
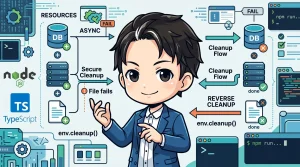
Node/TypeScriptで複数の非同期リソースを安全に確保・解放するcleanupパターン
Node/TypeScriptでDBやHTTPサーバなど複数の非同期リソースを安全に確保・解放する「cleanupパターン」を解説。確保途中の失敗時も確実に巻き戻し、処理終了時には逆順で解放することで、リソースの残存を防ぐ堅牢な実装を紹介します。
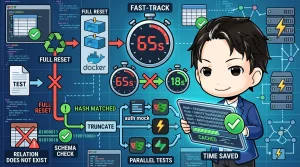
ローカルE2Eを65s→15-18sに短縮した話:Supabase migrationの環境差吸収とハッシュキャッシュ
Supabase CLIのバンドルDockerと本番の storage.prefixes 差でマイグレーションが壊れた問題を to_regclass() で吸収し、さらに マイグレーションハッシュキャッシュ + DBリセットとauthモックの並列化で npm run e2e を 65s → 15-18s(-72%)に短縮した実装記録。