
はじめに
CIのE2Eテストで、DB起動用のCLIツール(Supabase CLI)が1秒未満で失敗し、リトライを何度回しても直らない、という現象に遭遇しました。
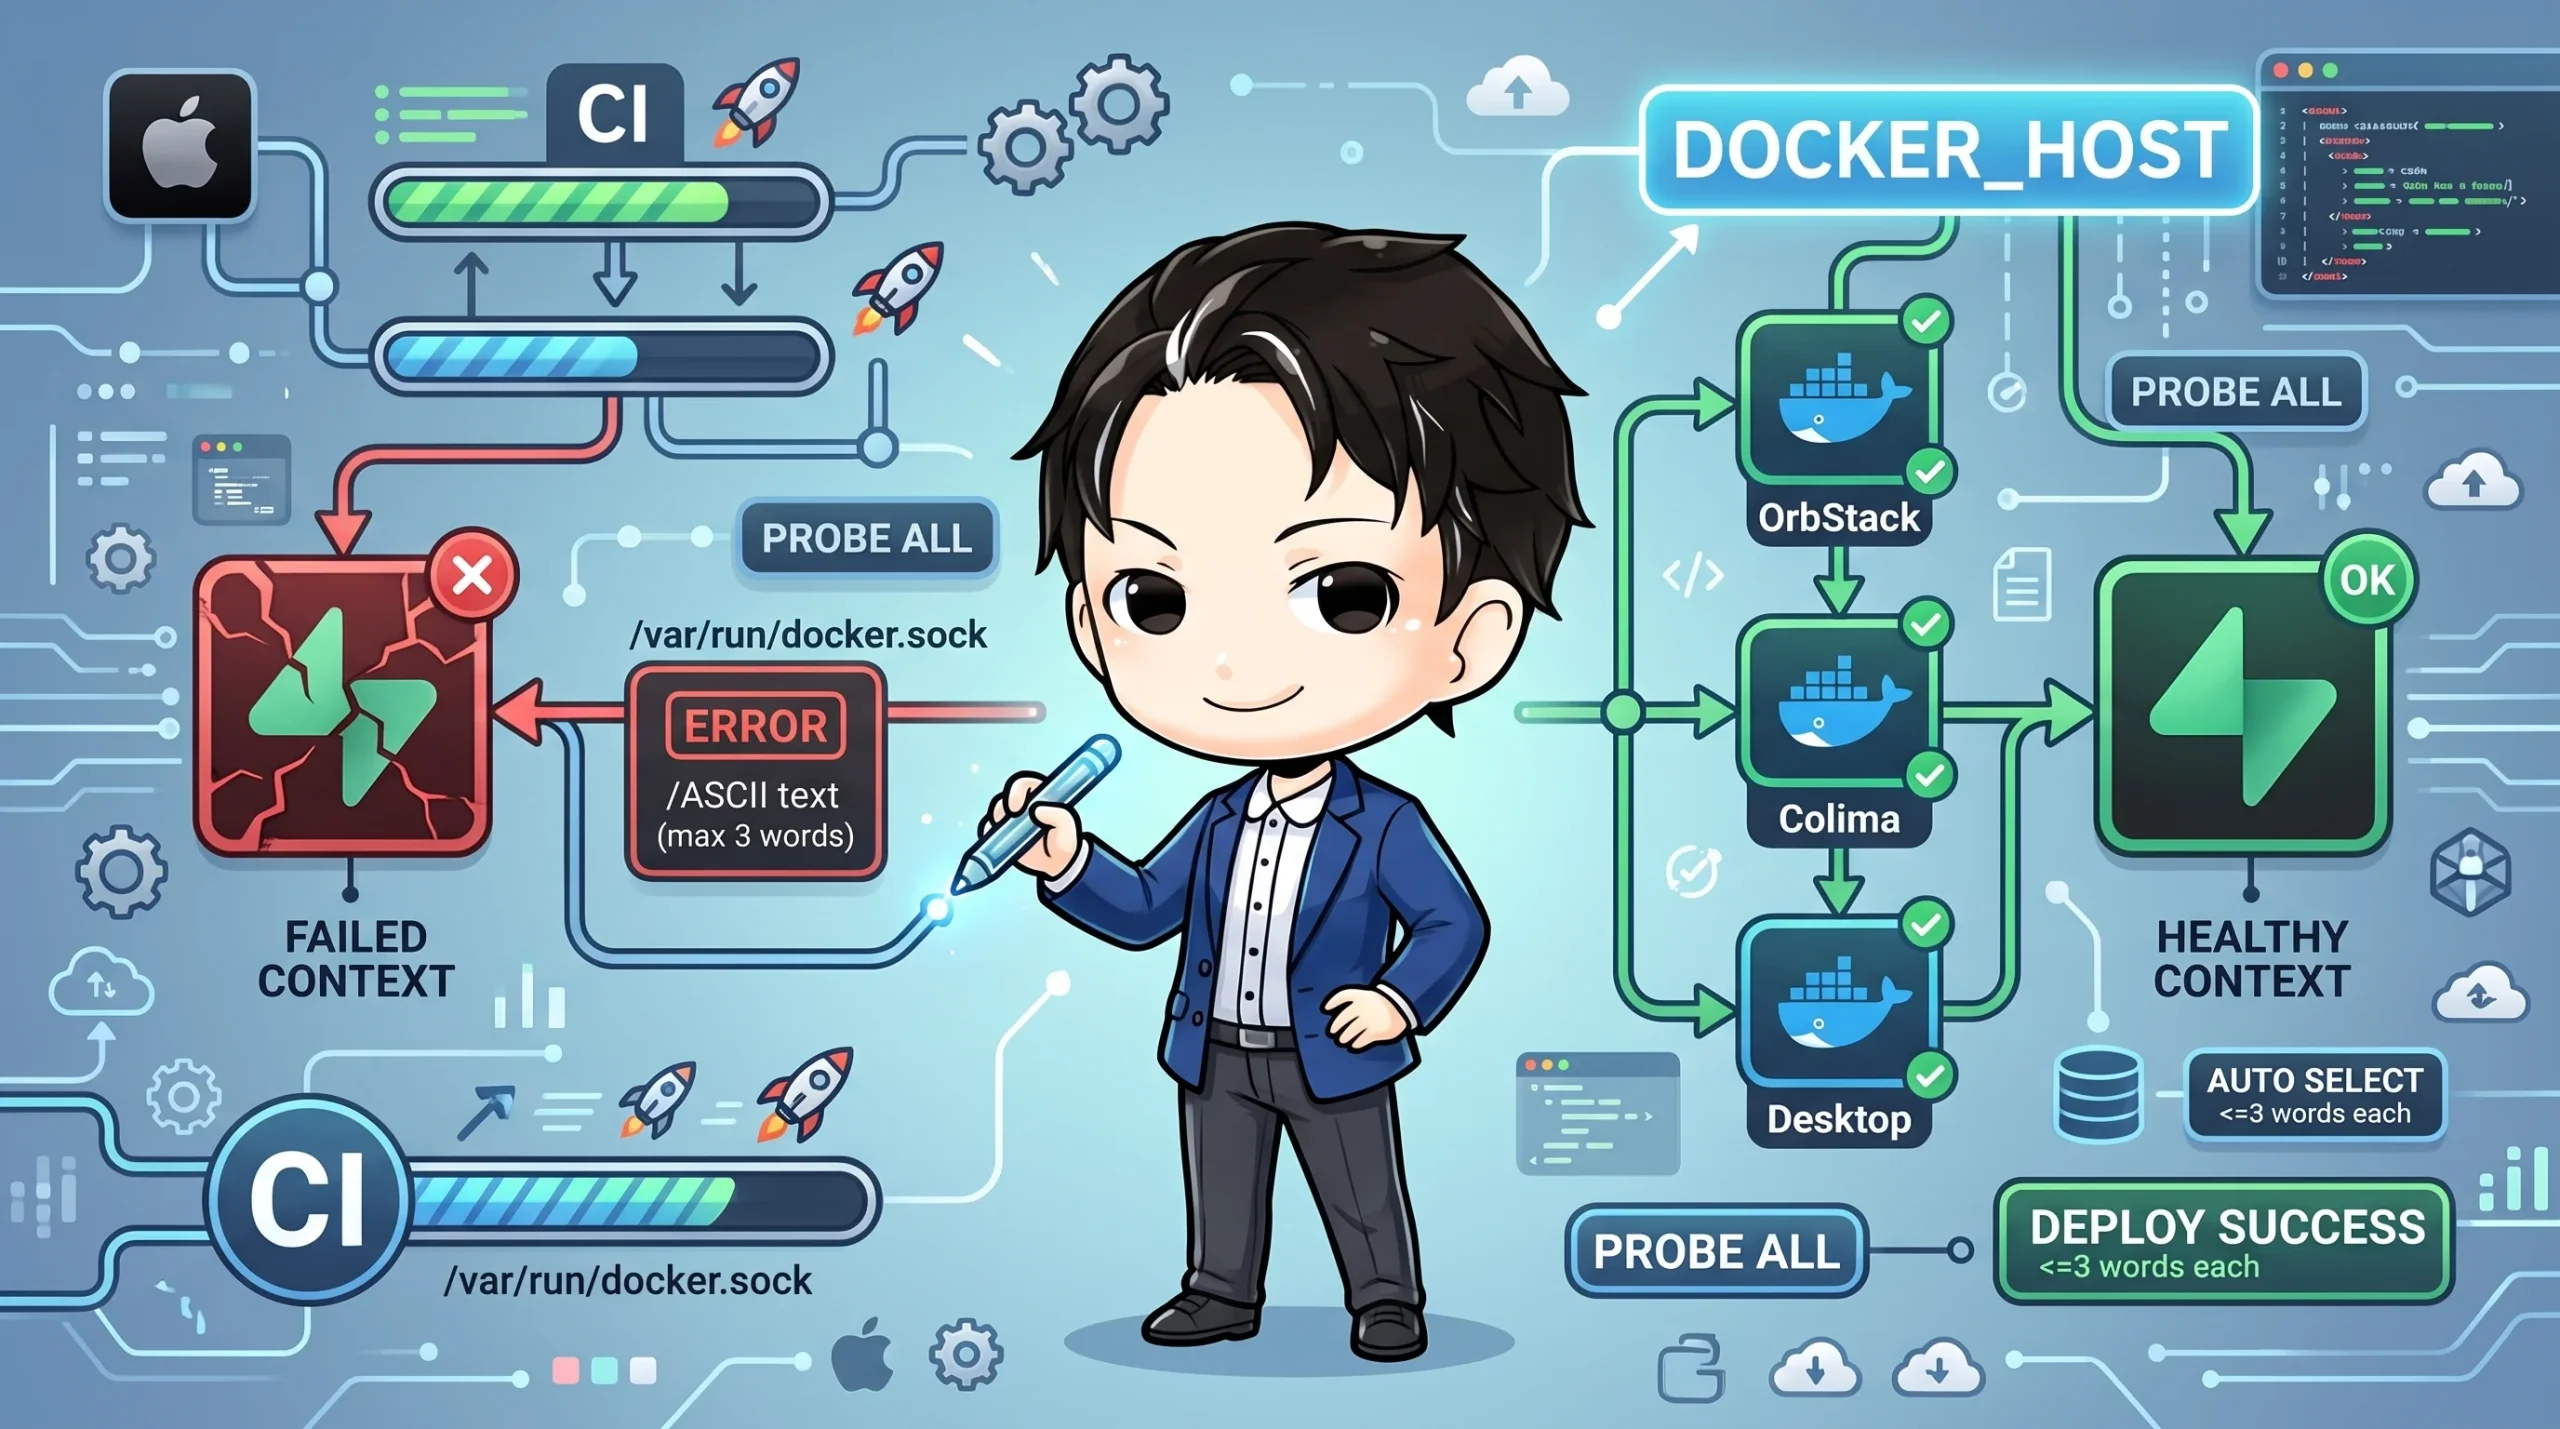
原因は、docker コマンドのcurrent contextと、CLIツールが実際に接続しにいくcontextがズレていたことでした。
この記事では、self-hostedのMacランナーでDocker Desktop、OrbStackなど複数のDocker実装が同居している環境を例に、問題の切り分けと対策を紹介します。
対策の要点は、起動前に全docker contextをprobeして、健全なendpointを DOCKER_HOST に明示することです。
こんな人におすすめ
- self-hostedランナーでE2Eテスト用のDBを起動しており、原因不明の即時失敗に悩んでいる方
- Docker Desktop、OrbStack、Colimaなど複数のDocker実装を同じマシンで使っている方
- CIのリトライ機構が「無意味に消費されているだけ」になっていないか見直したい方
- GitHub Actionsのステップ間で環境変数を引き継ぐ方法を確認したい方
何が起きていたのか
症状は次のとおりです。
docker psは成功する(current contextは健全)- 同じマシンで
supabase startだけが1秒未満で失敗する - リトライしても毎回同じ結果になる
Supabase CLIは、DOCKER_HOST が未設定のとき、docker CLIのcurrent contextを見ずに default contextへ直行する挙動でした。
default contextの実体は、実質的に /var/run/docker.sock です。
複数のDocker実装が同居していると、current contextは健全でも、default 側のdaemonだけが死んでいる状態が起こります。
この失敗は一過性ではなく決定的です。
そのため、リトライ回数を増やしても何も解決せず、時間とリトライ予算を消費するだけでした。
まず手元で状況を確認するには、次のコマンドが役立ちます。
# 全contextと、どれがcurrentかを確認
docker context ls

# default contextのendpointを明示して疎通確認
DOCKER_HOST=unix:///var/run/docker.sock docker info > /dev/null && echo OK || echo NG
起動前にprobeして健全なendpointを選ぶ
即座に決定的に失敗するエラーは、リトライより先にヘルスチェックを挟む設計が本質的です。
ここでは default を最優先にprobeし、死んでいれば他のcontextを順に試します。
export async function findHealthyDockerEndpoint(contexts, probe) {
  const ordered = [...contexts].sort(
    (a, b) => Number(b.name === 'default') - Number(a.name === 'default')
  )
  for (const context of ordered) {
    if (await probe(context)) return context
  }
  return null
}
default を先頭に寄せているのは、本来の挙動を変えずに済むケースでは何も上書きしないためです。
default が健全なら、結果は従来と同じになります。
DOCKER_HOSTを解決し、全滅時もsilentにしない
次に、probe結果から DOCKER_HOST を決める関数です。
ユーザーが既に DOCKER_HOST を設定している場合は、それを尊重して何もしません。
export async function resolveDockerHost({ env = process.env, listContexts, probe } = {}) {
  if (env.DOCKER_HOST) {
    return { override: null, resolvedDockerHost: env.DOCKER_HOST, fallback: null, allUnreachable: false }
  }

  const contexts = await listContexts()
  if (contexts.length === 0) {
    return { override: null, resolvedDockerHost: null, fallback: null, allUnreachable: false }
  }

  const healthy = await findHealthyDockerEndpoint(contexts, probe)
  if (!healthy) {
    return { override: null, resolvedDockerHost: null, fallback: null, allUnreachable: true }
  }
  // ...healthy な endpoint を override / fallback 情報として返す
}
ポイントは、全probeが失敗したときにfast-failしないことです。
probe自体も、daemon起動直後などは一時的に失敗しえます。
そこで DOCKER_HOST を未設定のまま従来のリトライフローに戻し、allUnreachable を警告として可視化します。
# 呼び出し側の例: 全滅時は警告を出して従来フローへ
echo "::warning::all docker contexts are unreachable; falling back to default retry flow"
この設計により、ヘルスチェックの誤判定で既存の復旧経路を壊さず、かつ問題をログから見逃さずに済みます。
解決したDOCKER_HOSTを後続ステップへ伝播する
起動処理がバックグラウンド、待機処理がフォアグラウンドと別プロセスの場合、環境変数は後続ステップへ自動では伝わりません。
GitHub Actionsでは $GITHUB_ENV への明示的な書き込みが必要です。
if (resultJson?.resolvedDockerHost && process.env.GITHUB_ENV) {
  await appendFile(
    process.env.GITHUB_ENV,
    `DOCKER_HOST=${resultJson.resolvedDockerHost}\n`,
    'utf8'
  ).catch((error) => {
    console.error(`failed to write ${process.env.GITHUB_ENV}: ${error.message}`)
  })
}
書き込みに失敗してもジョブ全体を落とさず、エラーログだけ残す形にしています。
DIにして分岐を単体テストする
env、probe、listContexts を引数で差し替えられる形にしておくと、実際のdocker daemonなしで分岐を検証できます。
healthy、fallback、all unreachableの3パターンを、次のようなスタブで確認できます。
import { test } from 'node:test'
import assert from 'node:assert/strict'

test('全contextが到達不能なら allUnreachable を返す', async () => {
  const result = await resolveDockerHost({
    env: {},
    listContexts: async () => [{ name: 'default' }, { name: 'orbstack' }],
    probe: async () => false,
  })
  assert.equal(result.allUnreachable, true)
  assert.equal(result.override, null)
})
つまづきやすいポイント
- context列挙の互換性:
docker context ls --format jsonは比較的新しいDocker CLIに依存します。未対応バージョンでは1行もparseできず、空配列になりえます。既存のコンテナ掃除ロジックとcontext列挙を共用すると、その場合に既存の対策まで無言で退行します。そのため、別関数に分離しました - タイムアウト予算の計算漏れ: 最大待機時間の計算に、追加したprobeの所要時間を足し忘れると、リトライで復旧する直前に「待機タイムアウト」で落ち、リトライが無駄になります
- 環境変数が伝播しない: 別プロセスで解決した値は、
$GITHUB_ENVに書かない限り後続ステップから見えません - probe失敗の扱い: 一時的な失敗を恒久的な失敗と取り違えないよう、全滅時は従来フローへのフォールバックにしておくのが安全です
まとめ
CLIツールが見ているcontextと、docker CLIのcurrent contextは一致するとは限りません。
1秒未満で決定的に失敗するエラーは、リトライ回数を増やすより、起動前のprobeで防ぐほうが本質的です。
全滅時はsilentにせず、警告を出して従来のリトライフローへ戻す設計にすると、安全に導入できます。
併せて、$GITHUB_ENV による環境変数の伝播と、タイムアウト予算へのprobe時間の加算も確認してください。