
はじめに
夜間バッチで本番URLの疎通確認をしてから、Lighthouse計測のような重い処理を走らせるCIジョブを運用しています。
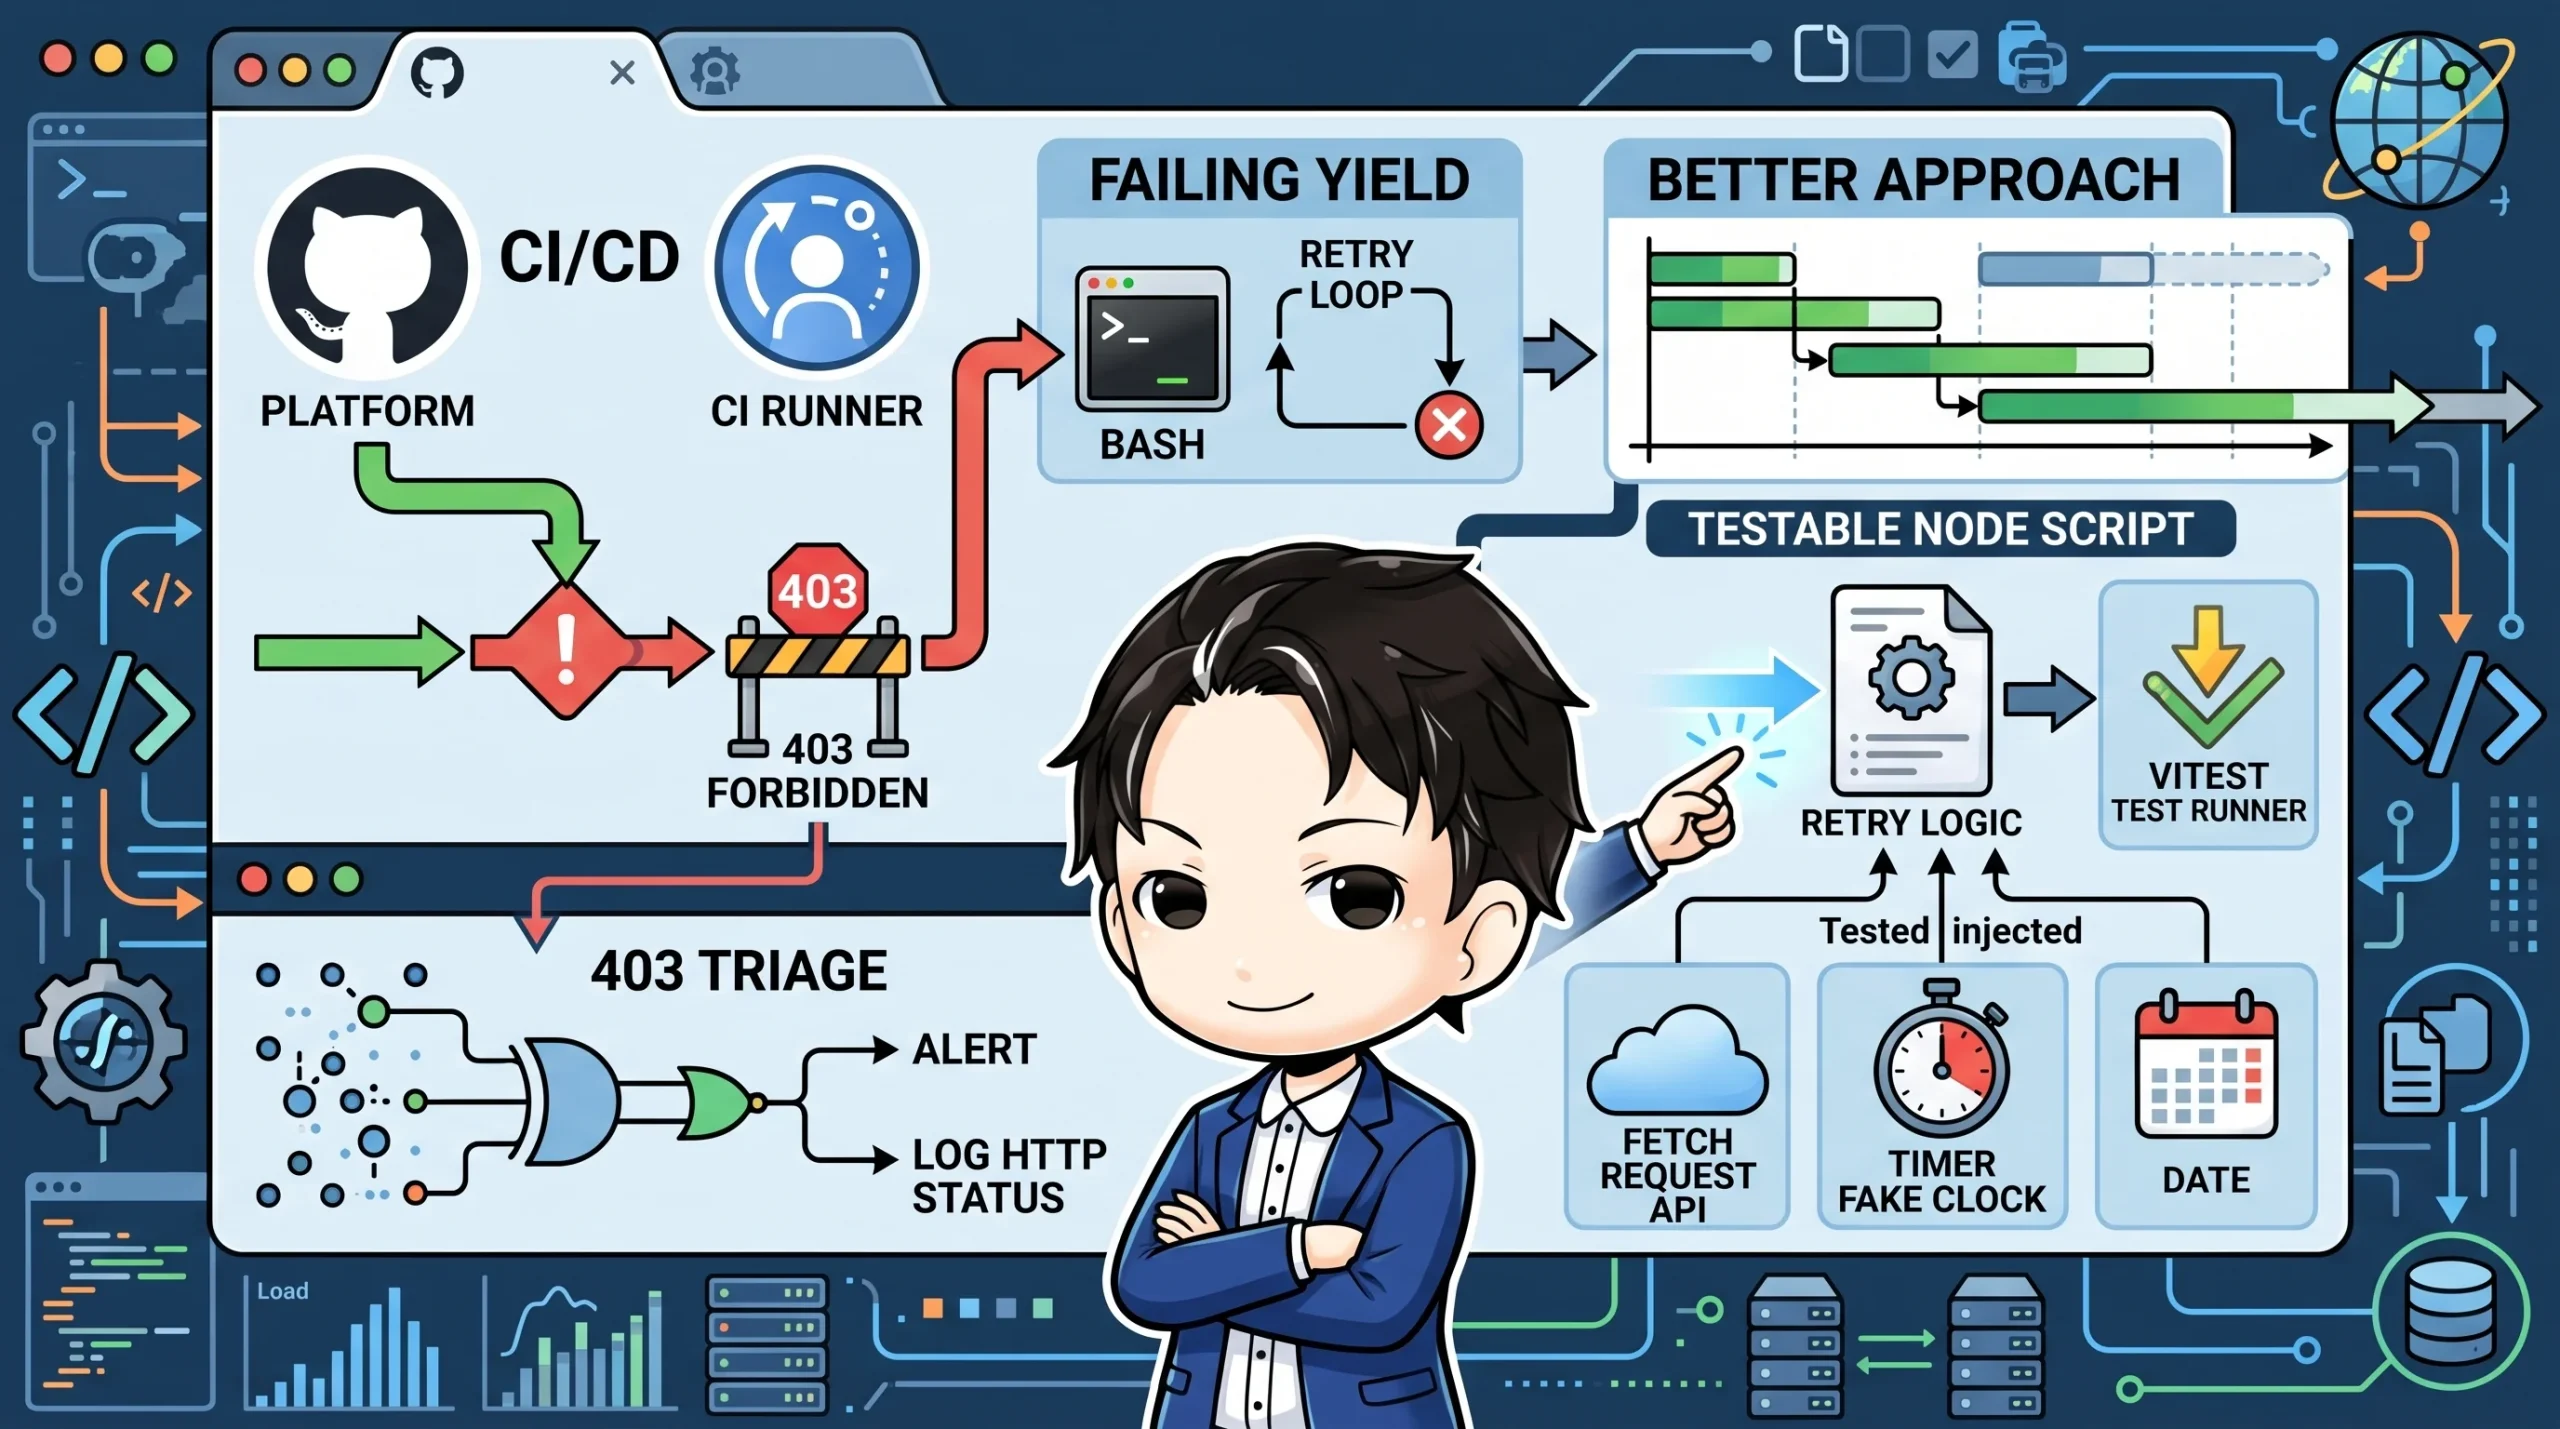
このジョブで「本番は健全なのに、CI runnerからのリクエストだけが断続的に403を返される」というflakeが起きました。
原因はCDNやWAFのBot対策がCI runnerのIPを一時的に弾いている可能性が高いと見ています。
ただし、その設定は手元ですぐには変更できません。
そこで「症状の緩和」と「根本原因の調査」を切り分け、まずはCI側のリトライ予算を広げる対応に絞りました。
あわせて、YAMLに直書きしていたbashのリトライループを、テストできるNode.jsスクリプトへ切り出しました。
この記事では、その手順と考え方を紹介します。
こんな人におすすめ
- CIの疎通確認が、本番に問題がないのに断続的に失敗して困っている方
- ワークフローYAMLにinline bashが増え、動作確認がCIを回すしかない状態の方
- リトライやタイムアウトのロジックを、実時間を待たずにテストしたい方
- 自分で直せない原因のflakeを、どう扱うか悩んでいる方
まず「障害」と「CI runnerだけブロック」を切り分ける
疎通確認が失敗したとき、最初に区別したいのは次の2つです。
- CIの外からもアクセスできない(本番の真の障害)
- CI runnerからだけアクセスできない(WAFやBot対策の可能性)
この区別がないと、無駄なアラートやIssueが量産されます。
今回は、最後に観測したHTTPステータスをジョブのoutputに残すようにしました。
後続のIssue自動起票ジョブは、このステータスを見て扱いを変えられます。
Before: YAMLに直書きしたリトライループ
もともとは、次のようなbashがYAMLの中に入っていました。
run: |
  set -uo pipefail
  STATUS="000"
  for attempt in $(seq 1 6); do
    STATUS=$(curl -sk -o /dev/null -w "%{http_code}" -L "$TARGET_URL" || echo "000")
    if [ "$STATUS" = "200" ]; then
      echo "reachable after ${attempt} attempts (HTTP 200)"
      echo "http_status=200" >> "$GITHUB_OUTPUT"
      exit 0
    fi
    echo "attempt ${attempt}/6: HTTP $STATUS — sleep 5s"
    sleep 5
  done
  echo "http_status=$STATUS" >> "$GITHUB_OUTPUT"
  exit 1
固定回数・固定sleepなので、リトライ予算は約30秒です。
予算を変えるにはYAMLを直接編集する必要があり、動作確認は実際にCIを回すしかありませんでした。
After: 依存を注入できるスクリプトに切り出す
ロジックを .mjs に移し、fetchImpl / delayImpl / now を引数で差し替えられるようにしました。
export async function waitForReachable({
  url,
  fetchImpl = fetch,
  timeoutMs = DEFAULT_TIMEOUT_MS,
  intervalMs = DEFAULT_INTERVAL_MS,
  delayImpl = delay,
  now = Date.now,
  onAttempt,
} = {}) {
  const deadline = now() + timeoutMs
  let attempt = 0
  let lastStatus = '000'

  while (true) {
    attempt += 1
    lastStatus = await probeStatus({ url, fetchImpl })
    onAttempt?.({ attempt, status: lastStatus })

    if (lastStatus === '200') {
      return { ok: true, status: lastStatus, attempts: attempt }
    }
    if (now() >= deadline) {
      return { ok: false, status: lastStatus, attempts: attempt }
    }
    await delayImpl(intervalMs)
  }
}
回数ではなく「締め切り時刻」で打ち切る形にしたので、予算は timeoutMs の数値だけで調整できます。
今回は30秒から約3分に広げました。
YAML側は次の1行になります。
run: node scripts/wait-for-reachable.mjs
fake clockで3分待ちを一瞬でテストする
実際に sleep するテストは遅く、不安定になりがちです。
now と delayImpl を差し替え、仮想的に時間を進めます。
function makeFakeClock() {
  let current = 0
  const now = () => current
  const delayImpl = vi.fn(async (ms) => { current += ms })
  return { now, delayImpl }
}

it('timeoutまで失敗が続いたら最後に観測したstatusでok:falseを返す', async () => {
  const fetchImpl = vi.fn().mockResolvedValue({ status: 403 })
  const { now, delayImpl } = makeFakeClock()

  const result = await waitForReachable({
    url: TEST_URL, fetchImpl, now, delayImpl,
    timeoutMs: 20_000, intervalMs: 5_000,
  })

  expect(result.ok).toBe(false)
  expect(result.status).toBe('403')
})
実時間を1秒も使わずに、タイムアウト到達時の挙動を検証できます。
成功までに何回失敗したか、といったケースも同じ要領で書けます。
ジョブ全体のtimeoutと、runbookも一緒に直す
リトライ予算だけを延ばしても、ジョブ自体のtimeoutが据え置きだと問題が残ります。
依存関係のインストールや計測本体と合算したとき、tail caseでジョブごと打ち切られるおそれがあるためです。
今回はジョブのtimeoutも15分から20分へ合わせて広げました。
もう一つ、既知のflakeはrunbookに構造化して残しておくと役立ちます。
次のような項目を書いておくと、次に遭遇した人が再現確認から始めずに済みます。
- どのくらいの頻度で起きるか
- どのくらいの時間で収まるか
- どう見分けるか
- 暫定対策は何か
つまづきやすいポイント
- 症状緩和のリトライは、原因が別にあることを隠しやすいです。根本原因の調査は別Issueとして切り離し、リトライ拡張を「恒久対策」と誤解されないようにしておくと安全です
- 404のような恒久的なエラーまでリトライすると、無駄に待ち続けます。リトライ対象にするステータスは意図して決めてください
- リトライ予算とジョブtimeoutは連動させて見直してください。片方だけ変えると、別の箇所で打ち切られます
- fake clockを使うテストでは、
nowとdelayImplの両方を差し替えないと、実時間が混ざってflakyなテストになります
まとめ
CIだけが403を受ける問題は、本番障害とは別物として切り分けると見通しが良くなります。
直せない根本原因は無理に追わず、リトライ予算の拡張という小さなスコープで先にマージする判断も有効です。
inline bashは、依存を注入できるスクリプトに切り出すとfake clockでテストでき、予算の調整もしやすくなります。
ジョブのtimeoutやrunbookまで一緒に整えておくと、次に同じ現象が起きたときの対応が軽くなります。