
はじめに
セルフホストのWoodpecker CIを運用していると、「特定のリポジトリだけ、pushしてもpipelineが生成されない」という症状に出会うことがあります。
webhookの受信ログは200や204で成功しているため、ぱっと見では異常がありません。
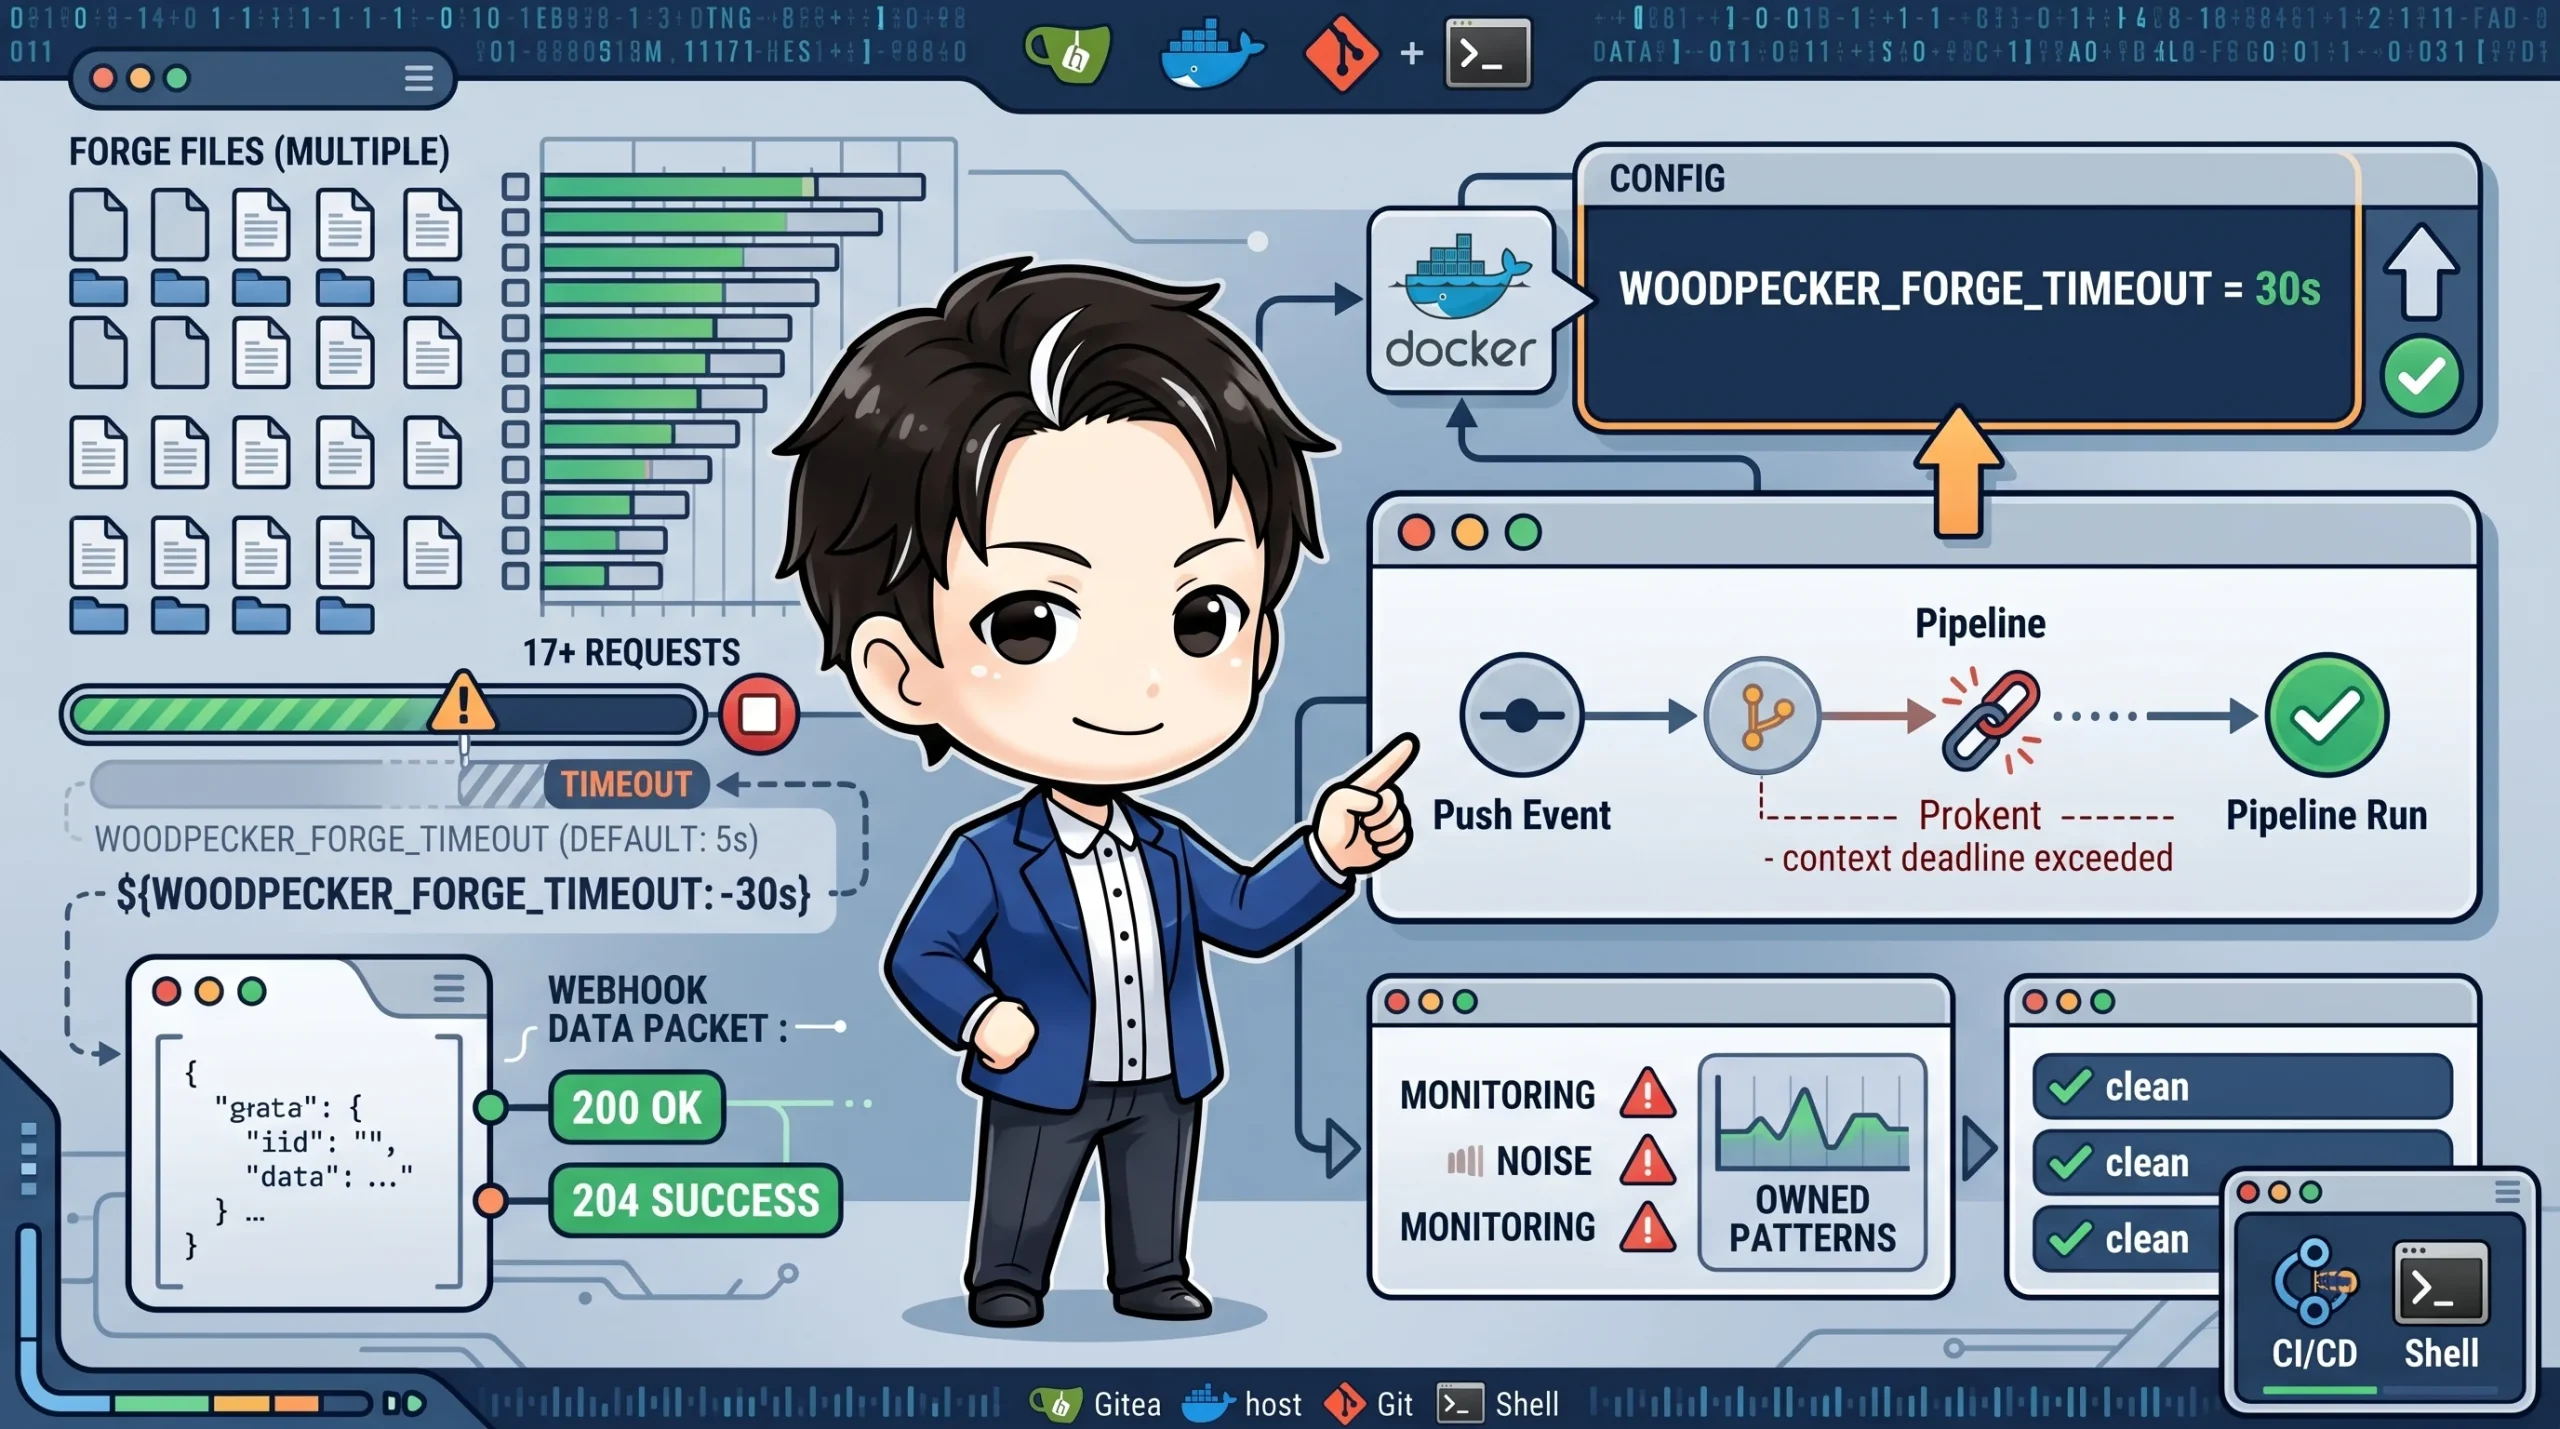
私が遭遇したケースでは、原因は WOODPECKER_FORGE_TIMEOUT のデフォルト値(5秒)でした。
この記事では、症状の見分け方と1行の修正、そして復旧のついでに見直した監視スクリプトの設計を紹介します。
こんな人におすすめ
- Woodpecker CIをセルフホストで運用している方
- webhookは成功しているのにpipelineだけ作られず、原因を追えていない方
.woodpecker/配下の設定ファイルを分割して管理している方- CIホストの監視スクリプトがWARNだらけで、本当の異常が埋もれている方
原因: 設定ファイルの取得はファイル数に比例して遅くなる
Woodpecker CIは、リポジトリの .woodpecker/ 配下にある設定ファイルをforge(GitHubなど)のAPIで取得します。
このとき、ファイルは逐次取得されます。
今回のリポジトリでは、設定ファイルが17個ありました。
ディレクトリ一覧の取得なども含めると約18リクエストで、合計およそ5.4秒かかっていました。
デフォルトのタイムアウトは5秒なので、わずかに超えてしまい、サーバーログに次のエラーが出ます。
context deadline exceeded
webhook自体は受け取れているので、UI上は「何も起きない」ように見えます。
ログを見ないと気づけない、典型的な「見えない失敗」です。
ファイルを分割する設計は読みやすさの面では有利ですが、forge APIのリクエスト数が線形に増えるという副作用があります。
分割を進めるほど、このタイムアウトに近づく点は意識しておくとよいです。
修正: タイムアウトを環境変数で上書きできる形にする
修正は docker-compose.yml の1行です。
直値を書かず、${VAR:-default} の形にしておくと、.env でホストごとに調整できます。
services:
  woodpecker-server:
    environment:
      - WOODPECKER_FORGE_TIMEOUT=${WOODPECKER_FORGE_TIMEOUT:-30s}
さらに余裕が必要なホストでは、.env に次のように書くだけで上書きできます。
WOODPECKER_FORGE_TIMEOUT=60s
なお、WOODPECKER_FORGE_RETRY(デフォルト3)は変更しませんでした。
リトライ回数を増やすと失敗時の待ち時間が膨らむため、延ばすのはタイムアウトだけにしました。
変更後はサーバーのコンテナを再作成して、環境変数が反映されたか確認します。
docker compose up -d woodpecker-server
docker compose exec woodpecker-server env | grep WOODPECKER_FORGE
復旧のついでに見直した監視スクリプト
インシデント対応中に、ホスト監視スクリプトのノイズが調査の邪魔になりました。
常に warnings>=1 の状態で、本物の異常が埋もれていたのです。
そこで3点を見直しました。
自分が所有するものだけをWARNにする
他チームが管轄している壊れたLaunchAgentまで毎回WARNにしていたのが、ノイズの主因でした。
所有パターンを正規表現で定義し、所有外のものはINFOに格下げしています。
OWNED_LA_RE="${HOST_HEALTH_OWNED_LAUNCHAGENT_RE:-com\.example\.ci-runner|com\.example\.ci-station}"

BROKEN_ALL=$(launchctl list 2>/dev/null \
  | awk 'NR>1 && $2 ~ /^[0-9]+$/ && $2 != 0 {print $3"(status="$2")"}')
BROKEN_OWNED=$(printf '%s\n' "$BROKEN_ALL" | grep -E "$OWNED_LA_RE" | tr '\n' ' ')
BROKEN_FOREIGN=$(printf '%s\n' "$BROKEN_ALL" | grep -vE "$OWNED_LA_RE" | tr '\n' ' ')
BROKEN_OWNED だけをWARNにし、BROKEN_FOREIGN はINFOで列挙します。
責任を持てないものはWARNにしないが、可視性は残すという線引きです。
パターンを環境変数で上書きできるので、構成が変わっても再デプロイは不要です。
プロセス分類の評価順を固定する
高CPUのプロセスを検出するとき、ChromeのrendererのようなCIと無関係なものが汎用のrunaway警告に紛れていました。
対策として、評価順を「除外リスト → 特化カテゴリ → 汎用」に固定し、各カテゴリでは continue して下位に落とさないようにしました。
機械可読な行を別に出力する
incidentの重複判定に使う署名を、人間向けのWARN文言からgrepで抜き出していました。
文言を直すたびに署名が壊れる、脆い結合です。
そこで orphan-root-pids: 5309,7001 のような機械可読な行を別に出力し、重複判定はその行だけを読むようにしました。
人間向けのメッセージを自由に改善できるようになります。
実測で分かったDocker volumeの主犯
ディスクを圧迫するvolumeの主因は、PR番号付きのCIスタックだと考えていました。
ところが実測すると、191本中168本がdangling volumeで、その大半は @wordpress/env が作る4種類のvolume(mysql、mysql-test、user-home、tests-user-home)でした。
CI終了後に wp-env destroy を実行しておらず、leakしていたのです。
あわせて、古いCIスタックを回収するreaperが docker ps(稼働中のみ)を見ていたことも判明しました。
teardown漏れで exited のまま残ったスタックは、7日後のpruneまで放置されていました。
そこで、停止中のコンテナを含めるかどうかを引数で切り替えられるようにしました。
list_stale_ci_stacks() {
  local age_thresh="${1:-43200}" include_exited="${2:-0}" ps_flag
  if [ "$include_exited" = "1" ]; then ps_flag="-a"; else ps_flag=""; fi
  # ps_flag は空か -a のみ。意図的に word-split する
  # shellcheck disable=SC2086
  docker ps $ps_flag --format '{{.Label "com.docker.compose.project"}} {{.CreatedAt}}'
}
監視側は引数なしで稼働中のみを対象にし(exitedをWARNにするとノイズになるため)、削除側は include_exited=1 で12時間を超えたものを回収します。
判定ロジックを共有しつつ、目的に応じて引数だけ変える形です。
つまづきやすいポイント
- webhookの成功ログだけで安心しない: 受信が成功してもpipeline生成に失敗することがあります。サーバーログの
context deadline exceededを確認してください。 - 環境変数の反映漏れ: composeファイルを編集しても、コンテナを再作成しないと反映されません。
envで実際の値を確認するのが確実です。 - タイムアウトは対症療法: 設定ファイルがさらに増えれば再発します。ファイルの統合や、このエラーの監視を併せて検討してください。
- 原因の仮説を数値で検証する: volumeの主因は想定と違いました。対策の前に、まず件数と内訳を測るのが近道です。
まとめ
特定リポジトリだけpipelineが生成されない場合は、.woodpecker/ のファイル数とforge timeoutの関係を疑ってみてください。
修正は WOODPECKER_FORGE_TIMEOUT=${WOODPECKER_FORGE_TIMEOUT:-30s} の1行で済みます。
あわせて、監視はWARNの対象を自分が所有するものに絞ると、次の異常に気づきやすくなります。
根本対策としては、設定ファイルの統合とCI側のteardown整備が次の課題です。