
はじめに
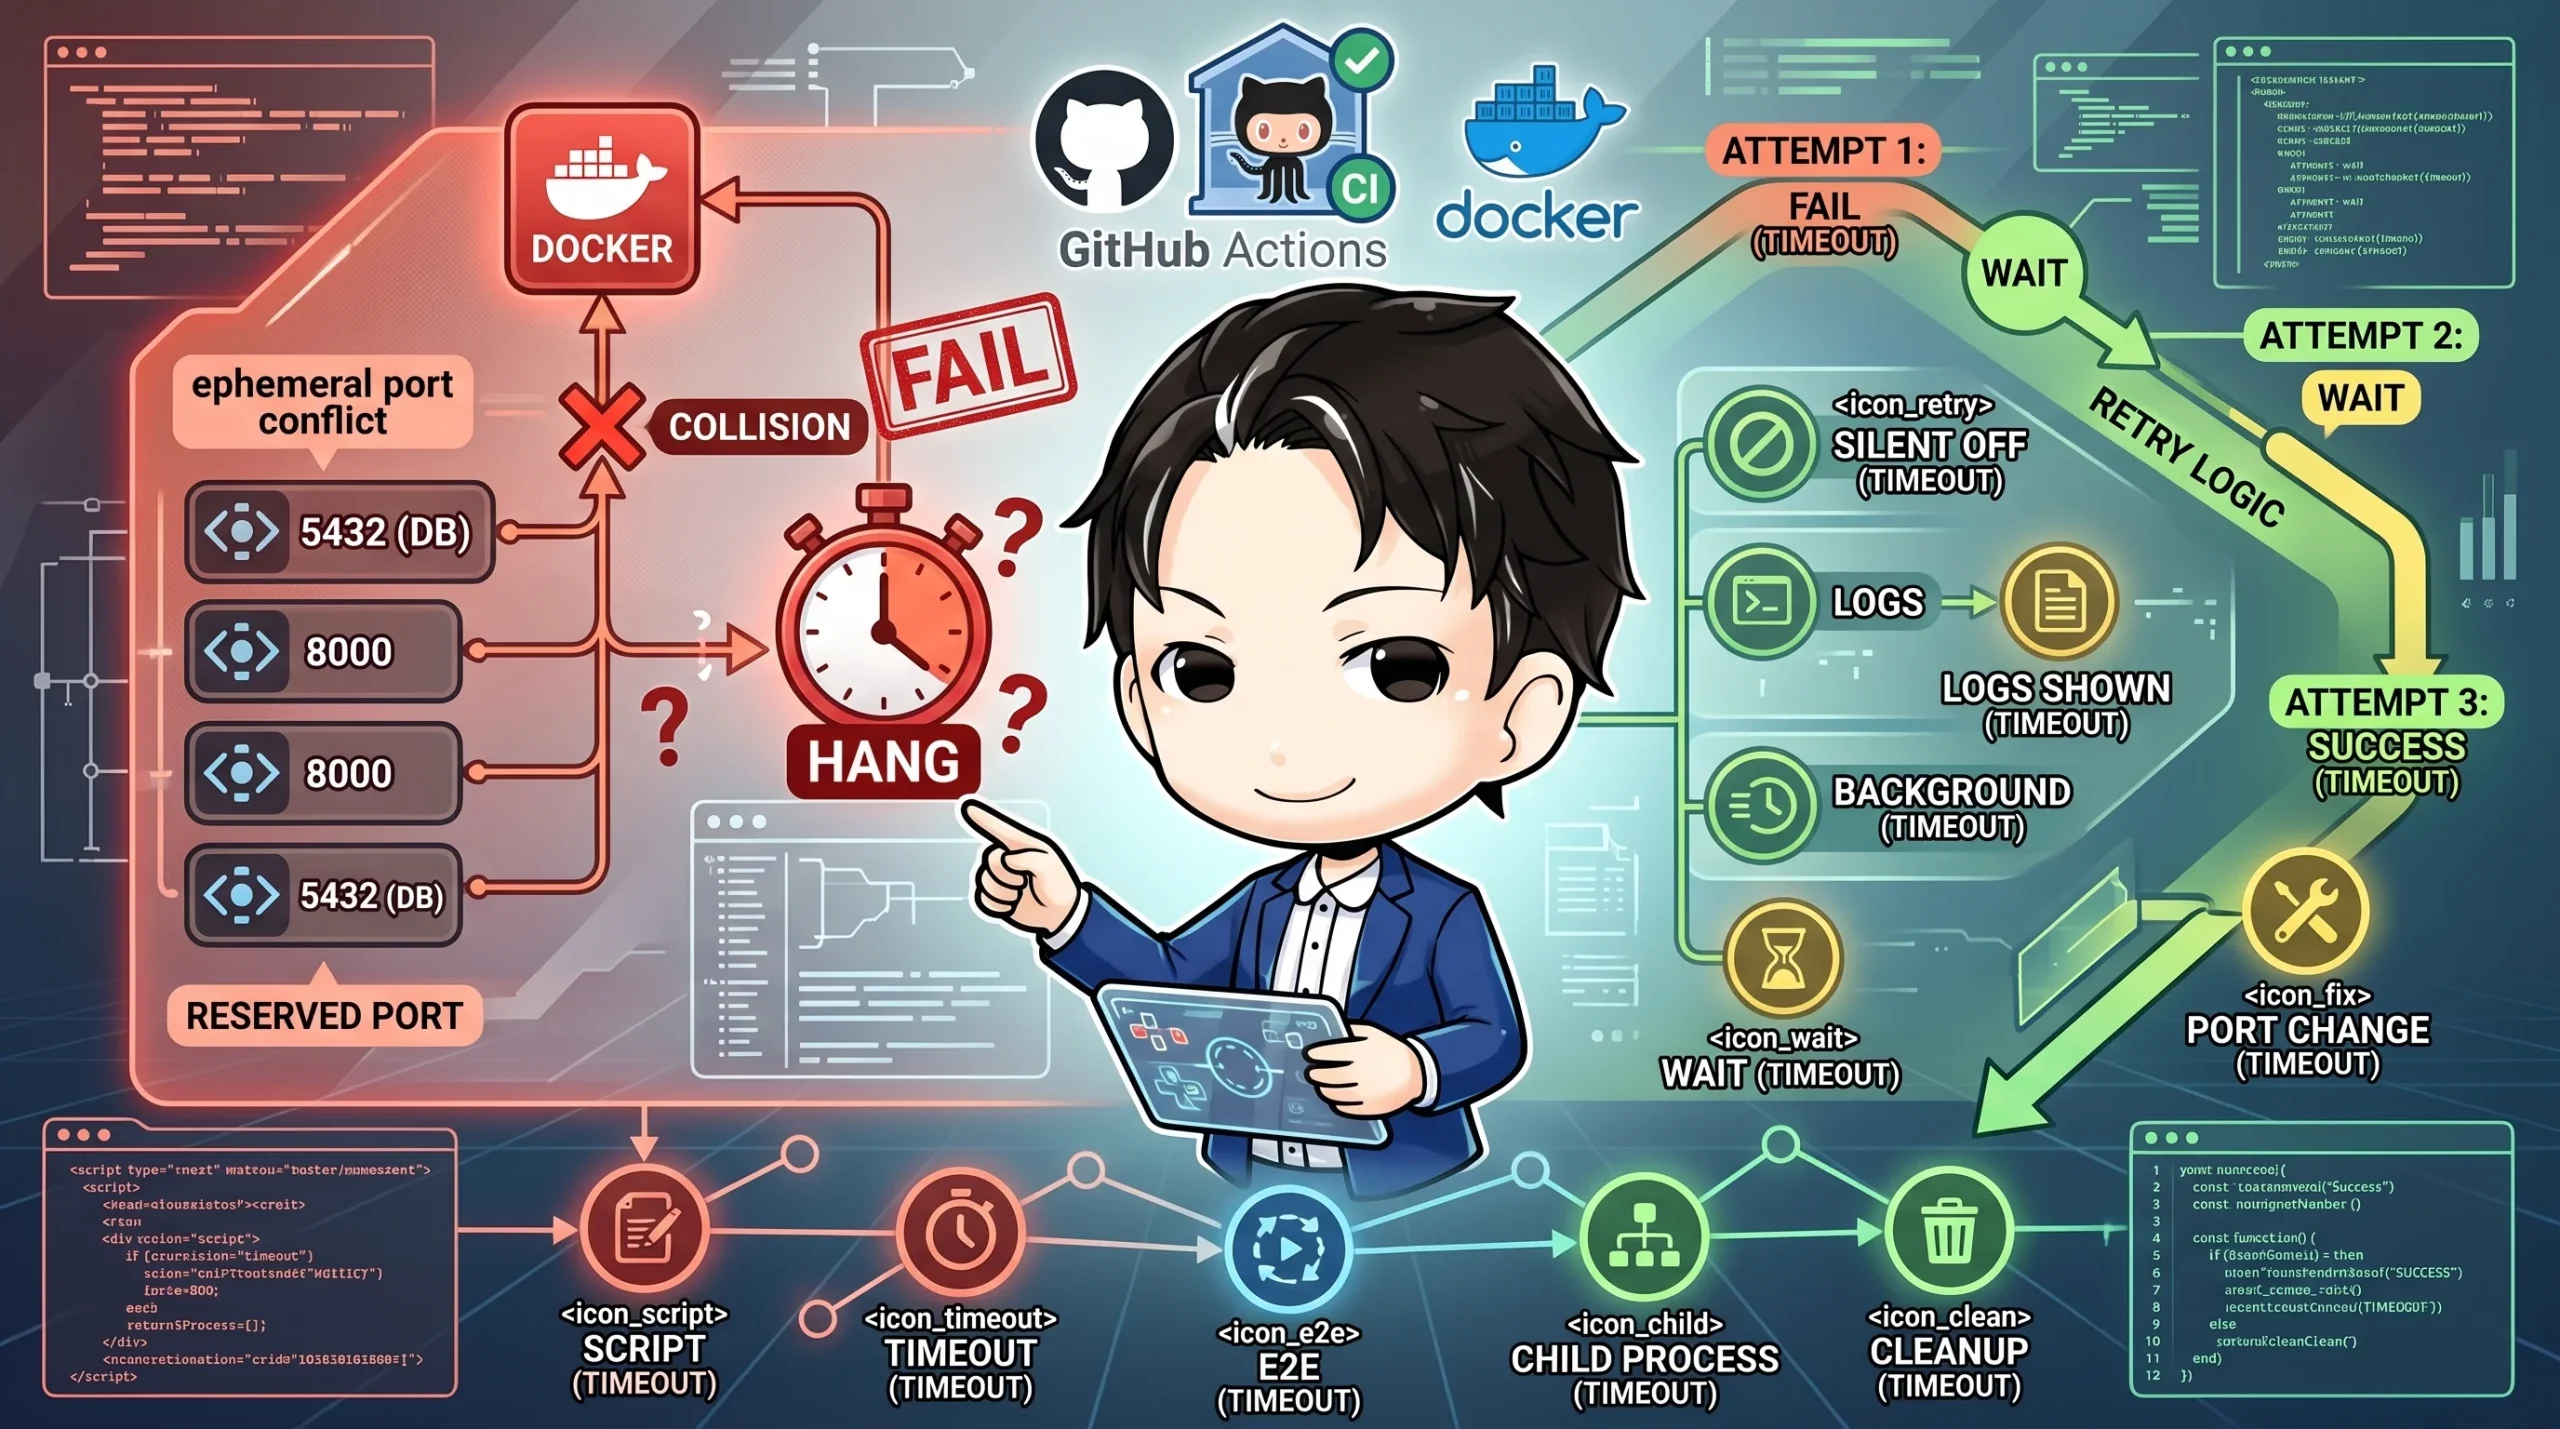
CI でローカル DB(Docker ベースのバックエンドスタック)を起動すると、ごくまれに「ポートが既に使用されています」というエラーで落ちることがあります。
さらに厄介なのは、エラーにすらならず、起動プロセスがそのままハングするケースです。
再実行すれば通るので放置されがちですが、原因を辿ると設定したポート番号が Linux の ephemeral port レンジと重なっていました。
この記事では、原因の整理と、非ゼロ終了とハングの両方を拾うリトライスクリプトの設計、そして実装時にハマりやすい点をコード付きで紹介します。
こんな人におすすめ
- CI でたまにだけ起動に失敗する Docker 系ステップに悩んでいる方
- 「再実行すると通る」flaky な失敗を、握りつぶさずに緩和したい方
- 複数の workflow に散らばった shell スクリプトを composite action にまとめたい方
- Node.js で子プロセスのタイムアウトと後始末を正しく書きたい方
原因は ephemeral port との衝突
Linux では、アウトバウンド通信の送信元ポートとして OS が自動的に割り当てる範囲があります。
これが ephemeral port レンジで、目安として 32768〜60999 あたりです(/proc/sys/net/ipv4/ip_local_port_range で確認できます)。
cat /proc/sys/net/ipv4/ip_local_port_range
# 32768	60999
設定ファイルで指定したポートがこの範囲に入っていると、次のような競合が起こり得ます。
- Docker がポートを bind しようとする
- その直前に、同じマシン上の別プロセス(
docker pullやnpm installなど)が、たまたま同じ番号を一時ポートとして使う - bind が失敗する
発生はタイミング次第なので、再現性が低く、まれにしか起きません。
恒久対策は「ポート番号を範囲の外へ振り直す」ことですが、ローカル開発環境の設定にも波及します。
そこでまず、リトライによる緩和策を入れました。
非ゼロ終了とハングを両方拾うリトライ
ポイントは、失敗を 2 種類に分けて扱うことです。
bind 競合は、必ずしもプロセスを異常終了させません。CLI が応答不能になることもあります。
そのため、spawn したプロセスに試行ごとのタイムアウトを設け、タイムアウト自体も失敗として扱います。
function spawnWithTimeout(command, args, { timeoutMs, stdio }) {
  return new Promise((resolve) => {
    const startedAt = Date.now()
    let child
    try {
      // detached: true でプロセスグループを分け、タイムアウト時に
      // 起動したサブプロセスごと畳めるようにする。
      child = spawn(command, args, { stdio, cwd: repoRoot, detached: true })
    } catch (error) {
      resolve({ outcome: 'failed', exitCode: 1, durationMs: Date.now() - startedAt })
      return
    }

    const killGroup = (signal) => {
      try {
        process.kill(-child.pid, signal)
      } catch {
        child.kill(signal)
      }
    }

    let timedOut = false
    const timer = setTimeout(() => {
      timedOut = true
      killGroup('SIGTERM')
      setTimeout(() => killGroup('SIGKILL'), 10_000)
    }, timeoutMs)

    child.on('close', (code) => {
      clearTimeout(timer)
      resolve(timedOut
        ? { outcome: 'timeout', exitCode: null, durationMs: Date.now() - startedAt }
        : { outcome: code === 0 ? 'success' : 'failed', exitCode: code ?? 1, durationMs: Date.now() - startedAt })
    })
  })
}
後始末は SIGTERM から始め、一定時間後も残っていれば SIGKILL を送る二段階にしています。
Docker CLI のように子プロセスをさらに起動する場合があるため、process.kill(-pid) でプロセスグループ単位に kill します。
バックグラウンド起動と完了待ちを分ける
起動に時間がかかるため、起動(バックグラウンド)と完了待ちを別 step に分けました。
workflow 側は composite action の呼び出しに置き換えています。
- name: Start local Supabase (background)
  uses: ./.github/actions/start-supabase-background
  with:
    args: --ignore-health-check -x studio

- name: Wait for Supabase to be ready
  run: node scripts/supabase-start-with-retry.mjs wait
これで、複数の workflow にコピーされていたインライン shell が 1 か所に集約され、実装の二重化が解消されます。
同じ理由で、事前クリーンアップとリトライ内の掃除も、ラベルフィルタで対象コンテナを絞る処理を共有しました。
別プロセス間の受け渡しには sentinel file(終了コードを書くファイル)を使います。ここに落とし穴があります。
export async function readExitCodeFile(exitPath, readText) {
  const raw = await readText(exitPath).catch(() => null)
  if (raw === null || raw.trim() === '') return null // まだ完了していない
  const parsed = Number(raw.trim())
  return Number.isFinite(parsed) ? parsed : 1
}
echo $? > file は、ファイル作成から書き込みまでの間に一瞬だけ空になり得ます。
Number('') は 0 なので、素朴に読むと「起動成功」と誤認します。空文字や空白のみは「未完了」として明示的に弾く必要があります。
リトライを silent にしない
リトライで自動復旧すると、同じ問題が積み重なっていても誰も気づけません。
CI の Job Summary と ::warning:: annotation に、何回目の試行で、どんな失敗で、どれだけ待って復旧したかを記録します。
echo "::warning::supabase start recovered on attempt 2 (timeout after 180s)"
こうしておけば後から頻度を追え、恒久対策に着手する判断材料になります。
つまづきやすいポイント
- 待ち側のタイムアウトが短すぎる: 起動側の「タイムアウト+強制終了の猶予+リトライごとの後片付け」の最悪時間より短いと、復旧する直前に待ち側が諦めます。待ち時間は数式で算出し、単体テストで固定すると安全です。
- 設定値が呼び出し元でズレる: 起動側と待ち側が別プロセスで同じ環境変数を参照する場合、片方にだけ値を置くと待ち時間がドリフトします。デフォルト値はリトライ処理側に固定し、呼び出し元での上書きを禁止する運用が有効です。
- プロセス単体だけ kill する: 子プロセスが残ってポートを掴み続けると、次の試行も失敗します。プロセスグループ単位で kill してください。
- ハングを失敗として数えない: 終了コードだけを見ていると、ハングは永遠に待ち続けます。
まとめ
CI のポート競合は、設定値が ephemeral port レンジと重なることで、まれに起きます。
緩和策として、非ゼロ終了とハングの両方を失敗として扱い、プロセスグループごと後始末するリトライが有効です。
sentinel file の空文字や待ち時間の計算といった境界条件を押さえ、リトライの発生は必ず記録に残してください。
恒久対策(ポート番号の振り直し)は、記録した頻度を見ながら判断するのが現実的です。