
はじめに
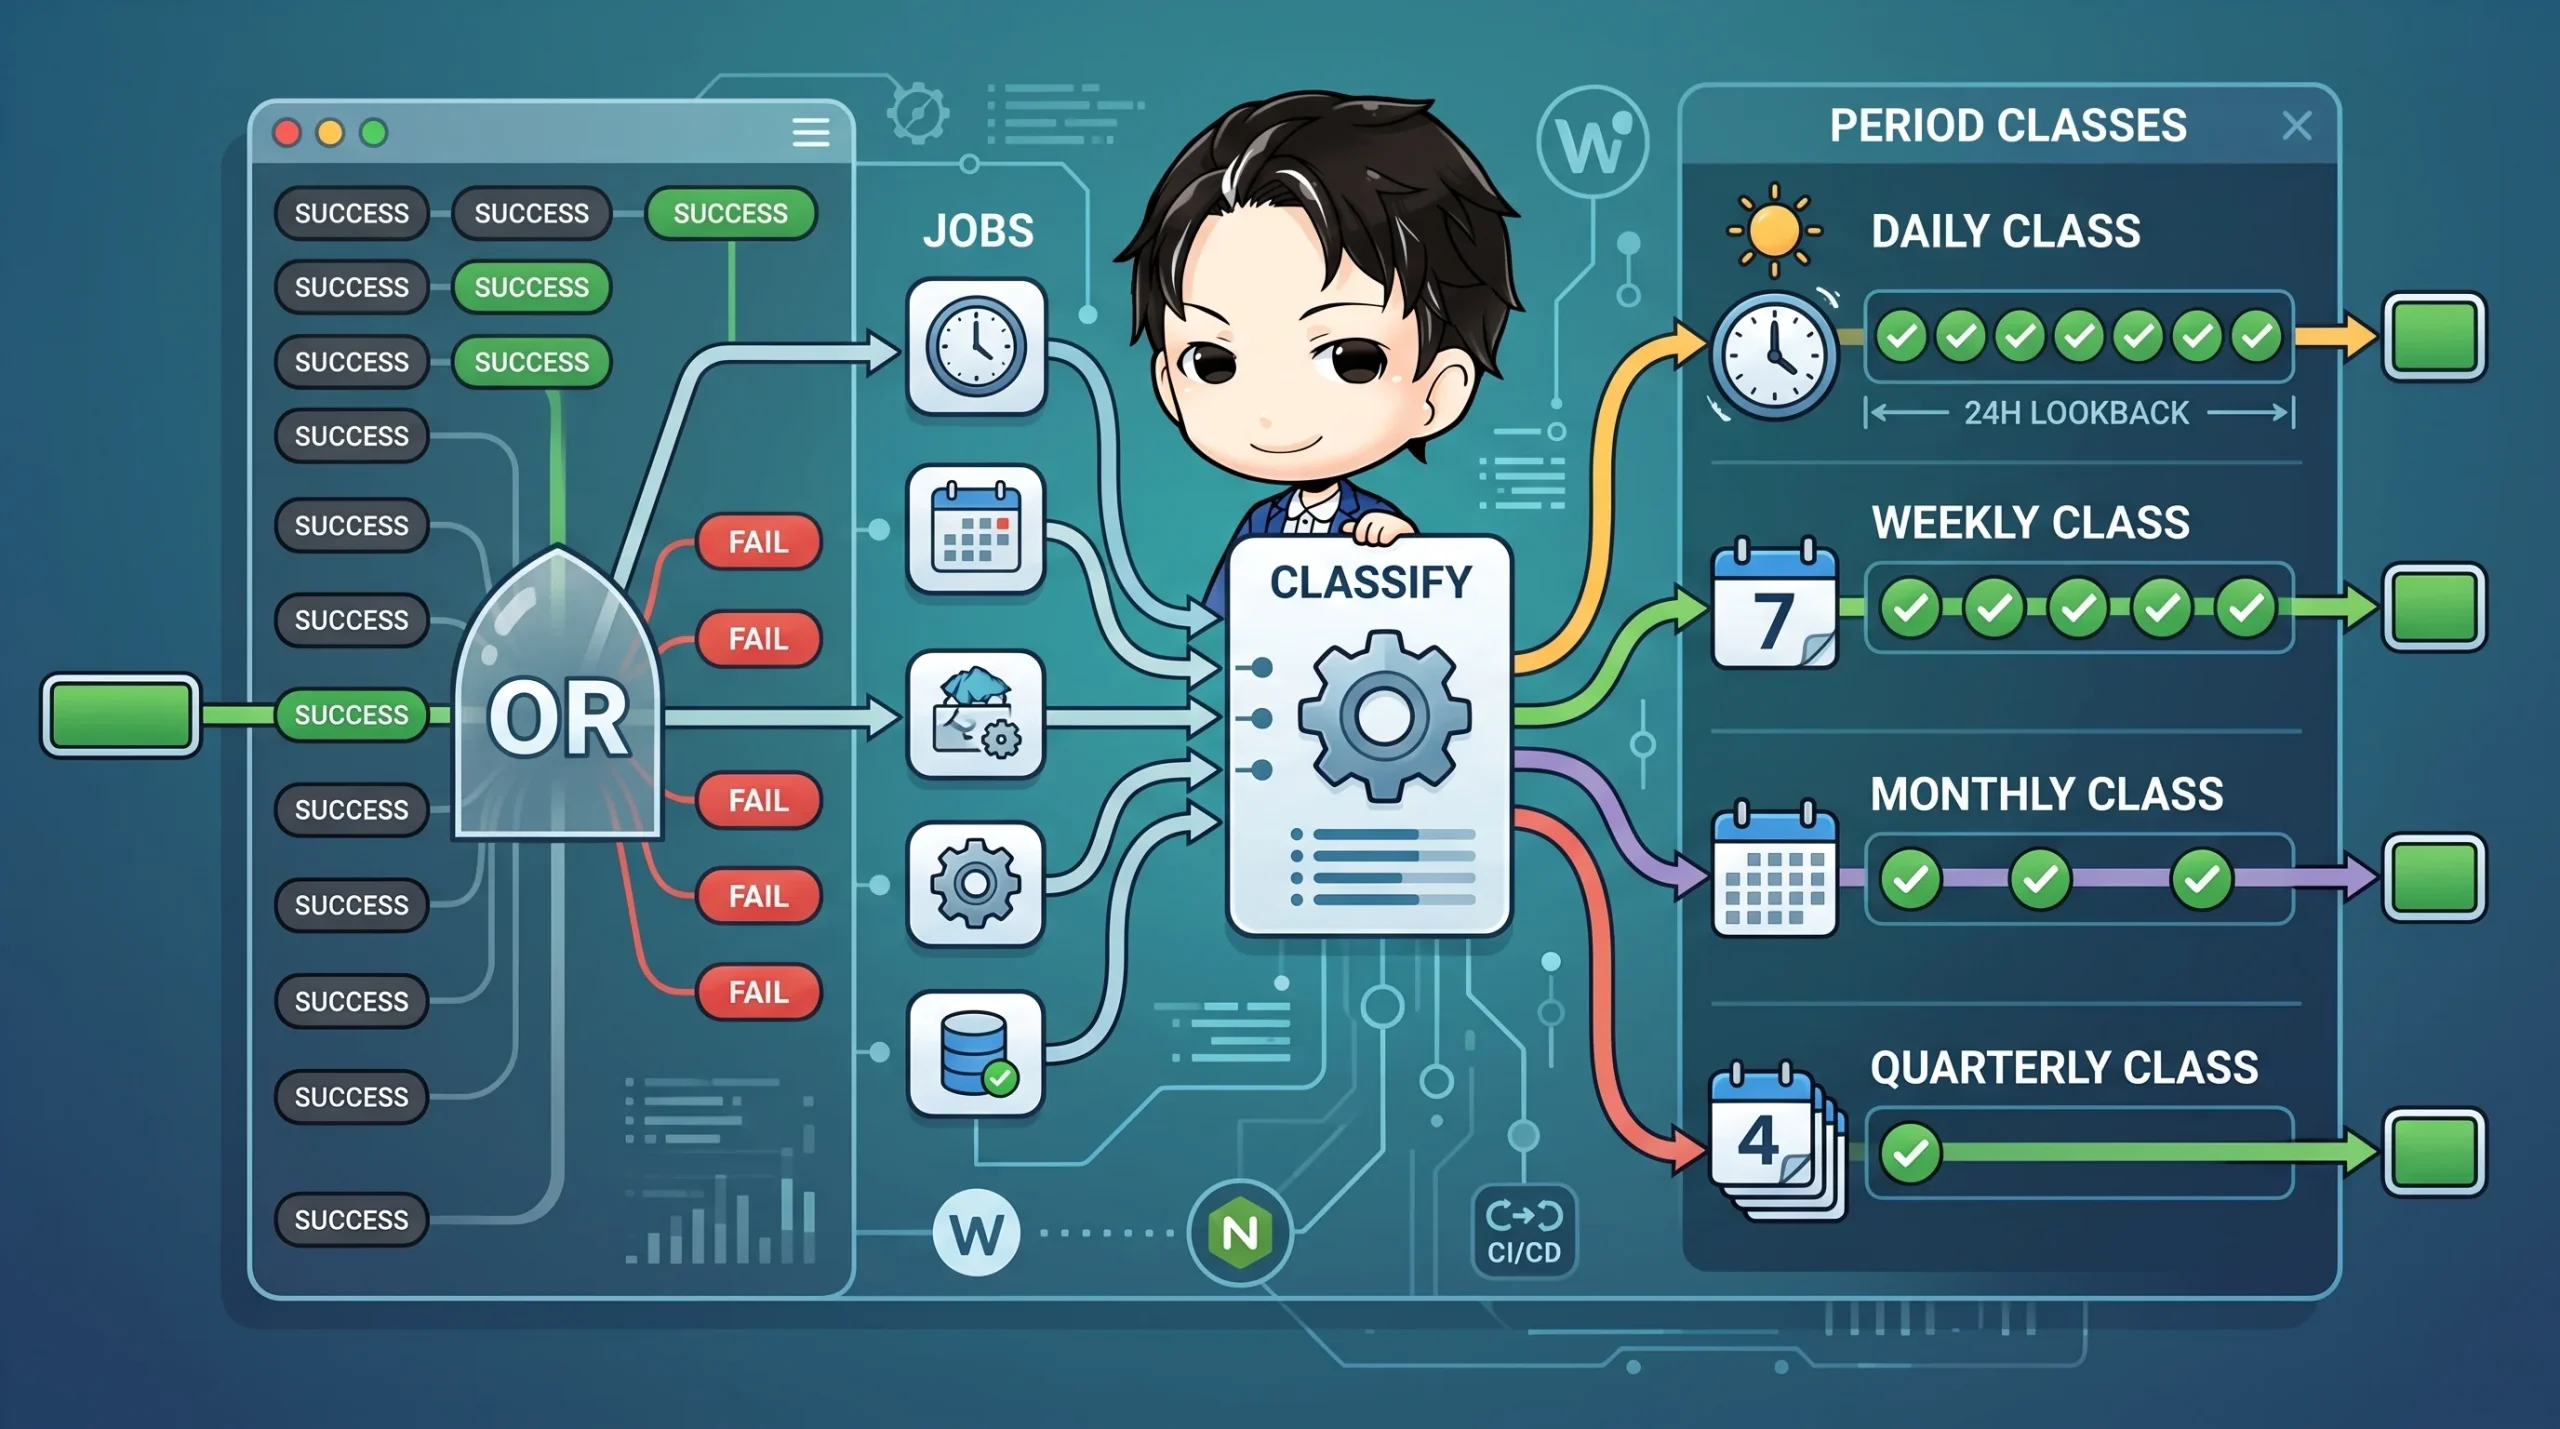
定期ジョブの監視を「直近24時間に1件でも成功していれば green」という条件で組んでいませんか。
実装は簡単ですが、10本のジョブのうち9本が止まっていても、1本が動いていれば監視は green のままです。
さらに、週次・月次・四半期のジョブは「24時間以内に成功記録がないのが正常」なので、そもそもこの方式では監視対象に入れられません。
この記事では、cron の実行スケジュールから周期クラス(daily / weekly / monthly / quarterly)を自動推定し、ジョブごとに適切な期間で最終成功を評価する per-cron ヘルスチェックの設計を紹介します。
実運用しているCIの定期ジョブ監視を作り直した経験から、判定ロジックを純粋関数に切り出す方法と、失敗の原因分類まで整理します。
こんな人におすすめ
- CI(Woodpecker CI や GitHub Actions など)で複数の定期ジョブを動かしている方
- 「監視が常に green で、壊れていても気づけない」状態に不安がある方
- 週次・月次など長周期のジョブも同じ仕組みで監視したい方
- 監視アラートを受けたとき、何から手を付けるか迷いがちな方
OR 判定が見逃すもの
OR 判定は、最初は合理的に見えます。
ジョブが1本しかなければ、それで十分に機能するからです。
ところがジョブが増えると、個々の失敗が隠れます。
見かけ上は常に green になり、監視として機能しなくなります。
定期ジョブの監視は、AND 条件(全件を個別に評価)が原則です。
AND 条件にするとき、課題になるのが「ジョブごとに正常な間隔が違う」ことです。
そこで、cron 式から周期を推定します。
cron 式から周期クラスを推定する
5フィールドの cron 式のうち、日(dom)・月(month)・曜日(dow)が * かどうかだけを見れば、大まかな周期は分類できます。
// cron 表現の 5 フィールドから dom/month/dow を見て周期クラスを分類
export function classifyCronInterval(schedule) {
  const fields = String(schedule).trim().split(/\s+/)
  if (fields.length !== 5) throw new Error(`malformed cron schedule: "${schedule}"`)
  const [, , dom, month, dow] = fields
  const domRestricted = dom !== '*' && dom !== '?'
  const monthRestricted = month !== '*' && month !== '?'
  const dowRestricted = dow !== '*' && dow !== '?'
  if (domRestricted) return monthRestricted ? 'quarterly' : 'monthly'
  if (dowRestricted) return 'weekly'
  return 'daily'
}
日が指定されていれば月次以上、さらに月も指定されていれば四半期、曜日だけが指定されていれば週次、という階層で判定します。
外部ライブラリに依存せず、文字列の解析だけで済むのが利点です。
周期クラスごとに「どれくらい遡って成功を探すか」(lookback)を決めます。
私の環境で使っている値は次のとおりです。
| 周期クラス | lookback |
|---|---|
| daily | 26時間 |
| weekly | 8日 |
| monthly | 33日 |
| quarterly | 94日 |
daily が24時間ちょうどではなく26時間なのは、2時間の猶予(grace)を持たせているためです。
ヘルスチェック自身が固定時刻に走ると、ジョブの実行時刻のわずかなずれで誤検知(false positive)が出やすくなります。
猶予はその対策です。
ジョブごとの評価を純粋関数にする
判定ロジックは、API 呼び出しを含まない純粋関数にします。
入力は「監視対象ジョブの一覧」「パイプラインの実行履歴」「現在時刻」だけです。
export function evaluateCronHealth(ledgerCrons, pipelines, nowEpoch, { lookbackTable = DEFAULT_LOOKBACK_HOURS } = {}) {
  const byCron = []
  const counts = { ok: 0, failing: 0, unregistered: 0 }

  for (const cron of ledgerCrons) {
    const interval = classifyCronInterval(cron.schedule)
    const lookbackHours = lookbackHoursFor(interval, lookbackTable)
    const cutoff = nowEpoch - lookbackHours * 3600

    const forCron = pipelines.filter((p) => p.cron === cron.name)
    let lastSuccessEpoch = null
    for (const p of forCron) {
      if (p.status !== 'success') continue
      const epoch = pipelineFinishedEpoch(p)
      if (lastSuccessEpoch == null || epoch > lastSuccessEpoch) lastSuccessEpoch = epoch
    }

    const state = lastSuccessEpoch != null && lastSuccessEpoch >= cutoff
      ? 'ok'
      : forCron.length === 0 ? 'unregistered' : 'failing'
    counts[state] += 1
    byCron.push({ name: cron.name, interval, lookbackHours, state })
  }

  return { ok: counts.failing === 0 && counts.unregistered === 0, counts, byCron }
}
ポイントは2つあります。
1つ目は、状態を2種類に分けていることです。
unregistered は一度も発火していないジョブ、failing は発火はしているが最近の成功がないジョブです。
同じ「不健全」でも、取るべき対応がまったく違います。
2つ目は、時刻を引数で受け取っていることです。
現在時刻を関数の外から渡せるので、「31日前に成功したmonthlyジョブ」のような境界ケースをユニットテストで再現できます。
私の場合、この関数群に対して34件のテストを書き、CI で回しています。
原因を分類して初動を即決できるようにする
「失敗した」とだけ通知されても、担当者は何を確認すべきか迷います。
そこで、原因を次のように分けて通知します。
missing_secrets:認証情報が未設定unregistered:ジョブ自体が未登録failing:実行が壊れているapi_error:監視側の API が異常
複数の原因が重なる場合は優先順位を付けます。
export function summarizeHealth(result) {
  const { ok, counts } = result
  // unregistered を failing より優先 (未登録が主因なら先に登録を促す)
  const cause = !ok ? (counts.unregistered > 0 ? 'unregistered' : 'failing') : 'ok'
  return { ok, cause }
}
未登録のジョブがあるのに failing として「実行ログを調べてください」と案内すると、調査が空振りになります。
登録すれば解決する可能性が高いものを先に示す、という考え方です。
CI 側の組み込みと段階導入
ヘルスチェックのスクリプトが exit 1 で終わる場合、そのステップは continue-on-error: true で受けておき、後段のステップで原因分類をします。
このとき、先に死活確認(healthz)を評価するのがコツです。
「実行環境ごとダウンしている」のか「cron だけ壊れている」のかを、正確に切り分けられます。
また、ジョブを一括で登録すると、問題が起きたときの影響範囲が大きくなります。
次のような段階導入のチェックリストを、コードと一緒に管理しておくと運用の判断が楽になります。
- 副作用の小さい read-only 系のジョブから先に登録する
- 重い処理や本番への副作用があるジョブは、手動実行で動作を確認してから登録する
- 登録後は ledger(監視対象一覧)と実際の登録内容を突き合わせる
つまづきやすいポイント
- API のページング:
limit=100のような固定件数で履歴を取ると、monthly や quarterly の直近の成功が古いページに落ちて取りこぼします。取得件数が1ページ分に満たなくなるか、上限ページ数に達するまでループしてください - grace の入れ忘れ:lookback をちょうど24時間にすると、実行時刻の揺らぎで誤検知が出やすくなります。daily には余裕を持たせるのが無難です
- cron 式の例外:
?や、複数の値を持つ指定を想定していないと誤分類します。不正な式は黙って通さず、例外にして気づけるようにしました - 未登録と失敗の混同:両者を同じ「失敗」で扱うと、通知を受けた人が調査の方向を間違えます
まとめ
「どれか1本成功すればOK」の監視は、ジョブが増えるほど失敗を隠します。
cron 式から周期クラスを推定すれば、週次・月次・四半期のジョブも同じ仕組みで個別に評価できます。
判定は副作用のない純粋関数にして、unregistered と failing を分けて原因を伝えると、初動が速くなります。
まずは手元のジョブ一覧と、各ジョブの最終成功時刻を突き合わせるところから試してみてください。