
はじめに
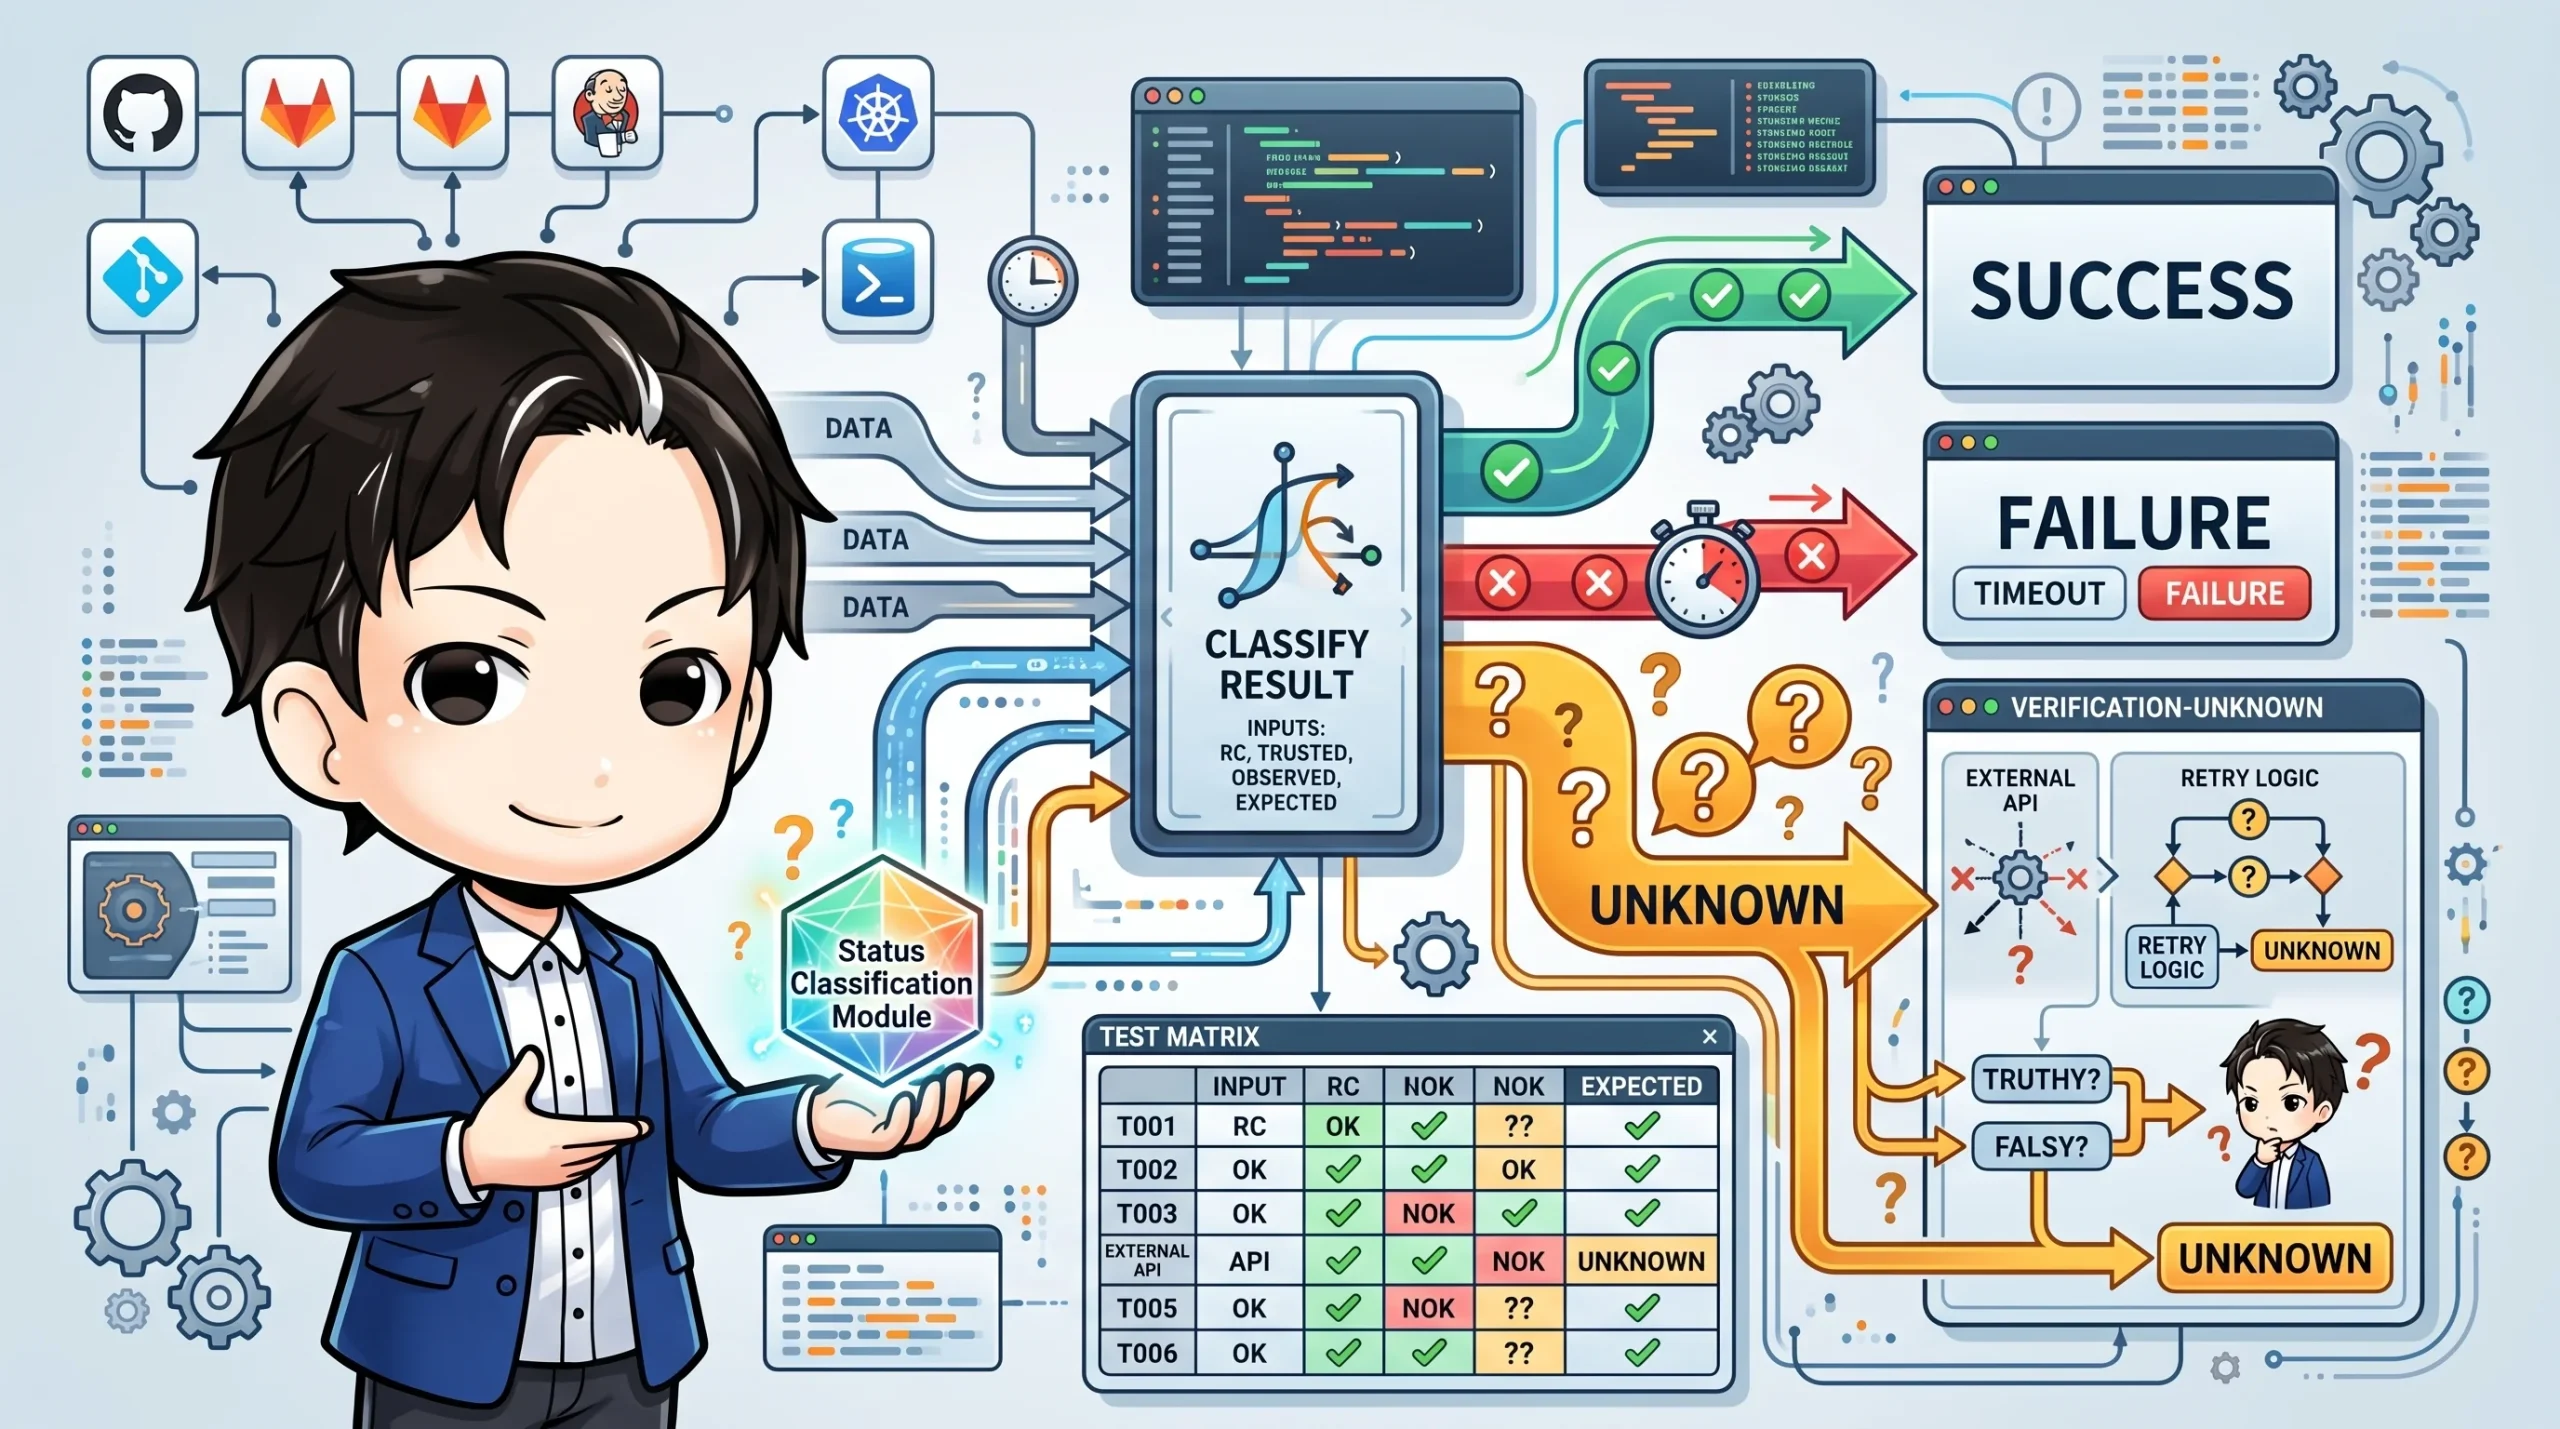
自前のCIディスパッチャやデプロイスクリプトを書いていると、「このジョブは成功と名乗ってよいか」を複数の条件から判定する処理が必ず出てきます。
多くの場合、条件は「真」か「偽」で素直に判定できますが、なかにはそもそも確認自体ができないケースがあります。
外部APIへの問い合わせが必要な条件で、その問い合わせ自体がネットワーク不調や権限不足で失敗してしまう場合です。
このとき「確認できなかった」を安易に「偽」や「真」のどちらかに丸めてしまうと、下流のロジックがその欠落を別の意味に解釈してしまい、本来は未検証のはずの結果がそのまま成功として扱われてしまうことがあります。
この記事では、そうした「わからない」という第三の状態をどう設計に組み込むか、そのパターンを整理します。
こんな人におすすめ
- CIやデプロイパイプラインで独自の成功/失敗判定ロジックを書いている方
- 複数条件のAND判定が散らばって管理しづらくなっている方
- 外部APIの呼び出し結果を判定条件に使っていて、呼び出し自体の失敗を考慮できていない方
- 状態分類ロジックのテストをどう網羅すればよいか悩んでいる方
「成功」の条件を1つの関数に集約する
条件が複数ある判定ロジックは、呼び出し側のあちこちに条件分岐を書いてしまうと、後から条件を1つ追加したときに書き忘れる分岐が出てきます。
これを防ぐには、判定ロジックを1つの関数に集約し、優先順位を固定してしまうのが確実です。
# 「成功」を名乗れるのは3条件がすべて揃うときだけ。
# 条件が1つでも欠けたら、専用のステータスを返す(呼び出し側に判定を散らさない)。
classify_result() { # <exit_code> <trusted> <expected_ref> <observed_ref_at_finish>
  local rc="$1" trusted="$2" expected="$3" observed="$4" result

  case "$rc" in
    0)   result=success ;;
    124) result=timeout ;;
    *)   result=failure ;;
  esac

  # 条件3: 終了時点でも参照が一致しているか
  if [ -n "$observed" ] && [ "$observed" != "$expected" ]; then
    result=stale
  fi

  # 条件1: 信頼できる実行環境か
  if [ "$trusted" != "true" ] && [ "$result" = "success" ]; then
    result=untrusted-success
  fi

  # 条件3の派生形: そもそも確認できなかった場合も「欠けた」扱いにする
  if [ -z "$observed" ] && [ "$result" = "success" ]; then
    result=verification-unknown
  fi

  printf '%s' "$result"
}
ポイントは判定の順序です。「確認できなかった」の判定を「信頼できない実行環境だった」の判定より後に置いています。
先に確認不能の判定をしてしまうと、「信頼できない実行環境だった」という情報が「未検証」に上書きされて消えてしまうためです。優先順位を関数の中に固定しておけば、条件を追加するときもレビューで抜け漏れに気づきやすくなります。
「わからない」を専用のステータスとして扱う
このパターンの本質は、検証不能な状態を既存の確定的なステータス(失敗、変更あり、成功など)に無理やり丸めないことです。
丸めてしまうと、丸めた先の意味が本来の意味とズレてしまい、偽陽性や偽陰性の原因になります。「わからない」には「わからない」専用のステータス(上のコードでいう verification-unknown)を用意しておくのが安全です。
さらに重要なのは、その「わからない」を下流の呼び出し側が暗黙に成功扱いしないかを確認することです。検証元がステータスを明示的に返さなければ、下流の別ロジックがその欠落を「照合スキップ」という別の意味で解釈し、結果的に未検証のまま成功が確定してしまうことがあります。片方だけを直しても、もう片方の解釈次第で同じ問題が再発する点には注意が必要です。
一過性障害だけで安全側に倒れないためのリトライ
未検証扱いになると、本来は正しいはずの結果が保留になるというユーザー体験上のコストが発生します。そこで、確認処理そのものに軽いリトライを入れておくと、ネットワークの一過性障害だけで未検証に落ちるのを避けられます。
# 確認できないと「未検証」扱いになり成功にならないので、ネットワークの
# 一過性失敗だけでそこに落ちないよう2回まで試す。
for attempt in 1 2; do
  observed="$(fetch_current_ref)"
  printf '%s' "$observed" | grep -qE '^[0-9a-f]{40}$' && break
  [ "$attempt" = 1 ] && sleep 2
done
権限不足のような恒常的な失敗であれば、2回とも同じ応答になるだけなので、待ち時間の増加は目安として数秒程度に収まります。リトライは「一過性かどうかを見極めるための時間稼ぎ」であって、恒常的な失敗まで隠すものではない、という位置づけです。
全組み合わせをテーブル駆動テストで検証する
条件A×条件B×条件Cのような分岐が多いロジックは、個別のユニットテストを積み上げるより、期待値を1行ずつ並べたテーブル駆動テストにしたほうが優先順位の抜けや境界条件の見落としに気づきやすくなります。
expect() { # <期待値> <exit_code> <trusted> <expected> <observed> <説明>
  local want="$1" got
  got="$(classify_result "$2" "$3" "$4" "$5")"
  [ "$got" = "$want" ] && ok "$6 → $got" || bad "$6 → 期待 $want だが $got"
}

expect success              0   true  "$REF" "$REF"   "3条件が揃った"
expect untrusted-success    0   false "$REF" "$REF"   "信頼できない実行環境"
expect stale                0   true  "$REF" "$OTHER" "実行中に参照が変わった"
expect verification-unknown 0   true  "$REF" ""       "終了時に確認できなかった"
入力の組み合わせを表として並べておくと、後から条件を追加したときにも「どの組み合わせをまだテストしていないか」が一目でわかります。
つまづきやすいポイント
- 外部APIの認証情報を実行ホストのアンビエントな設定に依存させると、CIランナーの実行コンテキストなど環境によって意図せず別の認証情報が使われることがあります。呼び出しごとに使う認証情報を明示するのが安全です。
- 外部コマンドはエラー時にも成功時と紛らわしい出力をすることがあります。終了コードとは別にエラーJSONを標準出力に流すクライアントもあるため、「値が変わった」と解釈する前に、期待するフォーマット(ハッシュ値のパターンなど)に一致するかまで検証する必要があります。
- リトライの回数や待機時間をハードコードしていると、外部APIのレイテンシ傾向が環境によって違う場合に調整が効きません。設定可能にしておくと運用の柔軟性が上がります。
まとめ
複数条件のAND判定は、判定ロジックを1関数に集約し、優先順位を固定することで管理しやすくなります。
「わからない」は既存のステータスに丸めず専用の状態として扱い、下流がそれを暗黙に成功扱いしていないかもあわせて確認することが重要です。
一過性障害を吸収する軽いリトライと、条件の全組み合わせを網羅するテーブル駆動テストを組み合わせておくと、この種の状態分類ロジックはかなり堅牢になります。