
はじめに
デプロイ後に自動で「サイトが生きているか」を確認するスモークテストは、多くのチームで導入されている仕組みだと思います。ただ、運用を続けていると、意外な落とし穴に気づくことがあります。
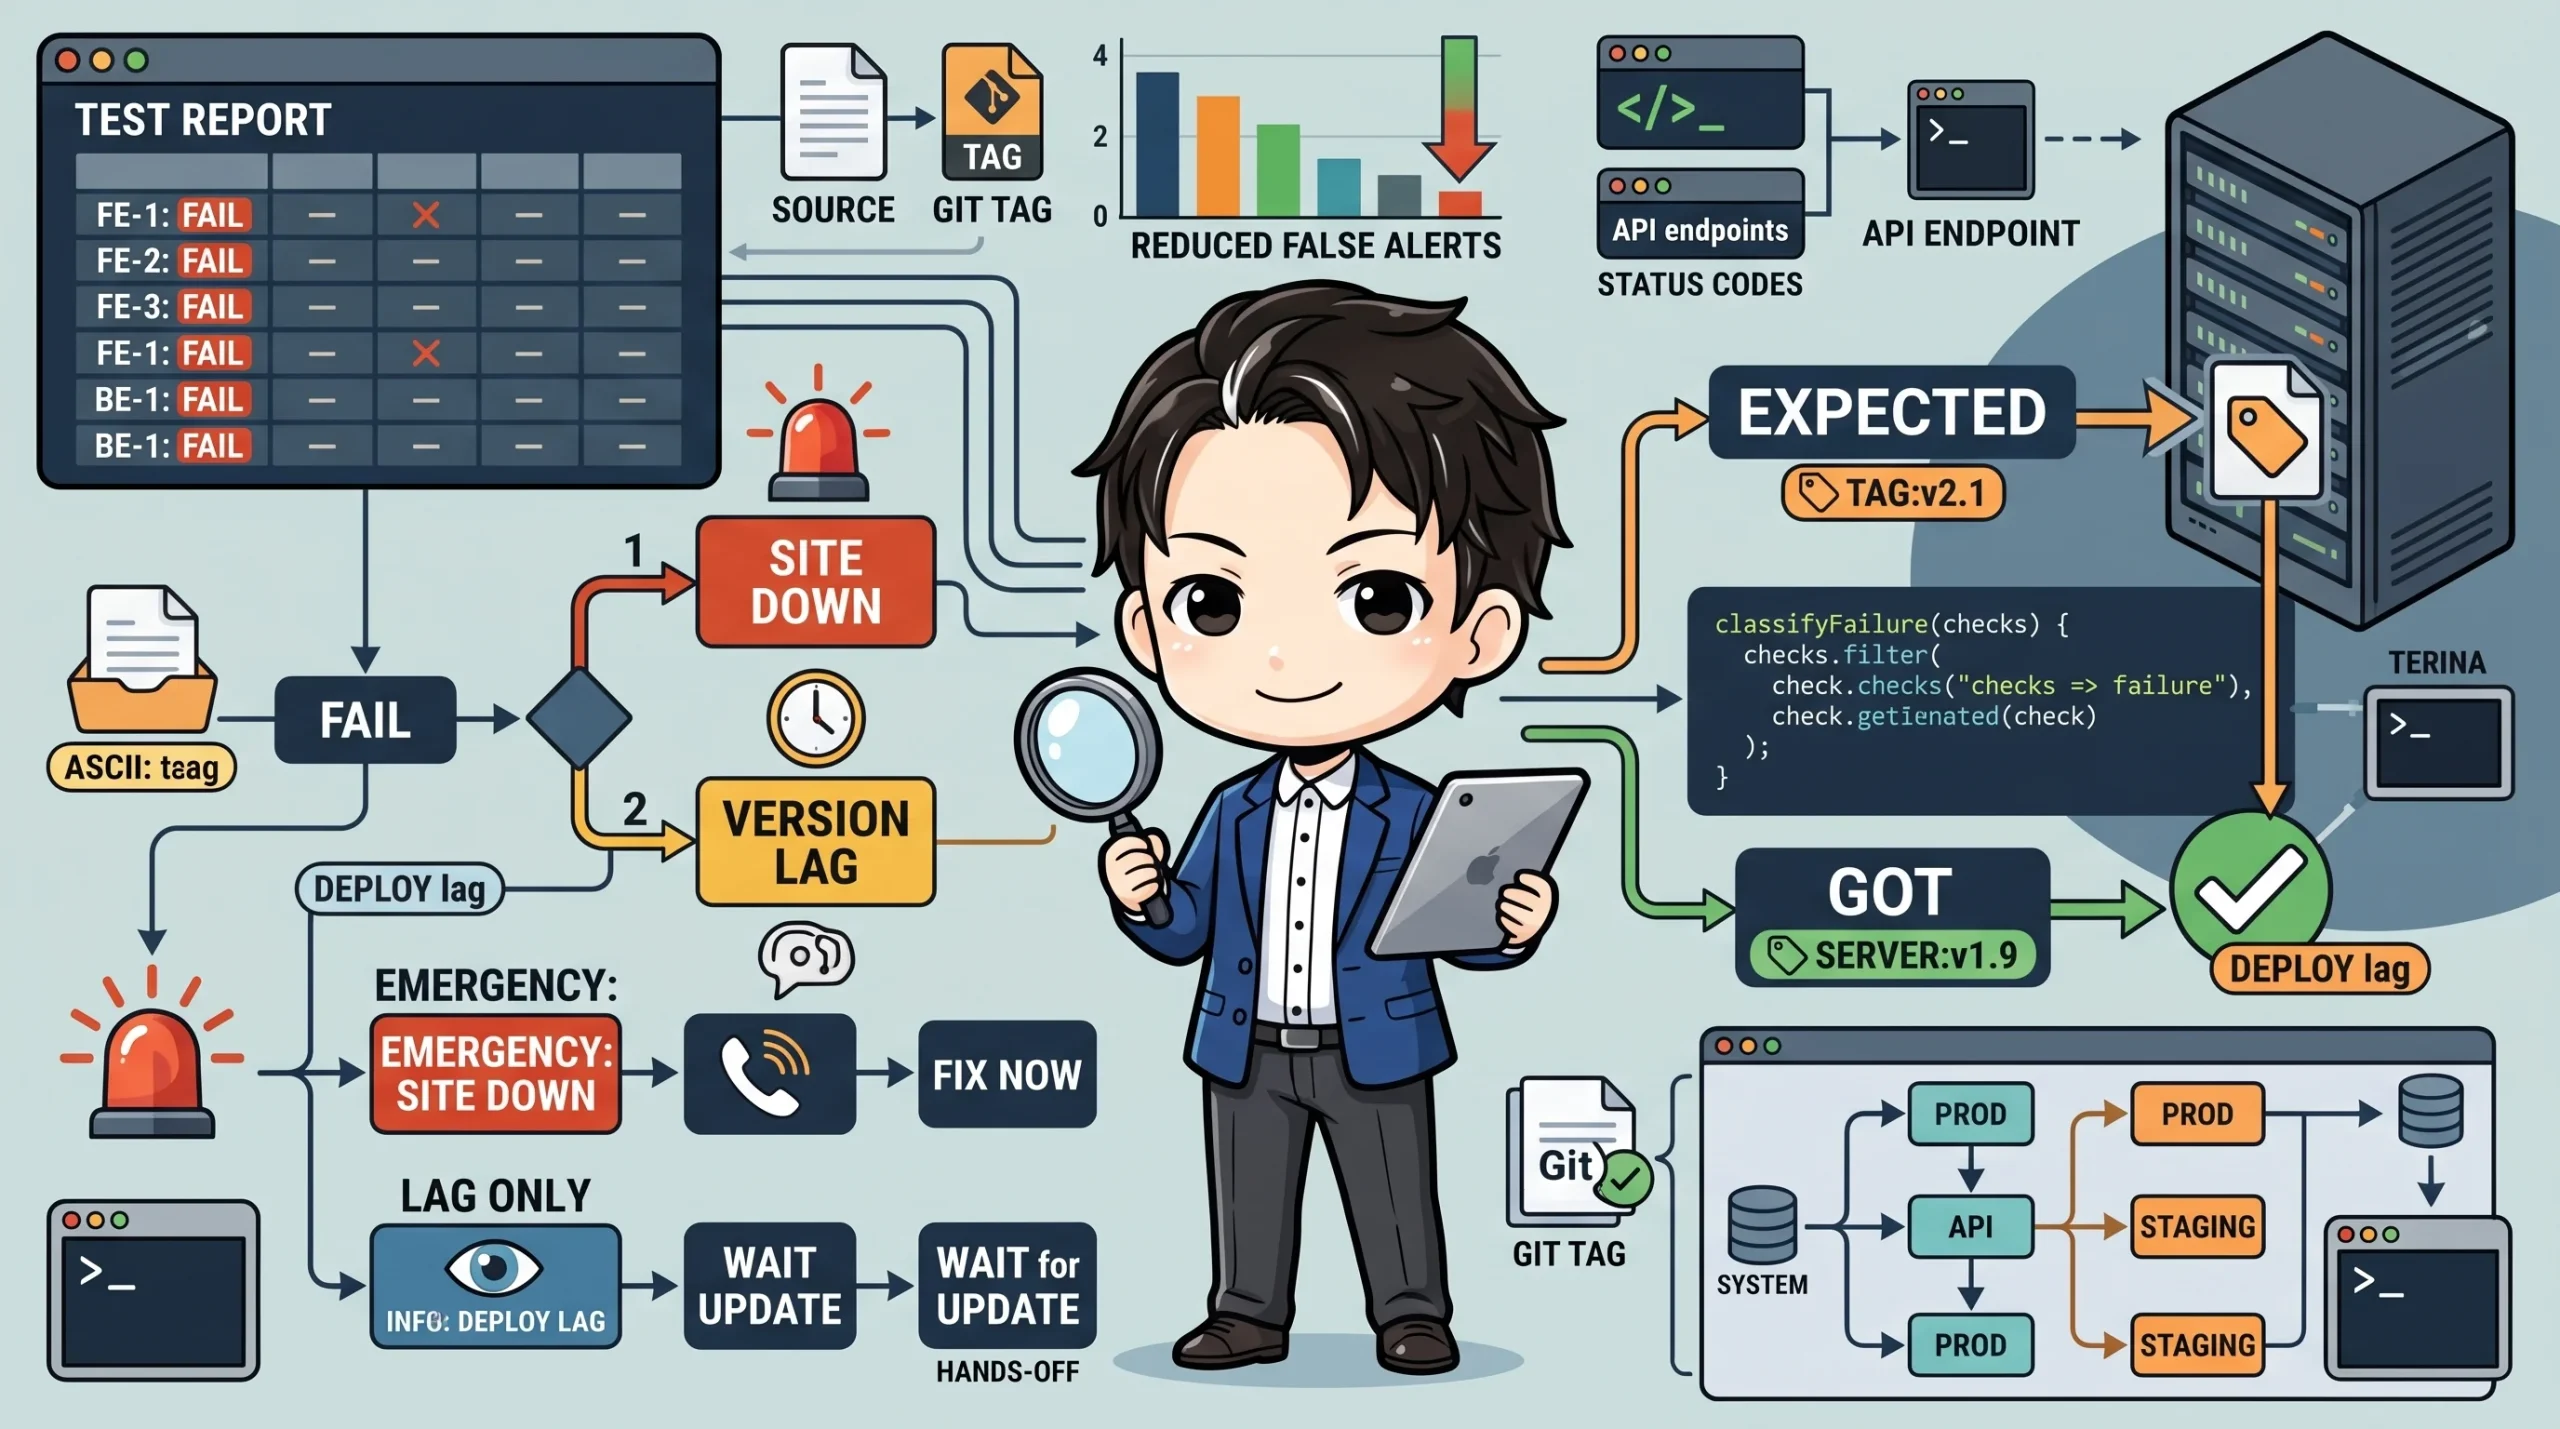
それは、「アプリケーションが完全にダウンしている」ケースと、「新しいバージョンのデプロイがまだ本番環境に反映されていないだけ」のケースを、同じ「失敗」として一律に扱ってしまう問題です。
前者は今すぐ対応が必要な緊急事態です。
一方で後者は、単なる反映待ちや、環境によっては手動更新を待つだけの状態にすぎません。
両者を区別せずに同じアラートを出してしまうと、対応する人は毎回「これは緊急事態なのか、それとも待てばいいだけなのか」を手作業で判断しなければならなくなります。これが積み重なると、アラート自体が「オオカミ少年」化してしまいます。
この記事では、失敗理由の文字列パターンをもとに障害を「全断」「部分退行」「バージョン未反映」の3種類に分類し、それぞれに応じた対応手順をアラート本文に自動で埋め込む設計を紹介します。あわせて、判定の元になる「期待バージョン」の取得方法を見直すことで、CIのタイミングに起因する誤判定を防ぐ工夫にも触れます。
こんな人におすすめ
- デプロイ後に自動でヘルスチェック・スモークテストを回している方
- アラートが頻発して確認が後回しになり、本当に緊急な障害を見落とした経験がある方
- GitHub Actionsの
workflow_runトリガーを使っていて、チェックアウトタイミングのズレに悩んだことがある方 - 機械的な障害検知だけでなく、そのあと人間が何をすべきかまでアラートに含めたい方
「全断」判定のロジックが抱えていた弱点
もともとの実装では、スモークテストの各チェック結果に status というフィールドを持たせ、これが null(fetch失敗やタイムアウト)だった場合に「全断」と判定していました。
一見シンプルで妥当なロジックに見えます。ところが、単一のチェック項目だけが「デプロイしたバージョンと、実際に動いているバージョンが一致しない」という理由で失敗した場合でも、機械的に「サイト全断」に分類されてしまう構造的な弱点がありました。バージョン不一致のチェックも、実装上は status が null になる形で失敗を表現していたためです。
これでは、緊急度も対応手順もまったく異なる2つの事象が、同じ扱いになってしまいます。
失敗理由の文字列から「未反映のみの失敗」を切り分ける
対策として、失敗理由の文字列が決まったパターン(expected version X, got Y のような形式)にマッチするかどうかで、「バージョン未反映のみの失敗」を個別に判定するロジックを追加しました。
function isDeployLagOnlyFailure(checks) {
  const failed = (checks || []).filter((c) => !c.ok);
  if (failed.length !== 1) {
    return false;
  }
  const reason = failed[0].reason;
  return typeof reason === 'string' && reason.startsWith('expected version ');
}

function classifyFailure(checks) {
  const failed = (checks || []).filter((c) => !c.ok);
  const allConnectionFailure = failed.length > 0 && failed.every((c) => c.status == null);
  const deployLagOnly = isDeployLagOnlyFailure(checks);
  // allConnectionFailure / deployLagOnly の順で判定し、
  // それぞれに応じたnote文言(アラート本文)を出し分ける
  return { allConnectionFailure, deployLagOnly };
}
文字列パースによる分類は、正直なところ壊れやすい手法です。失敗理由のフォーマットが少しでも変わればすぐに検知漏れが起きます。ただ、失敗理由を生成している側(チェック本体)と、それを分類する側が同じリポジトリ内にあるなら、フォーマットの一致は比較的保証しやすいと考えています。
「期待バージョン」の取得元をソースファイルからリリースタグへ
もう一つ見つかったのが、判定の基準そのものがズレるケースです。
もともと「期待バージョン」は、main ブランチ上のソースファイルに書かれたバージョンヘッダーを読み取って取得していました。ところが、CIが workflow_run トリガー経由で走る構成の場合、チェックアウトされる head_sha が、リリース処理(バージョン更新コミット)より前のものになってしまうレース条件があります。
この状態だと、実際にはまだ新バージョンが反映されていないにもかかわらず、期待バージョンの取得元自体が古いままなので、判定が誤って「PASS」を返してしまいます。
これを避けるため、期待バージョンの取得元を、GitHub Releaseの最新タグから取得する方式に切り替えました。
- name: 期待バージョン取得(最新 GitHub Release)
  id: expected_version
  env:
    GH_TOKEN: ${{ github.token }}
  run: |
    set -euo pipefail
    VERSION="$(gh release view --repo "${GITHUB_REPOSITORY}" --json tagName -q .tagName)"
    echo "version=${VERSION}" >> "$GITHUB_OUTPUT"
gh release view はリリースそのものの情報を見に行くため、ソースファイルの内容よりも「実際に何が最新としてリリースされたか」を正確に反映します。CIのチェックアウトタイミングに引きずられない基準を持てるようになりました。
環境変数で受け渡す値は、形式を検証してから使う
CI側で取得した期待バージョンは、環境変数経由でスクリプトに渡す構成にしました。受け取る側では、値がsemver形式(\d+\.\d+\.\d+)にマッチする場合だけを優先的に採用し、それ以外の値が来た場合は既存のフォールバック(ソースファイル読み取り)に自動的に戻すようにしています。
function resolveExpectedVersion() {
  const fromEnv = (process.env.SMOKE_EXPECTED_VERSION || '').trim();
  if (/^\d+\.\d+\.\d+$/.test(fromEnv)) {
    return fromEnv;
  }
  // フォールバック: ソースファイルのバージョンヘッダーを読む
}
外部プロセス(この場合はCIのステップ出力)から受け取る値を無条件に信頼しないという、ごく基本的な防御ですが、環境変数の受け渡し経路が増えるほど効いてくる設計だと感じています。
分類結果を、人間向けの対応手順にそのままつなげる
障害を分類できるようになったら、その結果を活かさない手はありません。分類結果に応じて、Issue本文に人間向けの手動対応手順(いわゆるRunbook)を自動で埋め込むようにしました。
「バージョン未反映のみ」と判定された場合は、緊急対応の呼びかけではなく、手動更新の手順書へのリンクや、次に確認すべきコマンドをそのままアラートに含めます。「機械的な検知」と「人間が次に何をすべきか」を、同じアラートの中でつなげる設計です。
なお、このときスコープは「CIの検知・診断ロジックの改善」だけに絞り、「反映待ち時間そのものを自動化・短縮する話」は明示的に対象外としました。診断ロジックの改善と、実際のオペレーション改善を同じ変更にまとめないという判断は、レビューのしやすさの面でも再利用できる考え方だと思います。
つまづきやすいポイント
- 文字列パースによる失敗理由の分類は、フォーマットが変わると静かに壊れます。チェックを生成する側と分類する側が別リポジトリ・別言語になる場合は、特に注意が必要です
- レースコンディションは、ローカルの手元環境では再現しにくく見落としがちです。「CIのトリガー種別によってチェックアウトされるコミットが変わりうるか」は、構成変更時に一度疑ってみる価値があります
- 環境変数経由で値を受け渡す箇所が増えると、想定外の値が渡ってきたときのフォールバックを用意し忘れがちです
- 検知ロジックの改善と、実際の運用改善(自動化など)を同じ変更にまとめると、レビューの論点が広がりすぎてしまいます
まとめ
スモークテストの「全断」判定は、シンプルな条件式ほど、意図しない事象まで巻き込みやすい落とし穴を抱えています。
今回のケースでは、失敗理由の文字列パターンで「バージョン未反映のみの失敗」を切り分け、あわせて判定基準となる「期待バージョン」の取得元をリリースタグに変更することで、CIのタイミングに起因する誤判定も防げました。
障害を分類するだけで終わらせず、分類結果を人間向けの対応手順に直結させる設計は、他の監視・アラート基盤にも応用しやすい考え方だと思います。同じような「緊急度の異なる失敗が同じアラートに混ざっている」状況に心当たりがあれば、まず失敗理由の分類から見直してみる価値があります。