
はじめに
「ビルドしたら、あとはリラックスする」という趣旨の投稿が話題になっていました。
一見するとただの心構えの話に見えますが、技術的に読み解くと中身はもっと具体的です。
“relax できる”状態というのは、根拠のない楽観ではなく、何か壊れたら自動で気づける仕組みが裏にあるという前提の上に成り立っています。
裏を返せば、デプロイのたびに手動でログを追いかけたり、本番のスクリーンショットを何度も確認したりしている状態は、まだ仕組み化が足りていないということです。
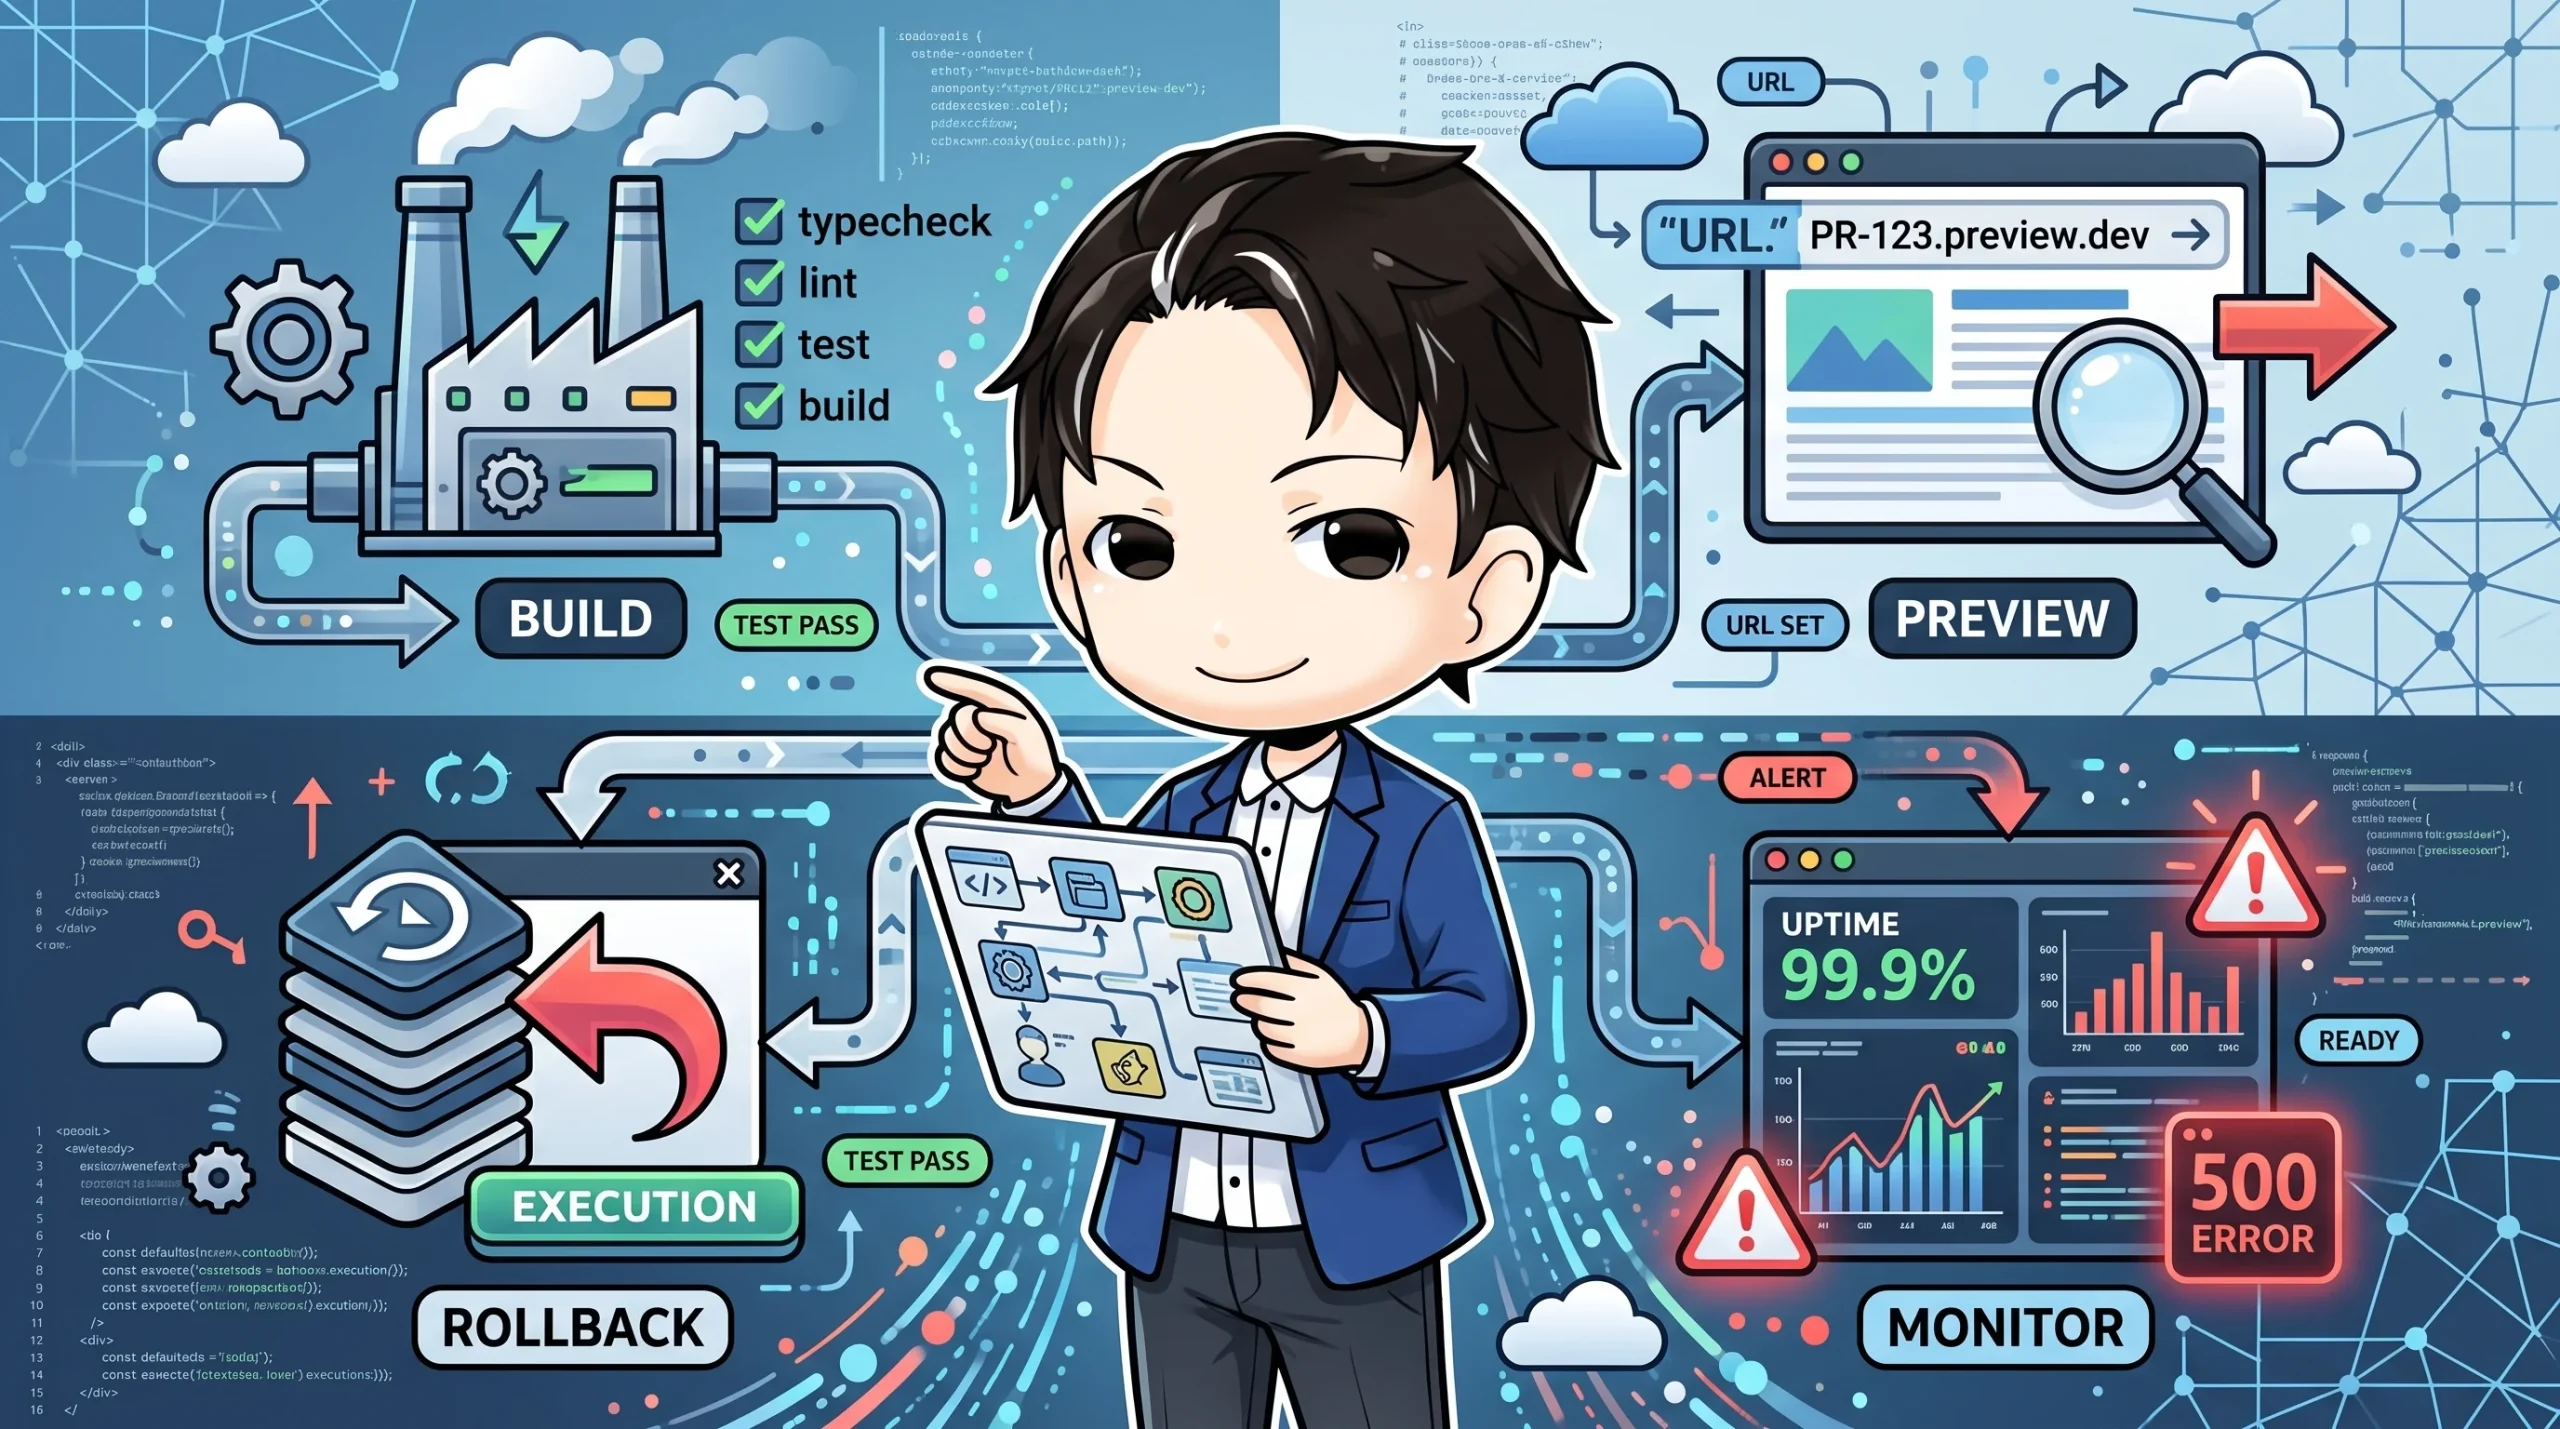
本記事では、「ビルドして安心して離れられる」状態を作るために、どこに自動化のポイントを置けばよいかを、CI・プレビュー環境・ロールバック・監視の4つの観点で整理します。
こんな人におすすめ
- デプロイのたびに手動でチェックリストをこなしている方
- 本番反映後、しばらくSlackやダッシュボードに張り付いてしまう方
- ロールバック手順が「わかる人しか分からない」状態になっているチーム
- CI/CDをすでに導入しているが、パイプラインを「安心材料」として設計できていない方
なぜ「ビルドが通った」だけでは安心できないのか
CIが緑になった状態と、本番で問題なく動いている状態は、実は別物です。
ビルドやユニットテストが通っても、環境変数の設定ミスや、外部APIの応答遅延、キャッシュの不整合などは、本番相当の環境でしか顕在化しないことがあります。
つまり「ビルドが通った」は最低ラインのチェックにすぎません。
そこから先の「デプロイ後に何が起きているか」を機械的に拾える状態にして初めて、心理的に手放せるようになります。
デプロイ前に自動で止める:CIゲートを厚くする
まず土台として、明らかにおかしい変更は本番に届く前に止めます。
# .github/workflows/deploy-gate.yml
name: deploy-gate
on:
  pull_request:
    branches: [main]

jobs:
  gate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: 20
      - run: npm ci
      - run: npm run typecheck
      - run: npm run lint
      - run: npm test -- --run
      - run: npm run build
ポイントは、typecheck・lint・test・buildをすべて同じワークフローの必須チェックにしておくことです。
どれか一つでも欠けていると、「ビルドは通ったのに型エラーが本番で発覚する」といった事態が起こりえます。
本番前にプレビュー環境で目視確認できるようにする
自動チェックだけでは拾えない見た目やUXの崩れは、プレビュー環境で確認する運用にします。
PRごとに独立したURLが払い出される仕組み(VercelのPreview Deploymentsが代表例です)を使うと、レビュアーが「コードの差分」だけでなく「動いている画面」を見た上でマージ判断できます。
# PRごとのプレビューURLをPRコメントに自動投稿する例(概念)
PREVIEW_URL="https://pr-${PR_NUMBER}.preview.example.dev"
gh pr comment "$PR_NUMBER" --body "プレビュー環境: ${PREVIEW_URL}"
「コードレビューは通ったが、実際の画面は誰も見ていなかった」という抜け漏れを防ぐには、プレビューURLをレビューフローの必須項目にしてしまうのが確実です。
ロールバックを「秒で戻せる」設計にしておく
安心して離れられるかどうかを最も左右するのが、実はロールバックの速さです。
問題が起きたときに「原因調査してから修正PRを作ってデプロイし直す」というフローしかないと、復旧までの時間が長くなり、その間ずっと気が抜けません。
そこで、直前の正常なビルドへ即座に切り替えられる仕組みを先に用意しておきます。
#!/usr/bin/env bash
# rollback.sh: 直前のデプロイに即時ロールバックする
set -euo pipefail

PREVIOUS_DEPLOYMENT_ID=$(cat .last_successful_deployment_id)

echo "ロールバック先: ${PREVIOUS_DEPLOYMENT_ID}"
deploy-cli promote "${PREVIOUS_DEPLOYMENT_ID}" --env production
ビルドのたびに「直前の正常なデプロイID」を1ファイルに記録しておくだけで、緊急時に人間が判断に迷う要素を減らせます。
ロールバックの実行コマンドを1本化しておくことが、心理的な余裕に直結します。
デプロイ後の異常を自動で拾う監視を仕込む
最後に、デプロイ後しばらくは自分の目で追いかけなくても済むように、異常検知を仕込みます。
// healthcheck.ts: デプロイ直後にエラー率を自動チェックする
async function checkErrorRateAfterDeploy(deployTime: number): Promise<void> {
  const windowMinutes = 10;
  const errorRate = await fetchErrorRate({ sinceMinutesAgo: windowMinutes });

  if (errorRate > 0.05) {
    await notifySlack(
      `デプロイ後${windowMinutes}分間のエラー率が${(errorRate * 100).toFixed(1)}%です。ロールバックを検討してください。`
    );
  }
}
デプロイ直後の一定時間だけ監視の閾値を厳しくしておき、通知が来なければ「見に行かなくて大丈夫」と判断できる状態にします。
これが「ビルドしてリラックスする」を技術的に支える最後のピースです。
つまづきやすいポイント
- CIゲートを厚くしすぎると、ビルド時間が伸びてリリース速度が落ちるため、必須チェックと任意チェックを分けたほうが現実的です
- プレビュー環境のURLが毎回変わる運用だと、レビュアーが確認を後回しにしがちなので、PRコメントへの自動投稿など「見に行く手間を減らす」工夫が必要です
- ロールバック手順を作っても、実際に一度も試したことがないと、いざというときに動かないリスクが残ります
- 監視の閾値を厳しくしすぎると、通常の変動でも通知が飛び、次第に通知を無視する習慣がついてしまいます
まとめ
「ビルドしたらリラックスする」という言葉の裏には、CIゲート・プレビュー確認・即時ロールバック・デプロイ後監視という4つの仕組みが揃っている前提があります。
どれか1つだけでは安心材料として不十分で、複数を重ねて初めて「見に行かなくても大丈夫」と言える状態になります。
まずは、今のパイプラインのどこが「人間の目視頼み」になっているかを洗い出すところから始めてみてください。