
はじめに
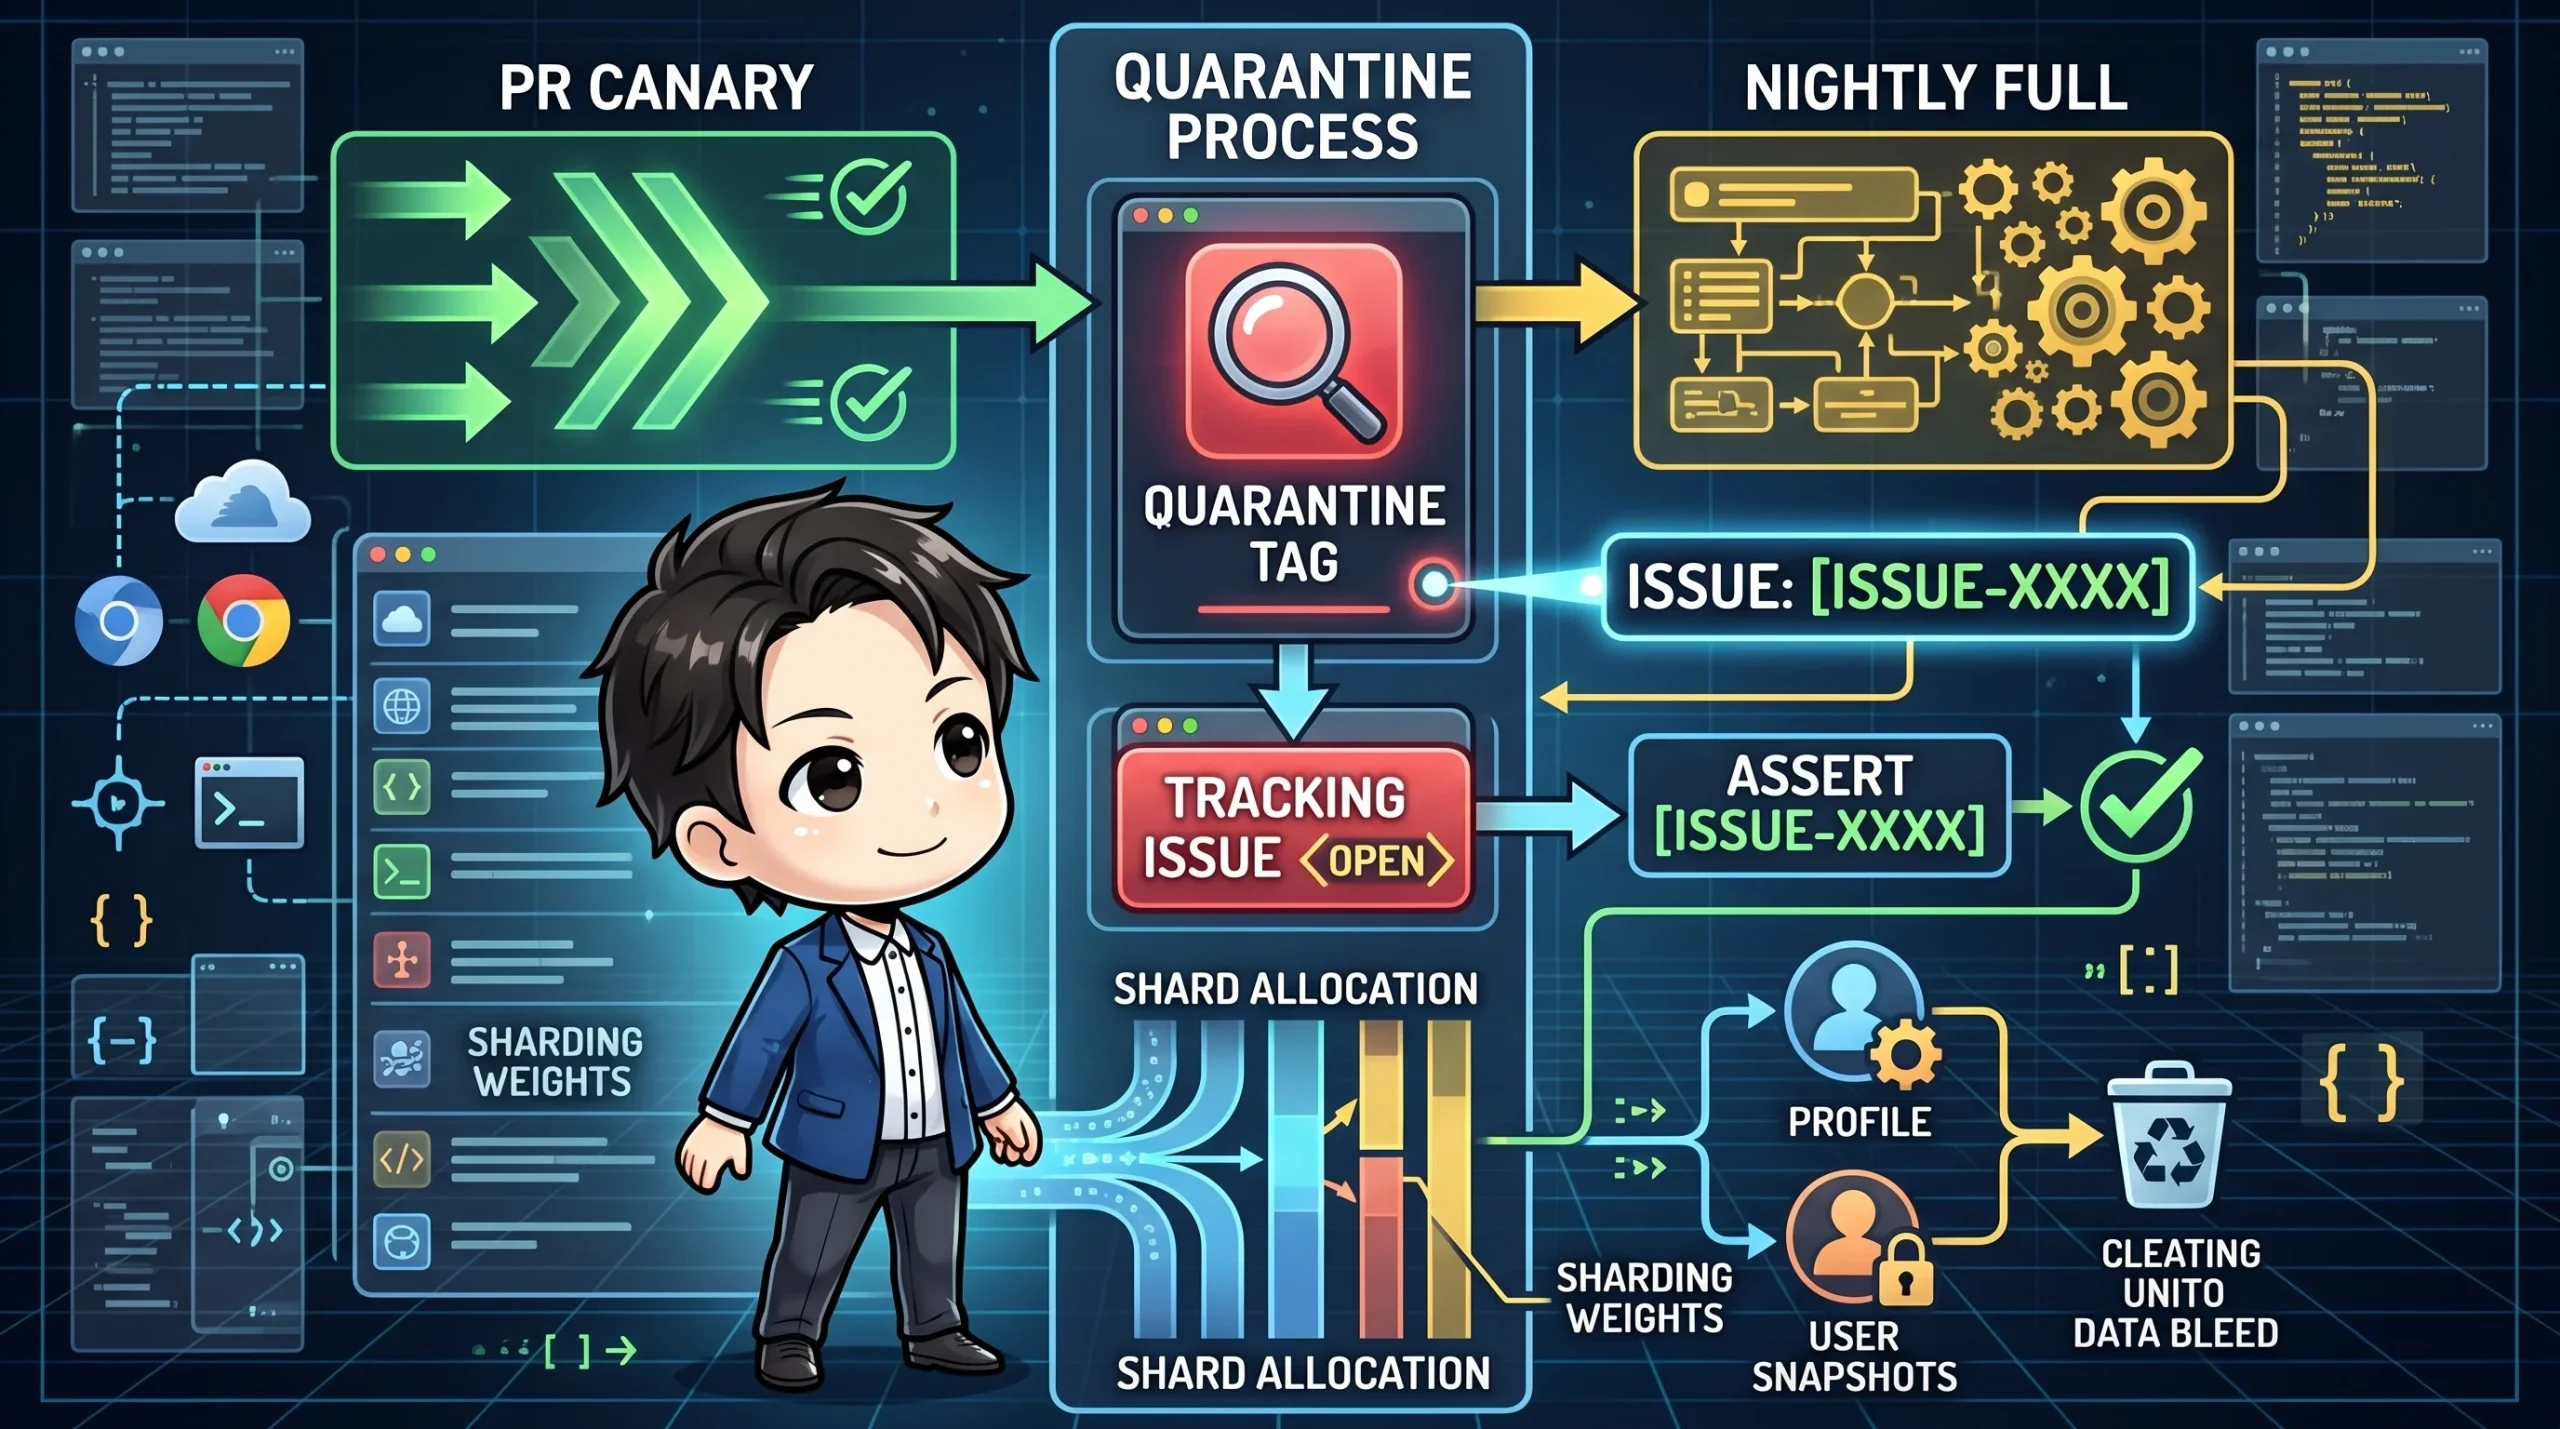
E2Eテストを「PRごとに回す高速レーン」と「毎晩フルで回すnightly」に分けて運用しているチームは少なくないと思います。この運用を続けていると、いずれ「重いテストケースだけをnightlyに退避する」検疫の仕組みが必要になってきます。あるプロジェクトでは、2コアのようにリソースが絞られたCIランナー上で一部のE2Eケースがtimeoutするようになり、該当ケースだけを再度nightly専用タグに戻す対応が発生しました。
ここで厄介なのは、検疫タグそのものは簡単に作れても、運用を続けるうちに「なぜこのテストが隔離されているか」を追跡する主体が消えてしまい、恒久的な隔離状態がそのまま固定化してしまう点です。今回は、この形骸化を防ぐための設計と、隔離運用に付随して見えてきたテストヘルパー側の落とし穴について整理します。
こんな人におすすめ
- E2Eを高速レーンとnightlyに分けて運用しているチーム
- リソースが絞られたCIランナーでE2Eのtimeoutが増えてきた
- 過去に検疫・隔離タグが形骸化した経験がある
- shardによる分散実行でテスト時間のばらつきに悩んでいる
- ユーザー切り替えを伴うE2Eでキャッシュの混線に悩んでいる
追跡先Issueを「生きた状態」に固定する
過去の反省として、隔離用タグの根拠となっていたIssueが軒並みクローズされ、「なぜこのテストが隔離されているか」を追跡する主体が消えてしまったことがありました。そこで、追跡Issue番号を各所に文字列リテラルで埋め込むのではなく、単一の定数としてexportし、テストでその値自体をアサートする形にしています。
// 復帰追跡Issue。今回の再燃を管理する唯一の生きた追跡窓口。
// 過去にクローズされた一括対応Issueは履歴であり、現在の追跡には使わない。
export const TRACKING_ISSUE = 'ISSUE-XXXX'
describe('heavy/slow tracking policy', () => {
  it('uses the current recurrence issue rather than a closed one', () => {
    expect(TRACKING_ISSUE).toBe('ISSUE-XXXX')
  })
})
こうしておくと、定数の値を更新し忘れたり、過去の番号に先祖返りしたりした場合にテストが落ちるため、「クローズ済みIssue番号だけが参照として残る」事故を機械的に検知できます。
shard分散実行での重み膨張を防ぐ回帰テスト
E2Eをshardで分散実行している場合、1つのファイルに重いケースと軽量なケースが混在すると、ファイル単位の重み推定がおかしくなりがちです。隔離タグを付けたケースが、同じファイル内にある軽量なPR向けcanaryケースの重みまで巻き込んで膨張させてしまわないかを、ユニットテストで固定しておくと安心です。
it('does not let a heavy case inflate a file that still contains a lightweight PR canary', async () => {
  const dir = await mkdtemp(path.join(os.tmpdir(), 'e2e-plan-'))
  await writeSpec(
    dir,
    'mixed.spec.ts',
    [
      "test('@critical @heavy expensive flow', async () => {})",
      "test('@critical lightweight canary', async () => {})",
    ].join('\n'),
  )

  const plan = await buildShardPlan({ total: 1, testDir: dir })

  expect(plan.specs).toEqual([
    expect.objectContaining({
      file: expect.stringContaining('mixed.spec.ts'),
      estimatedWeight: 30,
      weight: 30,
    }),
  ])
})
この手のテストは地味ですが、「隔離タグを増やしたらshardの実行時間が想定外に偏った」という事故を未然に防ぐ役割を果たします。
ユーザー切り替えE2Eでのスナップショットクリア
同一ブラウザコンテキストで別ユーザーへ切り替えるE2Eでは、Cookieをクリアしただけでは不十分なケースがあります。IndexedDBに前ユーザーの起動時スナップショットが残っていると、新しいユーザーの初期描画に混線することがあるためです。
そこで、認証情報だけでなく「クライアントが持つ起動時スナップショット」もクリアするヘルパーを用意しました。ただし、オフライン同期用の保留中キューまで一緒に消してしまうとオフライン機能のテスト自体が壊れてしまうため、消してよいものと消してはいけないものを明示的に分離しています。
/**
 * 同一 browser context で別ユーザーへ切り替える前に bootstrap snapshot だけを消す。
 * pending-mutations はユーザー別の同期キューなので、オフライン機能の検証を
 * 壊さないよう保持する。
 */
export async function clearBootstrapSnapshots(page: Page): Promise<void> {
  if (page.url() === 'about:blank') return

  await page.evaluate(
    async ({ dbName, storeName }) => {
      if (typeof indexedDB === 'undefined') return

      await new Promise<void>((resolve) => {
        const request = indexedDB.open(dbName)
        request.onerror = () => resolve()
        request.onsuccess = () => {
          const db = request.result
          if (!db.objectStoreNames.contains(storeName)) {
            db.close()
            resolve()
            return
          }

          const transaction = db.transaction(storeName, 'readwrite')
          transaction.objectStore(storeName).clear()
          const finish = () => {
            db.close()
            resolve()
          }
          transaction.oncomplete = finish
          transaction.onerror = finish
          transaction.onabort = finish
        }
      })
    },
    { dbName: OFFLINE_DB_NAME, storeName: OFFLINE_SNAPSHOT_STORE },
  )
}
剥奪判定と描画テストの前提を自動化で固定する
「隔離を解除してよいか」を人手の記憶に頼ると、基準があいまいになりがちです。nightlyのJob Summaryに実測値(実行時間・retryの有無)を毎晩出力し、「flakyがN回連続で0件なら通常レーンに戻す」という基準をレポートベースで判断できるようにしておくと、剥奪判定の属人化を避けられます。
あわせて、stale-while-revalidate的な描画をしている画面のE2Eでは、キャッシュされたスナップショットの有無に前提条件が依存していないかも確認が必要です。キャッシュが残っていると「スケルトン表示→データ差し替え」という過渡状態がスキップされてしまい、本来検証したいローディング状態そのものを検証できていないことがあります。
つまづきやすいポイント
- ユーザー切り替え時に状態を「全部クリア」すると、オフライン同期用の保留中キューまで消えてしまい、別のテストが壊れることがあります
- 検疫タグの根拠Issueをクローズしただけで追跡先を更新し忘れると、隔離理由が宙に浮いた状態のまま固定化します
- 剥奪判定を人手の感覚に任せると、「いつ通常レーンに戻すか」の基準がチームやタイミングによってぶれます
- キャッシュされたスナップショットが残っていると、ローディング状態の検証自体がスキップされていることに気づきにくいです
まとめ
検疫タグ運用は、隔離した瞬間よりも「隔離し続けている間」の設計の方が重要になりがちです。追跡先Issueを定数化してテストでアサートする、剥奪判定を実測値ベースの自動レポートで駆動する、といった仕組みを組み合わせることで、形骸化を防ぎやすくなります。あわせて、ユーザー切り替えやキャッシュ絡みのE2Eでは、「何を消して何を残すか」を明示的に分離しておくと、副作用による事故を減らせるはずです。