
はじめに
Cloudflare Hyperdrive のような外部クラウドサービスのリソース設定は、git にもアプリのコードにも残りません。
ダッシュボードでの手動操作やリソースの再作成で、設定がサイレントに変わってしまうことがあります。
その結果、「以前直したはずの本番障害が、原因不明のまま再発する」という厄介な状況が起こります。
この記事では、実運用しているサービスで nightly の設定ドリフト検知ワークフローに「外部サービス設定の assert」ステップを足した際の設計を紹介します。
終了コードの使い分け、シークレット未投入でも壊れない graceful skip、Issue の upsert といった、他の外部サービスにも流用できるパターンを中心に説明します。
こんな人におすすめ
- Cloudflare・Supabase・Stripe など、コード管理できない外部設定に不安がある方
- nightly の CI で「設定のずれ」を監視したい方
- 通知や Issue 起票を含む CI シェルスクリプトを堅牢に書きたい方
- 監視対象を段階的に有効化できる仕組みを作りたい方
設計方針:判定とCI連携を分ける
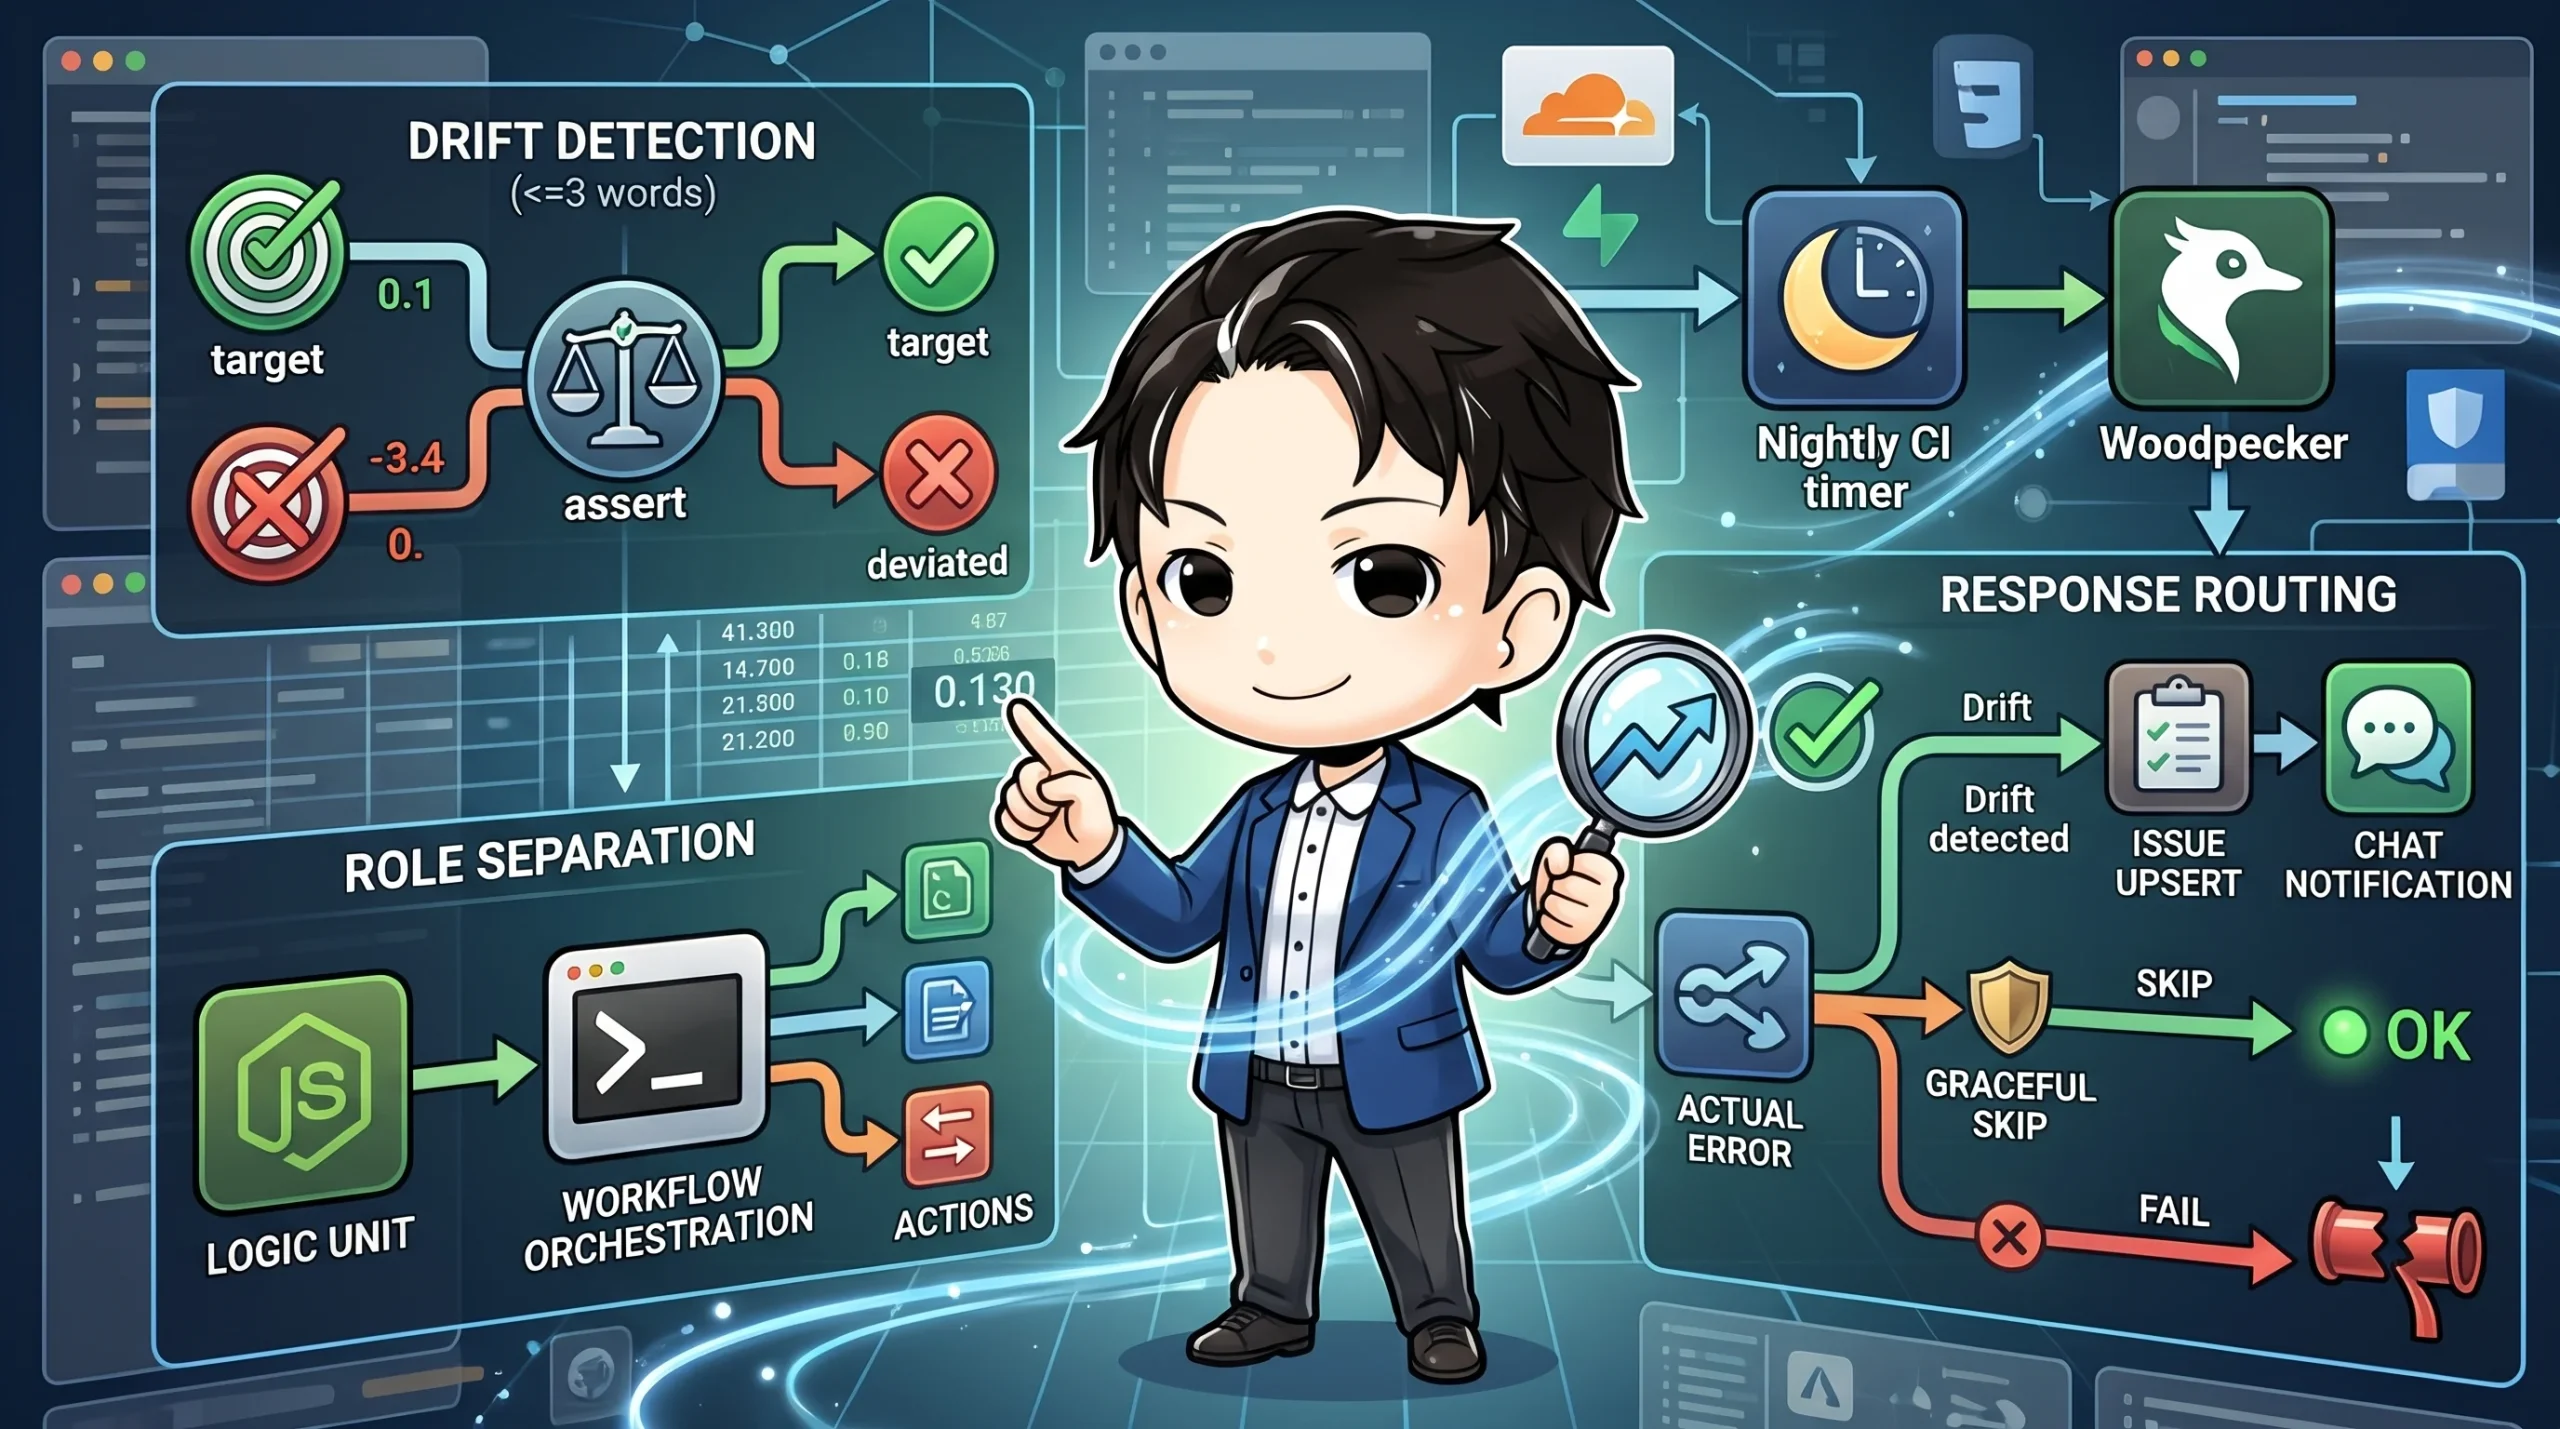
最初に決めたのは役割の分離です。
- Node.js スクリプト:純粋な判定ロジックだけを持つ(例:
assertCachingDisabled) - Shell スクリプト:終了コードを受け取り、通知と Issue 起票を担当する
判定ロジックを Node.js 側に閉じ込めると、ユニットテストをそちらに集中できます。
Shell 側は分岐とコマンド呼び出しだけになり、見通しが良くなります。
独立ステップとして CI に追加する
Woodpecker のワークフローに、既存の設定ドリフト検知とは別のステップとして追加します。
# .woodpecker/nightly-config-drift.yml
  external-service-drift:
    image: ci-image:node22
    pull: false
    # 他ステップの結果に依存せず実行する(関心事が別なため独立)
    depends_on: []
    environment:
      GH_TOKEN:
        from_secret: github_token
      GH_REPO: example-org/example-repo
      CLOUDFLARE_ACCOUNT_ID:
        from_secret: cloudflare_account_id    # 未設定でも graceful skip
      CLOUDFLARE_API_TOKEN:
        from_secret: cloudflare_api_token
      DISCORD_WEBHOOK_URL:
        from_secret: discord_nightly_webhook_url
    commands:
      - bash scripts/check-external-service-drift.sh
ポイントは depends_on: [] です。
既存の設定ドリフト検知が失敗しても、このステップは独立して実行されます。
2つは別々の関心事なので、片方の失敗で他方の通知が止まらないようにしています。
終了コードを3段階に使い分ける
「本物のインフラ障害」と「要対応の設定ずれ」は、重大度も対応者の動きも違います。
そこで終了コードを次のように分けました。
| 終了コード | 意味 | pipeline | 通知 |
|---|---|---|---|
| 0 | 問題なし、または graceful skip | 緑 | なし |
| 3 | ドリフト検出 | 緑のまま | Discord 通知と Issue 起票(人手で triage) |
| その他 | API 呼び出し失敗など | 赤 | インフラ障害として可視化 |
# scripts/check-external-service-drift.sh
node "${SCRIPT_DIR}/check-drift.mjs" 2>&1 | tee "$output_file"
node_exit=${PIPESTATUS[0]}

case "$node_exit" in
  0)
    # OK または graceful skip
    exit 0
    ;;
  3)
    # drift 検出 → 通知・起票して pipeline は緑のまま
    ;;
  *)
    # API 失敗等の回復不能なエラー → pipeline を赤にして可視化
    exit 1
    ;;
esac
$? ではなく PIPESTATUS[0] を使っているのは、tee にパイプすると $? が tee 側の終了コードになるためです。
Node.js 側の終了コードを取りたいときは、この書き方が必要です。
シークレット未投入でも壊れない graceful skip
監視対象を増やすたびに、全員へシークレットの投入を求めるのは現実的ではありません。
そこでシークレットは任意扱いにし、未設定なら判定スクリプトがスキップを返す設計にしました。
これで本番監視を段階的に有効化できます。
エッジケースのテストも重要です。
CLOUDFLARE_ACCOUNT_ID はあるが CLOUDFLARE_API_TOKEN がない、というシナリオを意図的にテストに書きました。
片方だけ設定されている状態でも、AND 条件でスキップしないと本当の graceful skip になりません。
Issue は upsert にして積み上げを防ぐ
ドリフトが何回かの nightly で連続して検出されると、同じ Issue が毎晩増えてしまいます。
そこで open な Issue があればコメントを追記し、なければ新規起票する upsert にしました。
existing=$(
  gh issue list \
    --repo "$GH_REPO" \
    --label infra \
    --state open \
    --search "Cache config drift" \
    --limit 1 \
    --json number \
    --jq '.[0].number // empty'
)

if [ -n "$existing" ]; then
  gh issue comment "$existing" --repo "$GH_REPO" --body-file "$body_file" || true
else
  gh issue create \
    --repo "$GH_REPO" \
    --label infra \
    --label security \
    --title "Cache config drift detected on ${date_utc}" \
    --body-file "$body_file" || true
fi
// empty は、値が null のときに空文字列を返す jq のイディオムです。
--jq '.[0].number' だけだと null という文字列が返り、bash の -n 判定を通り抜けてしまいます。
つまづきやすいポイント
teeを挟んだときに$?で終了コードを取ってしまい、Node.js 側の失敗を見逃す- jq の
nullが文字列として返り、存在しない Issue にコメントしようとして失敗する - シークレットを片方だけ判定して、片方欠けの状態で API を呼びエラーになる
- ドリフト検出を赤にしてしまい、本物のインフラ障害と区別がつかなくなる
まとめ
外部サービスの設定は、コード管理できない「見えない技術的負債」になりやすい領域です。
nightly で assert を回し、判定ロジックと CI 連携を分離し、終了コードで重大度を使い分けることで、現実的な監視になります。
graceful skip と Issue の upsert を組み合わせれば、段階的に有効化でき、通知も溢れません。
同じ型は Supabase や Stripe など、他の外部サービスの設定にも応用できます。