GitHub Actionsの課金を削る:5秒で終わるjobを減らす「受付job skip」設計と安全に省略するコツ
GitHub Actions の hosted runner は、5〜8秒で終わる job でも1 job あたり1分に切り上げて課金されます。
お気に入りボタンをトグル化する:disabled設計の落とし穴
お気に入り(いいね・ブックマーク)ボタンは、追加だけを実装して「解除」の導線を作り忘れやすい部品です。オンならdisabledにする設計が解除の経路を奪い、recordIdの保持漏れやバージョン切替時の状態引き継ぎ、モックテストでは拾えない回帰も起こります。
cron監視の「どれか1本成功すればOK」をやめる:ジョブごとの死活監視を周期クラスで設計する
定期ジョブの監視を「直近24時間に1件でも成功していれば green」で済ませていませんか。cron式から周期クラスを自動推定し、ジョブごとに適切な期間で成功を評価、失敗原因まで分類するper-cronヘルスチェックの設計を解説します。
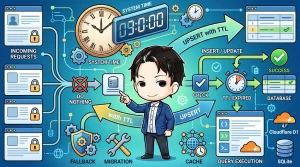
ON CONFLICT DO NOTHINGの排他制御は「一度きり」にしか効かない: TTL付きUPSERTで直す
`INSERT ... ON CONFLICT DO NOTHING` による排他制御は、TTL付きキャッシュと組み合わせると「一度きりのイベント」にしか効かず、キャッシュ切れ後の再実行で永遠に失敗し続ける落とし穴がある。この記事では、実運用で踏んだその問題と、TTLを条件にした条件付きUPSERTによる解決策をコード例とともに解説します。
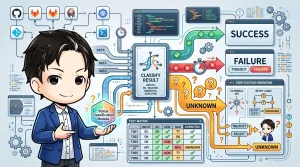
CIの成功判定で「わからない」を握りつぶさない設計
自前のCIディスパッチャやデプロイスクリプトを書いていると、「このジョブは成功と名乗ってよいか」を複数の条件から判定する処理が必ず出てきます。
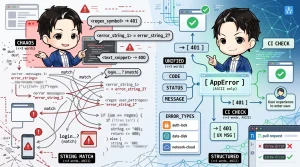
エラーメッセージの文字列判定をやめて、AppErrorに一本化する
エラーメッセージの文言でHTTPステータスを判定する実装は壊れやすいです。code・status・userMessageを持つAppErrorへ一本化し、未分類の例外はfail closedで500に倒し、throw new ErrorをCIで検知する対策を紹介します。
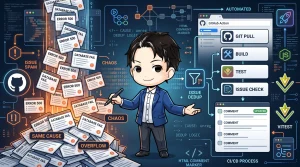
夜間監視の自動起票が『同じ原因なのに量産される』を止めた話
夜間の監視ジョブが失敗するたびにGitHub Issueを自動起票する仕組みは便利ですが、同じ原因の失敗が続くと毎晩issueが積み上がります。本記事では同一原因のopenなissueに追記し、なければ新規作成するdedupロジックで増殖を解消した設計を紹介します。
Playwrightでwebkitだけ落ちるE2Eを直す: cold-load nav-stallをin-contextで復帰させる
Playwrightのnightly E2Eでwebkitだけ失敗する「wedge」状態を、about:blank遷移で復帰させる方法と、flakyと実装バグを機械的に分類しCIノイズを減らす設計を解説します。
Next.js 16 Cache Componentsで踏んだ2つの罠——キャッシュの反映遅延とE2Eの多重ヒット
Next.js 16のCache Componentsで、revalidateTagの反映遅延とPlaywrightのstrict mode違反という2つの不具合に遭遇。原因と対処法(expire:0指定・ロケータのスコープ変更)を整理しました。
CIのクリティカルパスを壊さずにsqliteで時系列メトリクスを蓄積する設計
CIホストのようなインフラでは、「ジョブの取得・解放」や「死活監視」といったクリティカルパスに手を加えるのはとてもリスクが高い作業です。ログに障害の兆候を出力するだけなら簡単ですが、「Dockerイメージの容量が右肩上がりになっていないか」「同時実行の枠が足りているか」といったトレンドを判断するには、時系列で数値を蓄積する仕組みが必要になります。