
はじめに
定期実行している監視スクリプトが、内部で呼ぶ docker や lsof の応答待ちで止まり、後続の失敗検出・GC・メトリクス収集・生存通知まで巻き込んで数時間止まる。実運用しているサービスで、こうした問題に遭遇しました。
ホストが高負荷になると、これらのコマンドは戻らなくなることがあります。タイムアウトの無い直列の cycle では、1 回のハングがそのまま全体の空白になります。
今回は、cycle 全体の上限と個別コマンドの上限を二重に持つ方法を、macOS で動く Bash の実装例とあわせて紹介します。
macOS には timeout(1) が標準では無いため、自前の bounded_run を用意するのがポイントです。
こんな人におすすめ
- cron や launchd で定期実行するシェルスクリプトを運用している方
- macOS 上でセルフホストランナーや監視ジョブを動かしている方
dockerやlsofが高負荷時に戻らず、ジョブが止まった経験がある方timeoutコマンドが使えない環境で、Bash だけで時間制限を付けたい方
何が起きていたのか
直列の cycle では、1 つのコマンドのハングが、無関係な後続タスクの空白になります。
観察された範囲では、30 日間で 12 分を超える空白が 65 回あり、合計で約 32 時間分に達していました。
しかも、どの呼び出しで詰まったかは事後に特定しにくいものです。
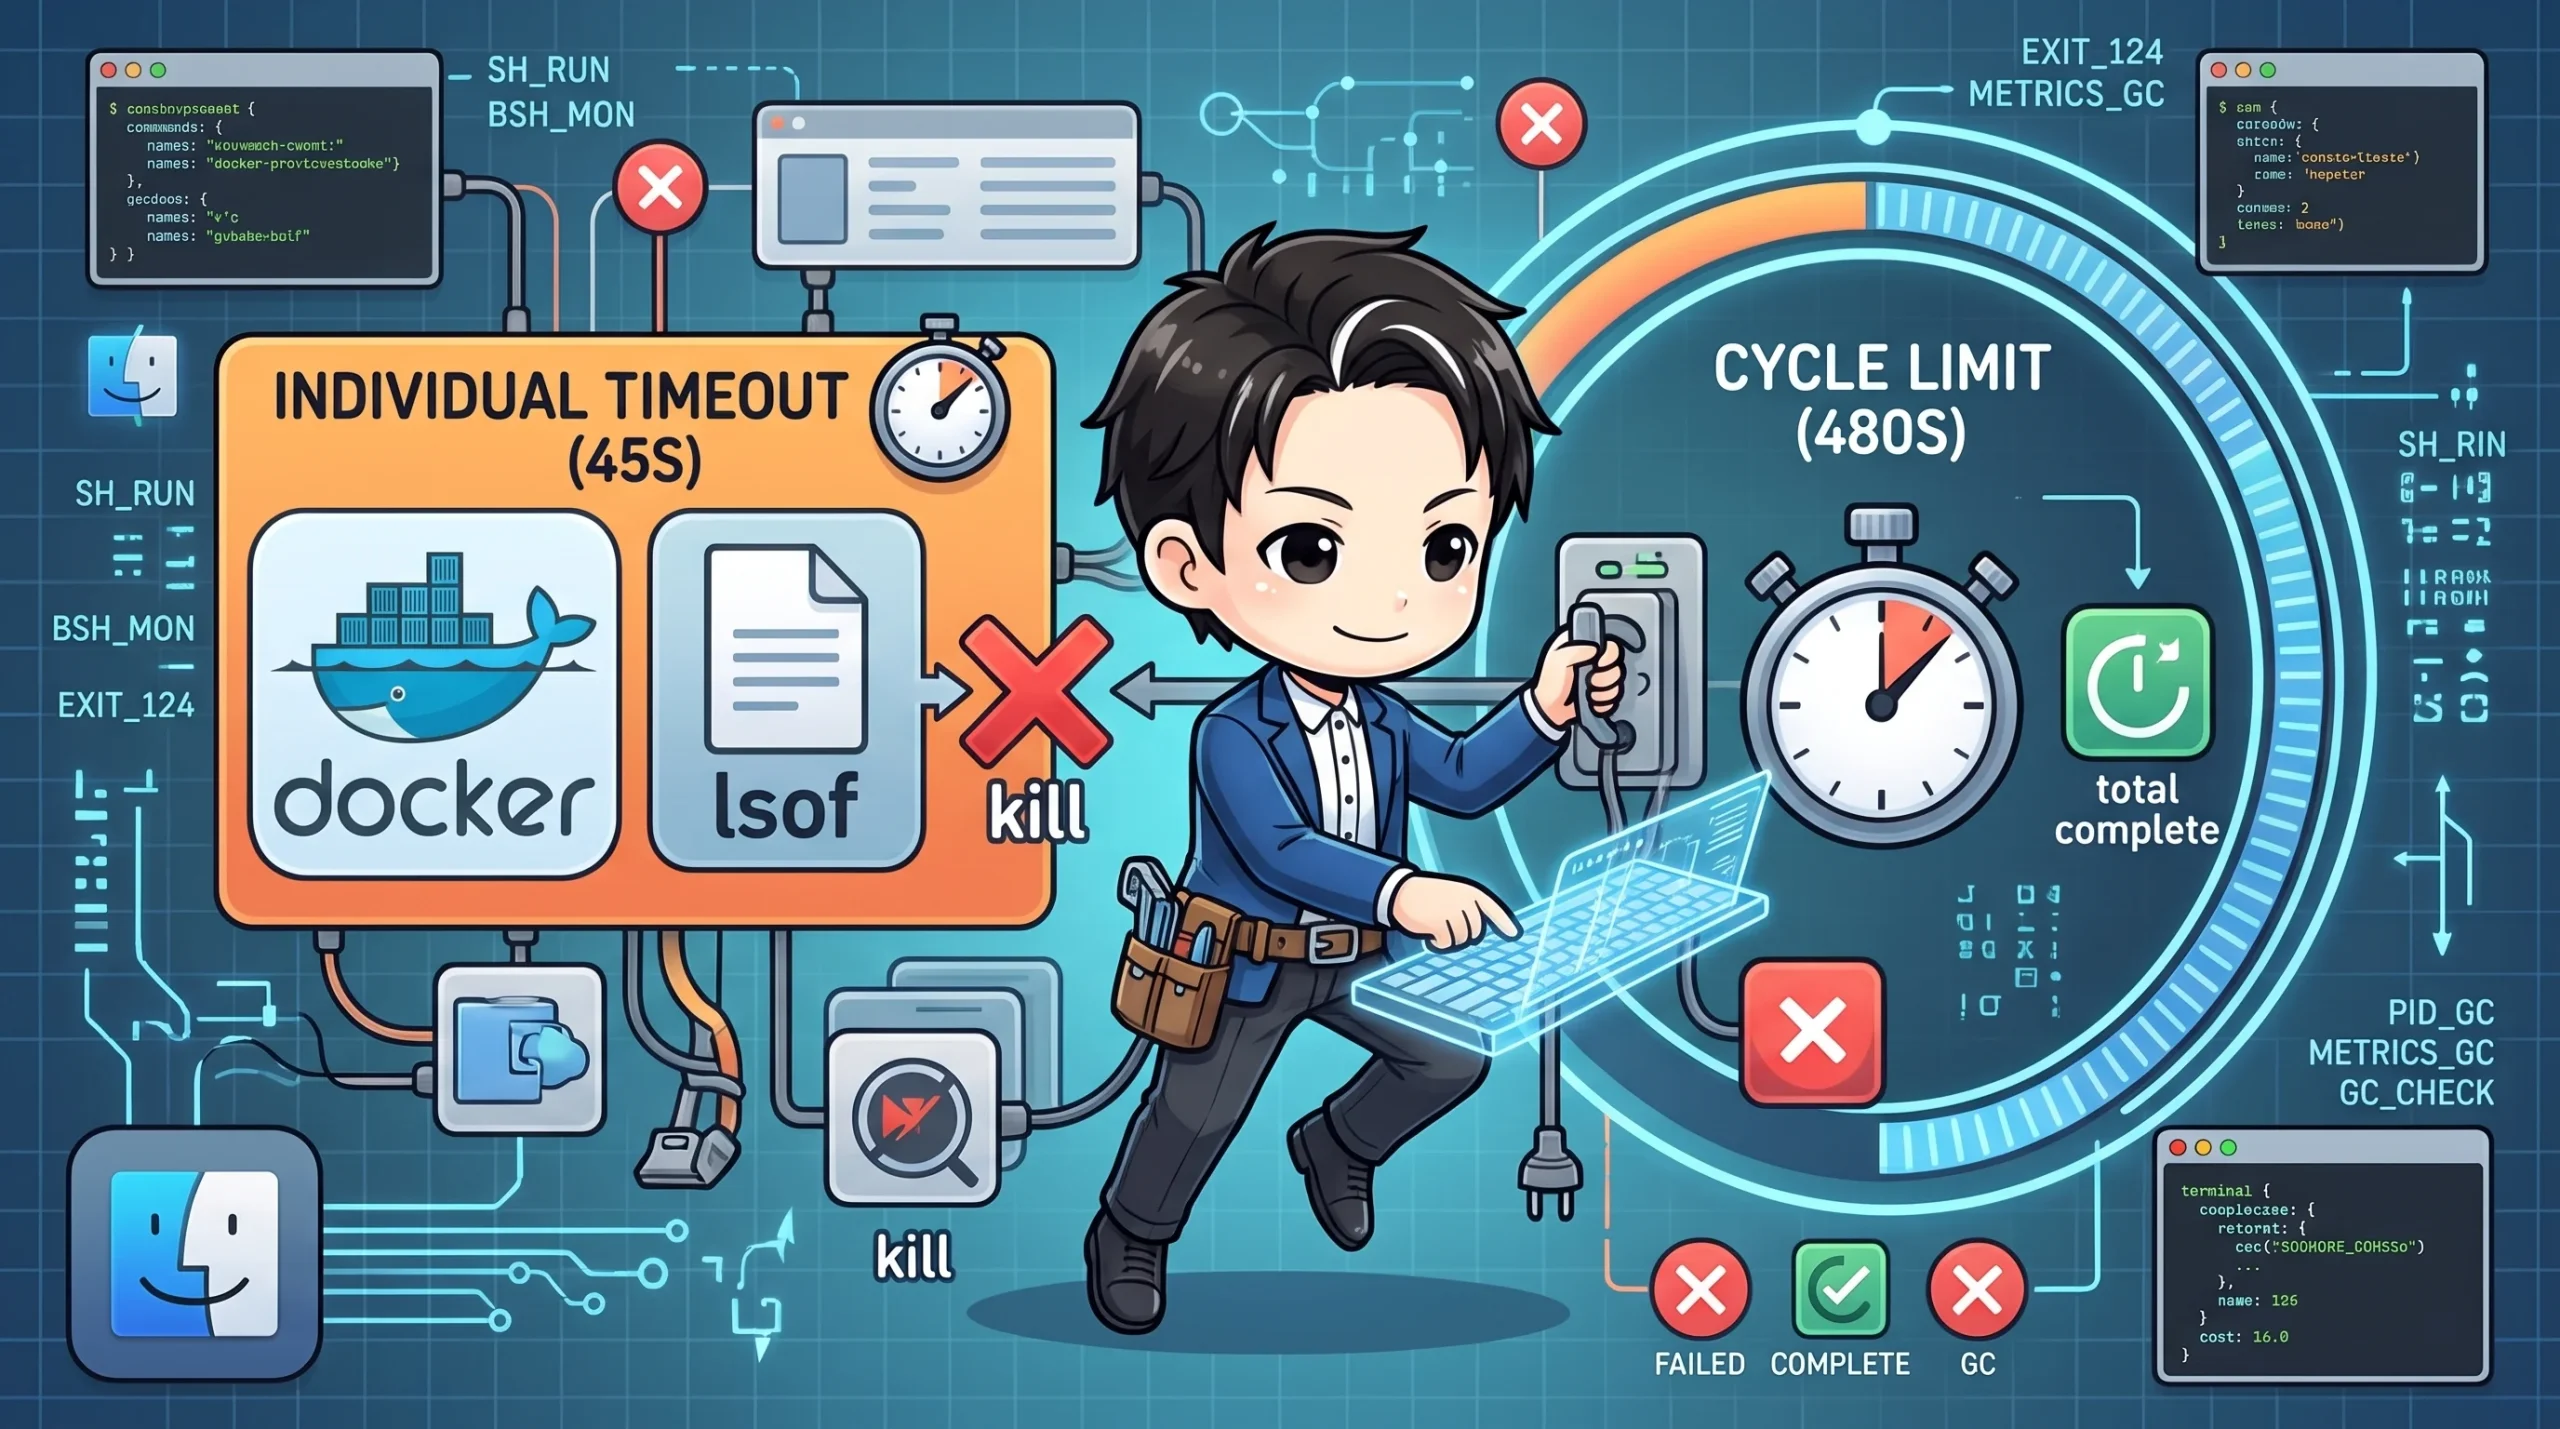
そこで上限は 2 層で持つことにしました。
- cycle 全体の上限(今回は 480 秒)
- 個別コマンドの上限(今回は 45 秒)
どちらか一方だけでは、塞ぎ漏れが出ます。
子孫プロセスごと打ち切る bounded_run
まず、時間制限付きで実行する関数です。
bounded_run() {
  local secs="${1:-}" pid wd rc flag
  shift
  # ...(flag 用の一時ファイルを用意)

  "$@" &
  pid=$!
  (
    i=0
    while [ "$i" -lt "$secs" ]; do
      kill -0 "$pid" 2>/dev/null || exit 0
      sleep 1
      i=$(( i + 1 ))
    done
    kill -0 "$pid" 2>/dev/null || exit 0
    : > "$flag"
    _bounded_kill_tree "$pid"   # 診断を記録 → TERM → 3 秒後に残れば KILL
  ) >/dev/null 2>&1 &
  wd=$!

  wait "$pid" 2>/dev/null; rc=$?
  if [ -e "$flag" ]; then
    wait "$wd" 2>/dev/null || true
    rm -f "$flag"
    return 124
  fi
  kill "$wd" 2>/dev/null || true
  wait "$wd" 2>/dev/null || true
  return "$rc"
}
ポイントは次の 3 つです。
- 打ち切りの有無をフラグファイルで親に伝え、時間切れなら終了コード 124 を返します。
timeout(1)と同じ慣習です - 打ち切る直前に子孫の
ps結果を診断ファイルへ書くので、何で詰まったかを後から追えます - watchdog は
sleep Nを別プロセスで走らせる方式にしません。本体が先に終わるとsleepが孤児として残るためです。1 秒ごとのkill -0ポーリングなら、それを避けられます
既存コマンドをシェル関数で包む
呼び出し側を書き換えずに全呼び出しへ上限を適用するには、同名のシェル関数で上書きします。
CMD_TIMEOUT_S="${HOST_HEALTH_CMD_TIMEOUT_S:-45}"
DOCKER_STUCK=0
# 既に同名の関数が定義済み(テストの差し替え等)なら上書きしない
if ! declare -F docker >/dev/null 2>&1; then
  docker() {
    [ "$DOCKER_STUCK" = "1" ] && return 124
    bounded_run "$CMD_TIMEOUT_S" command docker "$@"
    local _rc=$?
    [ "$_rc" -eq 124 ] && DOCKER_STUCK=1
    return "$_rc"
  }
fi
command docker で自分自身の再帰呼び出しを避け、declare -F でテスト用の差し替えを尊重しています。
さらに、一度打ち切られたら DOCKER_STUCK を立てて、以降の docker 検査は待たずに飛ばします。これで「45 秒 × 検査数」の積み上げを防げます。
出力はパイプでなくファイルで受ける
$(cmd) でコマンド置換をすると、孫プロセスが stdout を握り続けた場合に EOF を待って戻ってきません。
出力をファイル経由にすれば、子孫を回収した時点で確実に戻れます。
BOUNDED_RUN_DIAG_FILE="$HH_DIAG" bounded_run "$HOST_HEALTH_TIMEOUT_S" "$HOST_HEALTH" >"$HH_FILE" 2>&1
HH_RC=$?
HH_OUT="$(cat "$HH_FILE" 2>/dev/null)"
if [ "$HH_RC" -eq 124 ]; then
  HH_TIMED_OUT=1
fi
打ち切った場合は、詰まったプロセスの一覧つきで警告とインシデントを残し、残りの処理は予定どおり進めます。
打ち切った cycle の扱い方
打ち切った cycle の出力は欠けています。そこで次のルールにしました。
- 部分出力から dedup state(解消判定など)を更新しない。次の完走 cycle に任せる
- 完走していないので、生存通知(heartbeat)も出さない
「止まったことを隠さない」ための設計です。
つまづきやすいポイント
- allowlist 方式の分類は列挙漏れで腐ります。 30 日分の誤検知 54 件のうち 52 件が、列挙に無い GUI アプリの helper プロセスでした。「広く拾って、端末やコンテナランタイムなど拾いたくないクラスを除外する」方式にすると、取りこぼしの方向が安全側に倒れます
- 障害時刻をログ行から割り出せません。 各スクリプトのログ行の時刻は開始時刻で固定されるため、詰まった位置が分かりません。メトリクスの欠け、state ファイルの更新時刻、インシデントの記録時刻から逆算しました
- 検証環境の差に注意が必要です。 今回の検証は fixture と Linux 上が中心で、macOS 実機での挙動は継続観測が必要です
まとめ
- 直列 cycle には必ず上限を付けます。1 つのハングが後続の空白になるためです
- 上限は cycle 全体と個別コマンドの 2 層で持ちます
timeout(1)が無い macOS では、kill -0ポーリングの watchdog と子孫ごとの TERM → KILL で自作できます- 出力はファイルで受け、打ち切り時は state を更新せず、診断情報を残します
- 分類ルールは allowlist より「広く拾って除外を引く」方式が安全側です