
はじめに
CIでLighthouseをヘッドレスChromeで回していると、macOS環境でだけNO_FCP(First Contentful Paintが観測できない)エラーが断続的に発生することがあります。ログを見ても、通信エラーやアプリ側の描画バグを示す手がかりは見つかりません。
こういう再現性の低い失敗に出会うと、つい「アプリのどこかが壊れている」と疑ってしまいがちです。しかし今回のケースでは、原因はアプリ側ではなく、macOSがヘッドレスウィンドウを「非可視」扱いにしてVSYNCを止めてしまうという、OS側の既知の挙動でした。この記事では、その原因の切り分け方と、Chromeの起動フラグによる解決方法、そして計測系の不安定なチェックをCI構成レベルでどう扱うかを整理します。
こんな人におすすめ
- CIでLighthouseやその他のパフォーマンス計測をヘッドレスChromeで実行している方
- macOS環境でだけ発生する原因不明のCI失敗に心当たりがある方
- Lighthouse CI(lhci)の設定ファイルでChromeフラグを渡しているが、意図通り反映されているか自信がない方
- ホスト依存で不安定になりやすい検査を、CI構成の中でどう位置づけるか悩んでいる方
NO_FCPは「壊れた」ではなく「見えていない」のサイン
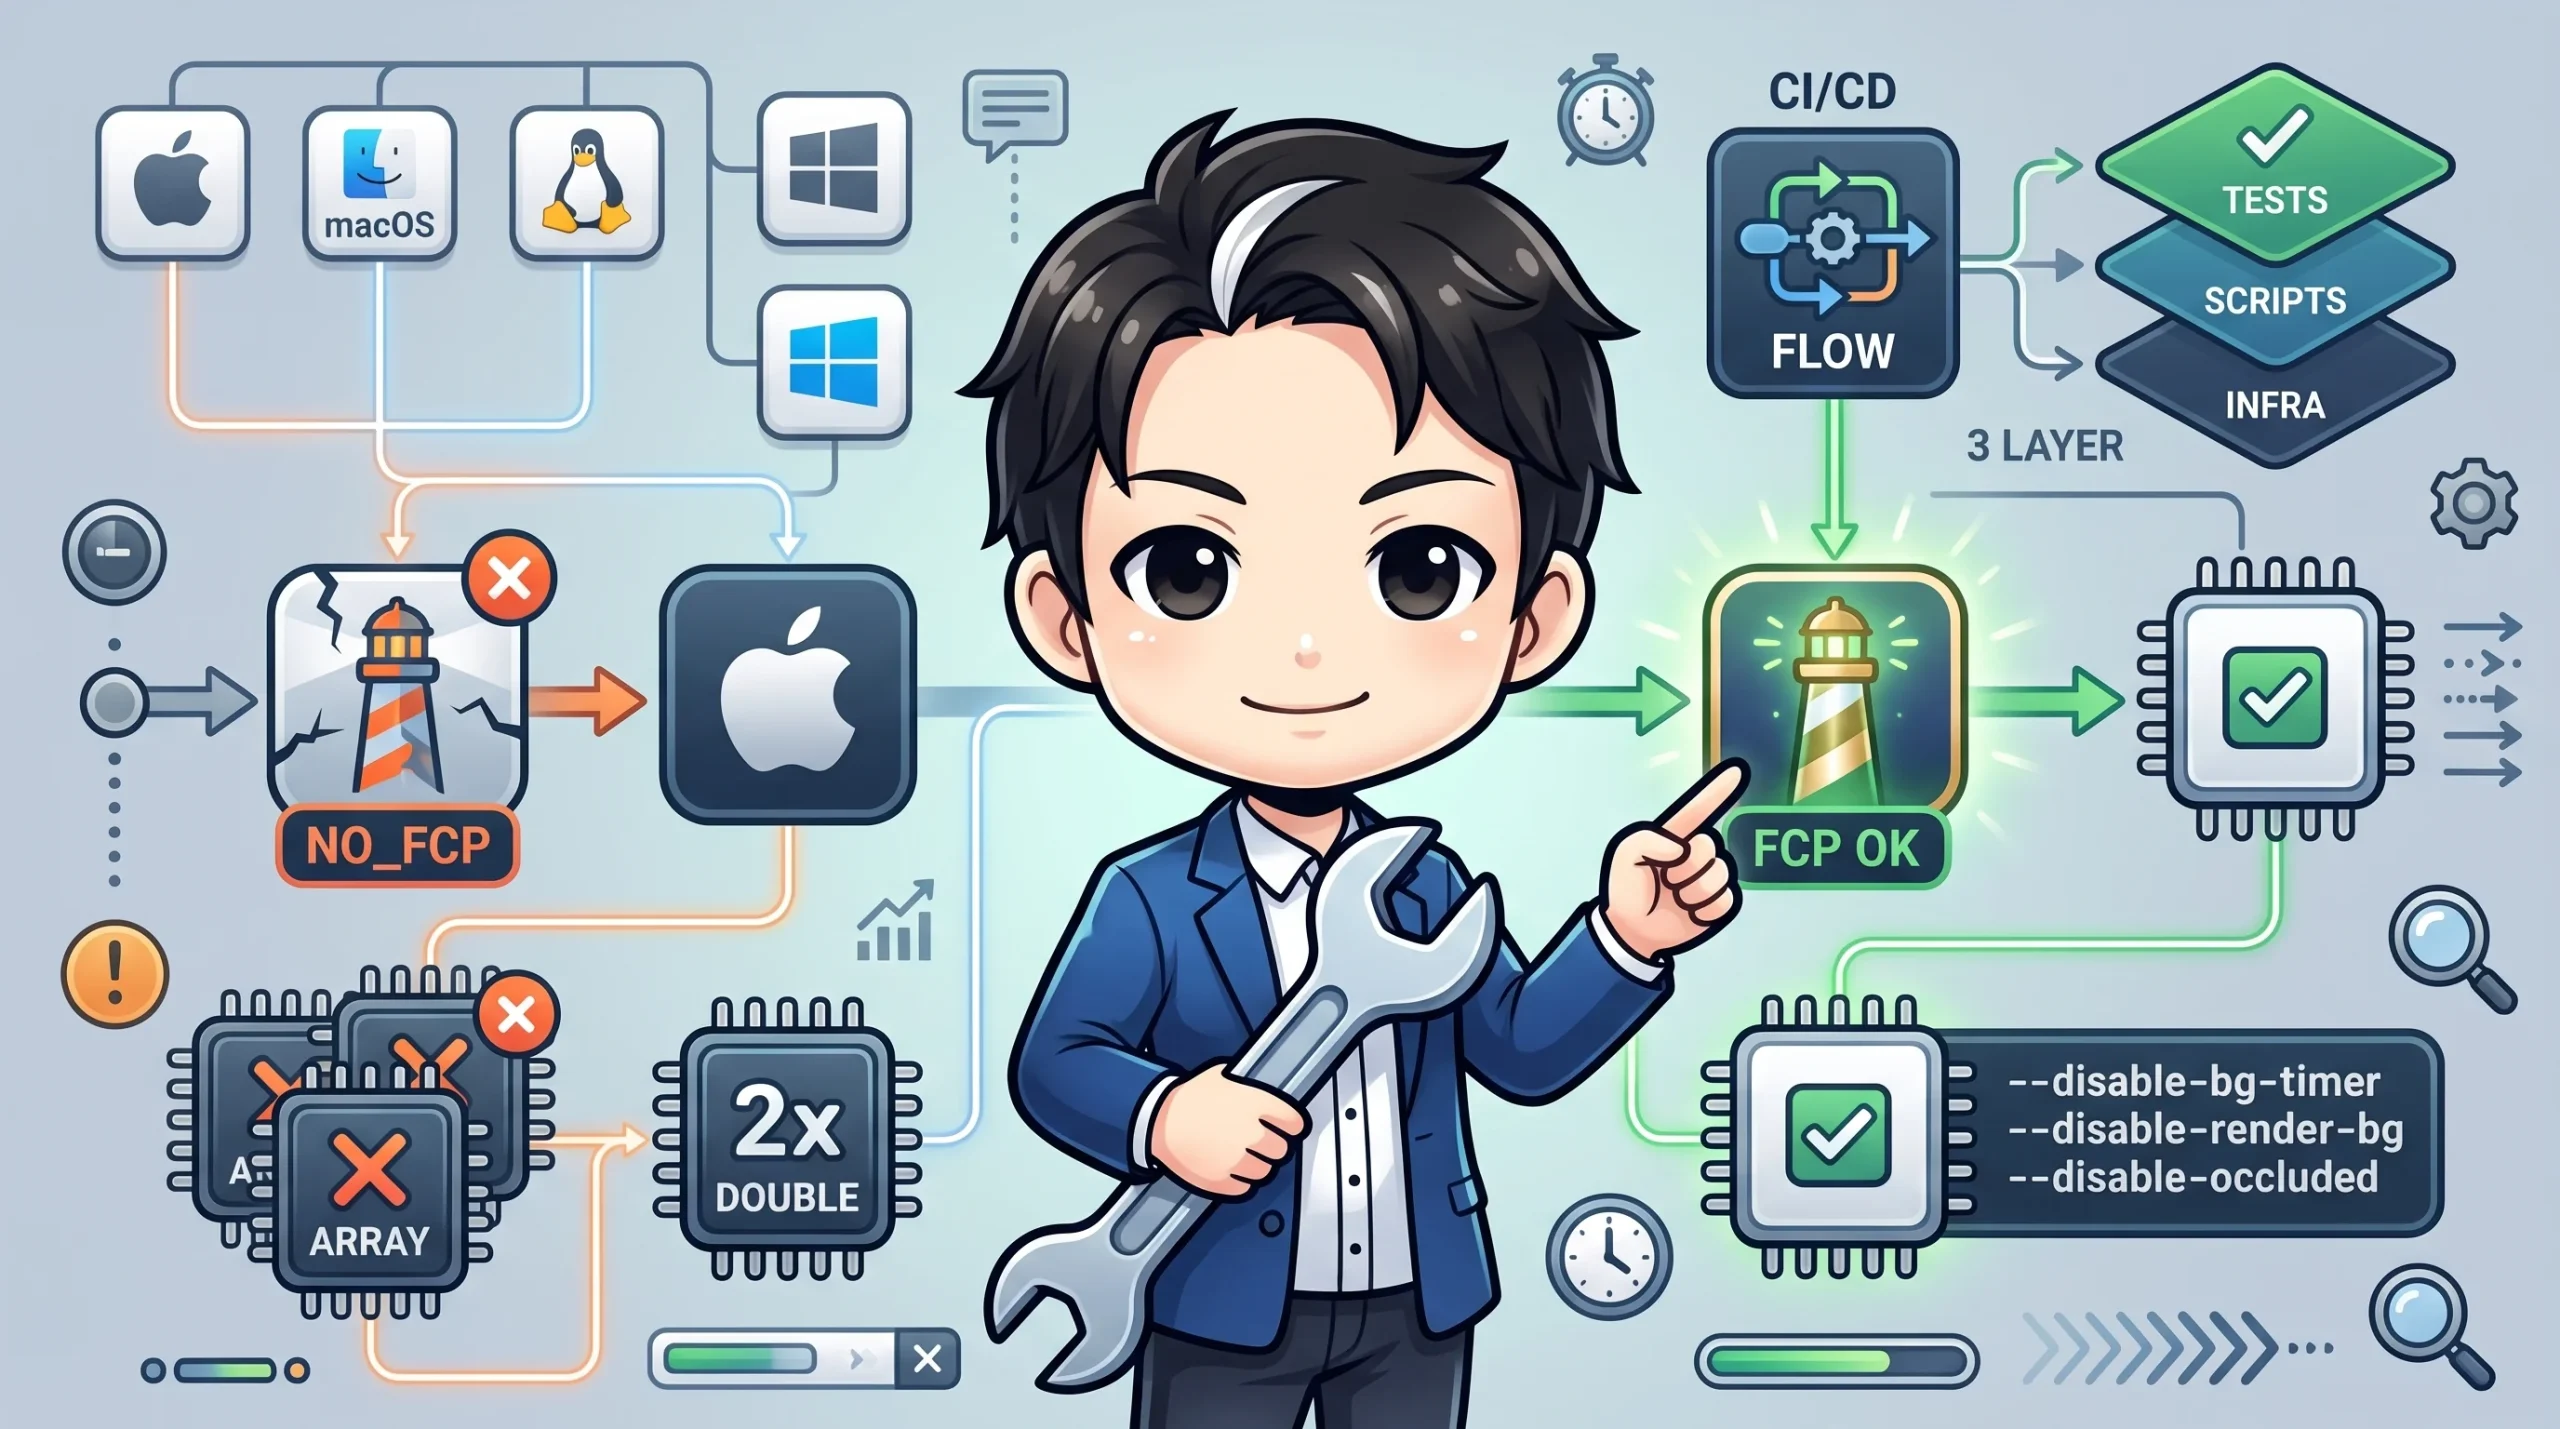
NO_FCPは、ページの内容に問題があるとは限りません。macOSでは、ヘッドレスウィンドウがバックグラウンド扱いになるとレンダリングのタイミングを司るVSYNCそのものが止まり、結果としてFirst Contentful Paintが一切観測されなくなることがあります。
再現性が低く、特定のOSでだけ起きる失敗に遭遇したときは、「アプリ側のロジックのバグ」を疑う前に、「OSやブラウザ側の既知の挙動」を疑ってみる価値があります。原因の階層を間違えると、存在しないバグを延々と探すことになりかねません。
罠1: 起動フラグを配列で渡すと黙って無視される
Chrome側の対処自体はシンプルで、バックグラウンド化を抑止する起動フラグを渡すだけです。ただしLighthouse CI(lhci)では、このchromeFlagsを設定ファイル側で配列として指定すると、エラーも警告もなく黙って無視されるという罠があります。CLI引数として、スペース区切りの1つの文字列で渡す必要があります。
export const SANDBOX_FLAGS = Object.freeze([
  '--no-sandbox',
  '--disable-dev-shm-usage',
])

export const PAINT_FLAGS = Object.freeze([
  '--headless=new',
  '--disable-backgrounding-occluded-windows',
  '--disable-renderer-backgrounding',
  '--disable-background-timer-throttling',
])

export const CHROME_FLAGS = [...SANDBOX_FLAGS, ...PAINT_FLAGS].join(' ')

export function buildCliArgs({ chromeFlags = CHROME_FLAGS } = {}) {
  if (Array.isArray(chromeFlags)) {
    throw new TypeError('chromeFlags は配列にできない。ツール側が無視する。スペース区切りの文字列で渡す。')
  }
  return [`--collect.settings.chromeFlags=${chromeFlags}`]
}
配列を渡そうとしたら例外を投げるようにしておくと、将来誰かが「配列の方が自然だろう」とリファクタリングしても、CIが静かに壊れることを防げます。「配列っぽい設定項目が実は文字列前提」という罠は、lhciに限らず他のCLIラッパーツール全般で起こりうる、汎用的に警戒すべきパターンです。
罠2: フラグの管理場所を二重にしない
--headlessのようなフラグを、設定ファイル側とCLI引数側の両方が持てるツールも少なくありません。両方に値を書いてしまうと、どちらが実際に効いているのか分からなくなり、デバッグの難易度が上がります。
今回は、設定ファイル側にはフラグの存在だけを示すブール値を立て、実際の値の一本化はCLI引数側に寄せました。「どちらが正のフラグ管理者か」を1箇所に決めておくと、後から見た人が迷わずに済みます。
サブプロセス呼び出しを注入可能にしてテストする
Chromeの実行パスを解決する処理は、実際にサブプロセスを起動してみないと正しく動くか確認できない、というのが一見自然な発想です。しかしspawnやexistsを引数として注入できる形にしておけば、実コマンドを一切実行せずにロジック単体をユニットテストできます。
export function resolveChromePath({
  env = process.env,
  spawn = spawnSync,
  exists = existsSync,
} = {}) {
  if (env.CHROME_PATH) return env.CHROME_PATH
  const out = spawn(process.execPath, ['-e', 'console.log(getChromiumPath())'], { encoding: 'utf8' })
  const p = out.status === 0 ? (out.stdout ?? '').trim() : ''
  return p && exists(p) ? p : ''
}
テストではモックしたspawnやexistsを渡すだけでよく、CI環境にChromeが入っているかどうかに依存しない、速くて安定したテストになります。
ホスト依存の検査を3層のCI構成に分離する
パフォーマンス計測やビジュアル回帰テストのように、実行環境のわずかな違いに左右されやすい検査は、毎PRの高速フィードバックループに組み込むと、フレーキーな失敗でチームの信頼を損ないがちです。
今回は、ホスト依存で不安定になりやすい検査を「毎PR実行」から外し、次のような3層構成に整理しました。
- 毎PRの高速フィードバックループ(Fast CI): 静的解析やユニットテストなど、環境差の影響を受けにくい検査のみ
- ローカルで回す重量級CI: パフォーマンス計測やビジュアル回帰など、時間のかかる検査
- 夜間CI: 重量級CIと同じ検査を定期的に流し、劣化を継続的に監視
さらに、依存関係更新など隔離されたサンドボックス環境向けのCIプロファイルでは、ホスト依存の検査をデフォルトで無効化し、明示的な環境変数でしか有効化できないようにしておくと安全側に倒せます。
RUN_HEAVY_CHECK="${RUN_HEAVY_CHECK:-1}"

if [ "$RUN_HEAVY_CHECK" != "0" ]; then
  echo "=== Heavy check ==="
  npm run heavy-check
else
  echo "=== Heavy check (skipped: RUN_HEAVY_CHECK=0) ==="
fi
つまづきやすいポイント
NO_FCPのような描画系エラーは、まずOS・ブラウザ側の既知の挙動を疑う。アプリ側のバグ探しから入ると時間を浪費しやすい- lhciの
chromeFlagsは配列ではなくスペース区切りの文字列で渡す。設定ファイルの型を過信しない - フラグの管理場所(設定ファイル側かCLI引数側か)を1つに決めておかないと、二重付与によるデバッグ地獄にはまりやすい
- 「直った」と判断する前に、疑わしい実行環境で対象の処理を複数回連続実行し、安定性を確認する回帰チェックを、関連ファイル変更時に限定して追加しておくと再発を検知しやすい
まとめ
macOSのヘッドレスChromeで起きるNO_FCPは、コンテンツの不具合ではなくOSのバックグラウンド化挙動が原因であることがあります。原因を切り分けるときは、アプリ層より先にOS・ブラウザ層の既知の挙動を疑う価値があります。
Chromeの起動フラグはツールによって配列指定が無視されることがあるため、実際にCLI引数として何が渡っているかを確認する習慣が有効です。あわせて、ホスト依存で不安定になりやすい検査は、毎PRの高速フィードバックループから切り離し、重量級CIや夜間CIに寄せる構成にすると、開発速度と検査の網羅性を両立しやすくなります。