
はじめに
複数のクライアントサービスが、新しいペイロード形式(認証結果を含む追加フィールド)へ段階的に移行していく場面を考えます。
受信側のログ集約 Worker は、送信側が新フィールドを送り始めた瞬間に、通知の暴発やコストの急増を起こさないようにしておく必要があります。
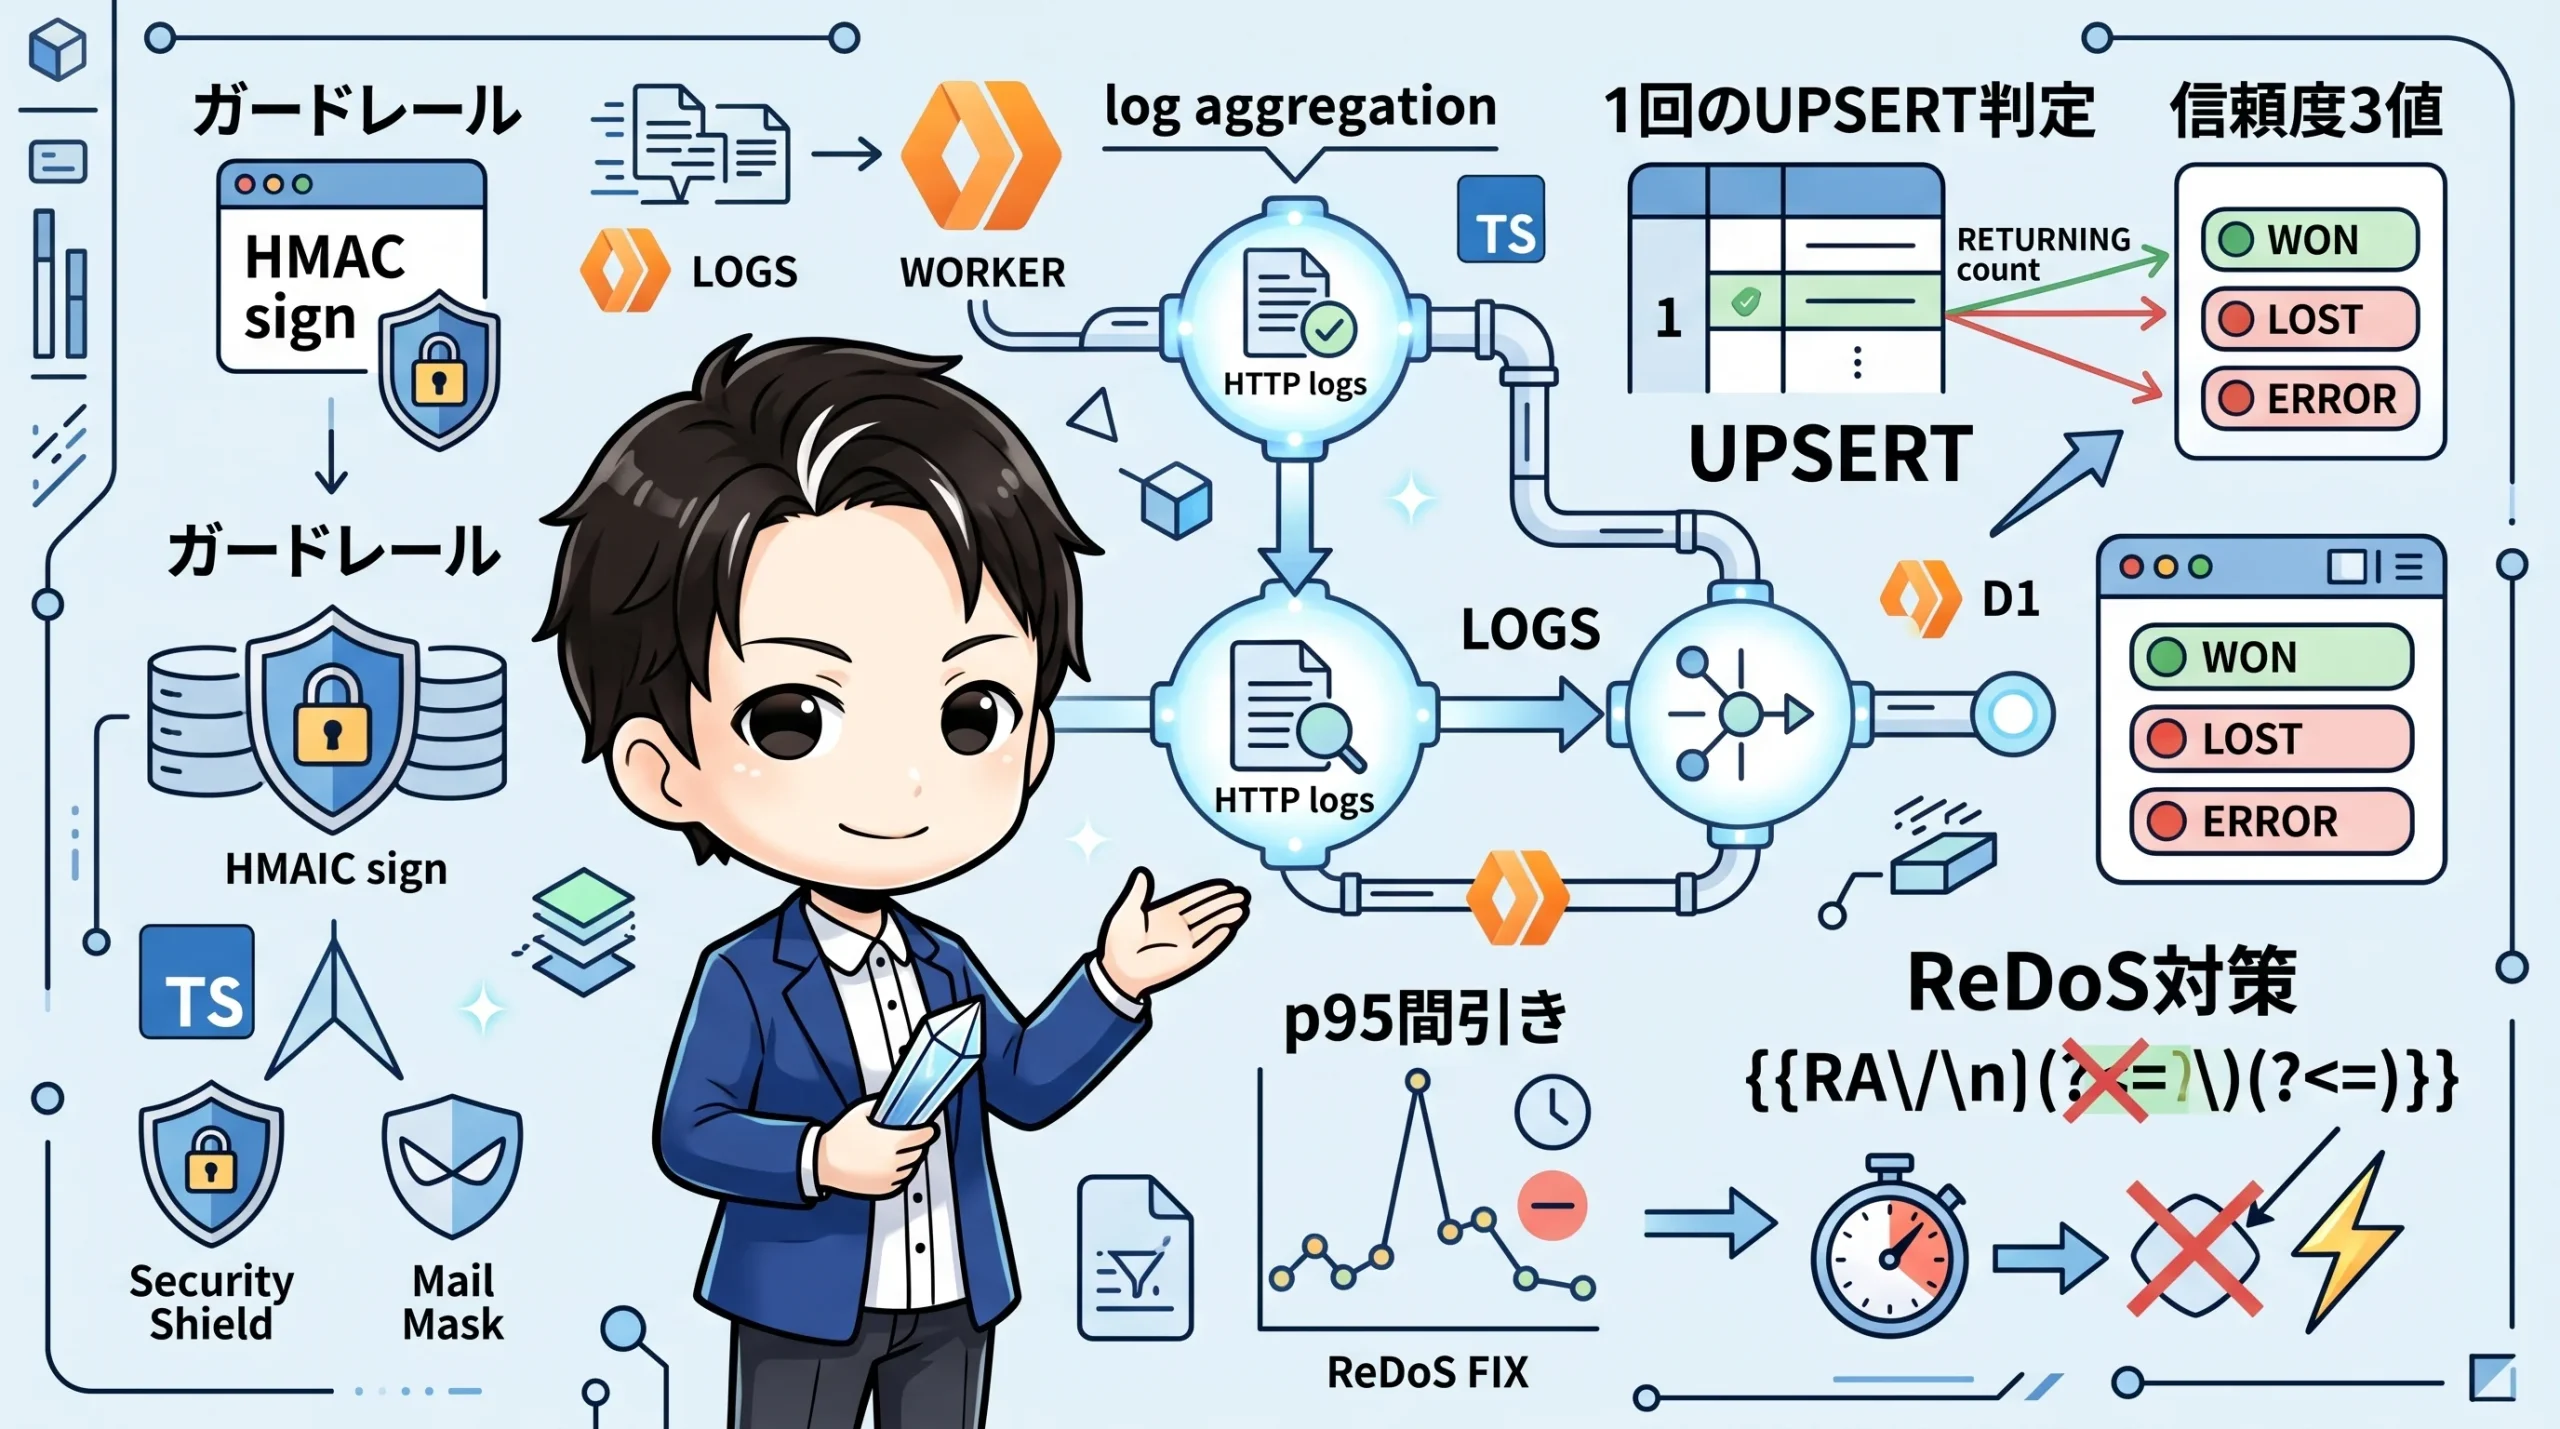
この記事では、まだ誰も新フィールドを送っていない段階で、受信側に先回りして入れたガードレールを4つ紹介します。
Cloudflare Workers と D1 を前提にしていますが、考え方は他の基盤でも使えます。
こんな人におすすめ
- Cloudflare Workers / D1 で通知や集計の仕組みを作っている方
- 署名検証など認証の移行期間をどう安全に乗り切るか悩んでいる方
- 通知のレート制御や重複排除を、並列リクエストでも正確に動かしたい方
- メールアドレスのマスキング用正規表現の性能が気になっている方
先にガードレールを入れる理由
新フィールドを送るクライアントがゼロの段階では、新しいロジックはまだ発火しません。
この時点でレビューを通して穴を塞いでおけば、実トラフィックが流れ始めたときに何も壊れません。
後から直す場合は、本番トラフィックを止めずに修正することになり、難易度が上がります。
1回のUPSERTでカウントと勝者判定を行う
同じ fingerprint の通知を「固定時間窓ごとに最初の1件だけ」に絞りたい場合、キャッシュの当たり外れで判定すると並列リクエストで取りこぼしや二重通知が起きえます。
判定を「その窓の最初の書き込みを勝ち取ったか」に変えると、1クエリで済みます。
export type ClaimOutcome = 'won' | 'lost' | 'error';

export async function claimOrCount(env: StorageEnv, p: ClaimParams): Promise<ClaimOutcome> {
  if (!env.DB) return 'error';
  try {
    const row = await env.DB.prepare(
      `INSERT INTO aggregations
        (fingerprint, source, level, message, first_seen, last_seen, count)
       VALUES (?, ?, ?, ?, ?, ?, 1)
       ON CONFLICT(fingerprint) DO UPDATE SET count = count + 1, last_seen = excluded.last_seen
       RETURNING count`,
    )
      .bind(p.fingerprint, p.source, p.level, p.message.slice(0, 500), p.timestamp, p.timestamp)
      .first<{ count: number }>();
    return row?.count === 1 ? 'won' : 'lost';
  } catch (err) {
    console.error('storage.claimOrCount failed', err instanceof Error ? err.message : err);
    return 'error';
  }
}
RETURNING count が 1 なら、行を作ったのは自分です。
別テーブルでロックを取らなくても、勝者が1件に決まります。
20並列でリクエストを投げても通知が1件になることを、テストで確認しておくと安心です。
DBエラーは「勝者扱い」にしない
ここで重要なのが、catch 節で 'error' を返し、呼び出し側で敗者と同じに扱う点です。
「エラーなら通知側に倒す」設計は一見安全に見えます。
しかし DB の読み取り上限に近づいてエラーが連発すると、全リクエストが勝者になり、通知と起票を延々と繰り返しかねません。
通知を漏らさないか、暴発させないかはトレードオフです。
この構成では、暴発するよりも静かに失敗する方を選びました。
信頼度を3値の型で分ける
署名必須化が完了していない移行期間中は、未署名のリクエストも受け付けることになります。
その状態で「1件で即アラート」のような強いアクションを許すと、未署名リクエストに誤発火されえます。
そこで認可結果を型で3段階に分けます。
/**
 * - `verified`: 署名を検証できたリクエスト
 * - `grace`: 受け付けるが署名を検証していないリクエスト(移行期間中の互換モード)
 * - `unauthorized`: 拒否するリクエスト
 */
export type AuthResult = 'verified' | 'grace' | 'unauthorized';
即時通知や閾値判定は verified にだけ効かせ、grace は集計に数えるだけにします。
「このアクションはどのレベルまで許すか」が各分岐に明示的に残るので、後から読んでも意図が追えます。
パーセンタイル計算を間引く
p95 のようなレイテンシ指標を、サンプルが届くたびに全件ソートして計算すると、サンプル数が増えるほど読み取りコストが二乗で膨らみます。
今回のケースでは、1窓1,000件のシナリオで約100万行を読んでいました。
次の条件に絞って計算すると、読み取りは約2,600行まで下がりました。
// 通知済みの窓では計算しない。標本数がちょうど最小閾値に達したとき、
// または上限を超える標本が来たときだけ p95 を計算する。
// 上限以下の標本を1つ足しても nearest-rank の p95 は上限を超えないため、
// 毎回計算する必要がない。
加えて、窓ごとのサンプル保存件数に上限を設けています。
数値はこの構成での観察結果であり、環境によって変わる点にご注意ください。
メールマスキング正規表現にlookbehindを足す
ログ中のメールアドレスをマスクする正規表現が、@ を含まない長い文字列に対して遅くなる問題がありました。
開始位置ごとにローカル部(最大64文字)を読み直すためです。
マスクされるべき文字列の先頭部分が漏れる余地も残っていました。
// Before: 開始位置ごとにローカル部を読み直していた
/[\p{L}\p{N}._%+-]{1,64}@[\p{L}\p{N}-]{1,63}(?:\.[\p{L}\p{N}-]{1,63}){0,8}\.\p{L}{2,24}(?![\p{L}\p{N}])/gu

// After: 後読みで「対象文字列の先頭」からだけ照合を始める
/(?<![\p{L}\p{N}._%+-])[\p{L}\p{N}._%+-]{1,100000}@[\p{L}\p{N}-]{1,63}(?:\.[\p{L}\p{N}-]{1,63}){0,8}\.\p{L}{2,24}(?![\p{L}\p{N}])/gu
パターンの先頭に「直前が対象文字でない」ことを要求する後読みを足すと、各連続区間での照合は先頭の1回だけになります。
線形時間を保ったまま、区間全体を正確にマッチさせられます。
マスキングやバリデーション用の正規表現全般に使える考え方です。
つまづきやすいポイント
- ロールバックしても元に戻らないことがある: 新経路は「初回書き込みだけを勝者にする」方式で行を作ります。ロールバック後に旧経路の「重複なら何もしない」UPSERT へ戻ると、その fingerprint は旧経路ではずっと敗者になり、通知されません。書き込み戦略が非対称な場合は、運用ドキュメントに明記しておきましょう。
graceを通知に混ぜない: 集計に数えるのと、通知を鳴らすのとは別の判断です。型で分けても、分岐側でverifiedの確認を忘れると意味がなくなります。- 間引きの条件を厳密に考える: 「上限以下のサンプルを足しても p95 は変わらない」といった根拠がないまま間引くと、異常値の見逃しにつながります。
まとめ
移行期間の受信側では、次の4点を先に固めておくと安全です。
- 1回の UPSERT で勝者判定とカウントを同時に行い、DB エラーは敗者として扱う
- 認可結果を
verified/grace/unauthorizedの型で分け、強いアクションは検証済みに限定する - p95 などの重い計算は、必要なタイミングだけに間引く
- 正規表現には lookbehind を足して、開始位置の重複走査を防ぐ
まだ誰も使っていないうちに入れておくのが、いちばん安く済みます。