
はじめに
認証Providerに障害が起きているとき、期限切れトークンを持つリクエストが来るたびにリフレッシュを送っていないでしょうか。
Providerの回復を遅らせるだけでなく、レート制限まで招いて「障害が復旧しても締め出される」状態になりかねません。
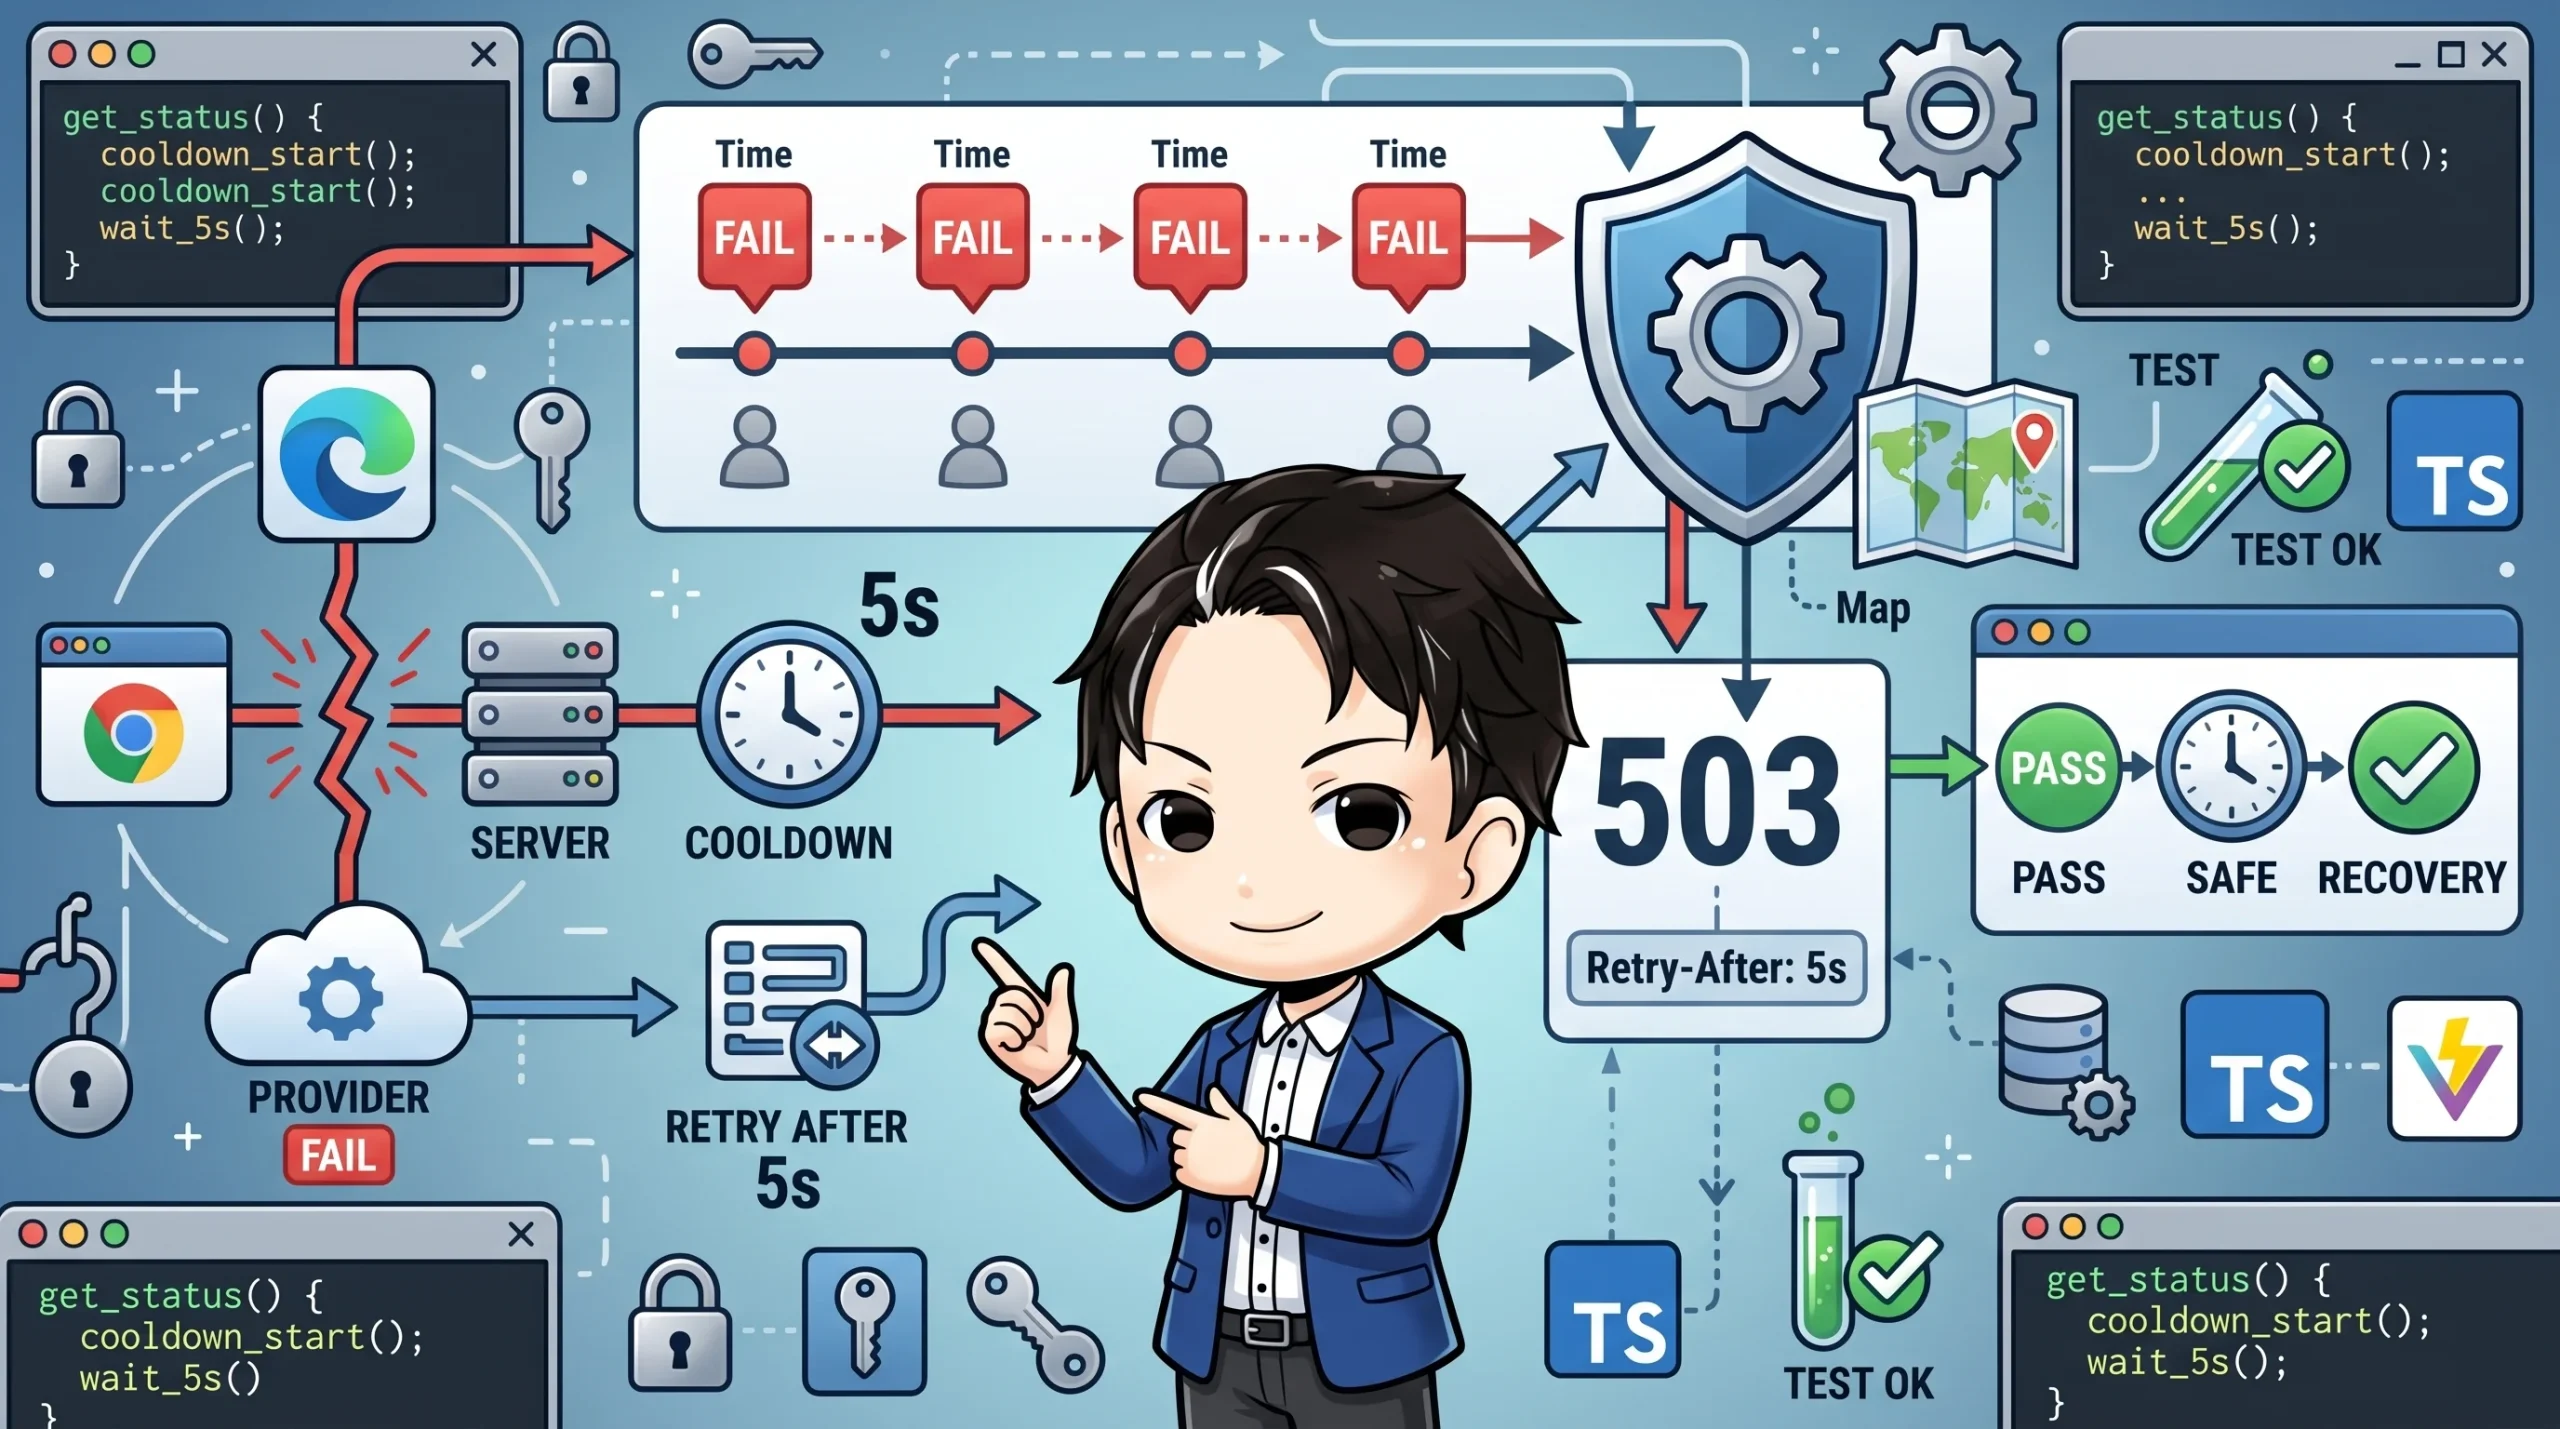
この記事では、セッション単位の「クールダウン」を入れ、一時的な失敗の直後はProviderを叩かずに retryAfterSeconds 付きの503を返すパターンを紹介します。
あわせて、エラーの診断文字列から内部情報が漏れないようにする小さな修正も扱います。
コードはTypeScriptで、そのまま持ち込める形にしています。
こんな人におすすめ
- 外部の認証Providerとトークンリフレッシュで連携しているバックエンド開発者
- 障害時にリトライが障害を悪化させた経験がある方
Retry-Afterをどう設計すればよいか迷っている方- 例外メッセージやログへの情報漏洩が気になる方
単一フライトだけでは足りない理由
同一セッションの同時リフレッシュを1本にまとめる「単一フライト」は、よく使われる対策です。
ただ、これが畳めるのは「同時」に来たリクエストだけです。
障害中は、リクエストが少しずつずれて逐次的に届きます。
1本目が失敗して完了した直後に2本目が来れば、また新しいリフレッシュがProviderへ飛びます。
時間方向にも間引く仕組みが別に必要で、それがクールダウンです。
クールダウンの実装
セッションIDごとに「いつまで待つか」を Map に持ちます。
時計は now() として注入しておくと、テストで時刻を自由に進められます。
const COOLDOWN_PRUNE_THRESHOLD = 1000;

class SessionRefresher {
  private cooldownUntilMs = new Map<string, number>();

  constructor(
    private temporaryFailureCooldownMs = 5000,
    private now: () => number = Date.now,
  ) {
    // 負値は 0(無効)に丸める
    this.temporaryFailureCooldownMs = Math.max(0, temporaryFailureCooldownMs);
  }

  private startCooldown(sessionId: string): number | undefined {
    if (this.temporaryFailureCooldownMs === 0) return undefined;
    const nowMs = this.now();
    if (this.cooldownUntilMs.size >= COOLDOWN_PRUNE_THRESHOLD) {
      for (const [id, until] of this.cooldownUntilMs) {
        if (until <= nowMs) this.cooldownUntilMs.delete(id);
      }
    }
    this.cooldownUntilMs.set(sessionId, nowMs + this.temporaryFailureCooldownMs);
    return Math.ceil(this.temporaryFailureCooldownMs / 1000);
  }

  private cooldownRemainingSeconds(sessionId: string): number | undefined {
    const until = this.cooldownUntilMs.get(sessionId);
    if (until === undefined) return undefined;
    const remainingMs = until - this.now();
    if (remainingMs <= 0) {
      this.cooldownUntilMs.delete(sessionId);
      return undefined;
    }
    return Math.ceil(remainingMs / 1000);
  }
}
ポイントは次の3つです。
Math.ceilで切り上げる: 残り0.4秒でも「0秒後に再試行」ではなく1秒と伝えられます。Retry-Afterにそのまま写せる1以上の整数になります。- 掃除は書き込み時だけ: タイマーを持たず、件数が閾値(ここでは1,000)を超えたときに期限切れを消します。軽量で、プロセス終了時の後始末も要りません。
0で無効化できる: 設定で無効にすれば従来どおり毎回送ります。段階的に導入するときに便利です。
失敗の種類で扱いを分ける
クールダウンを入れるときに大事なのは、すべての失敗を同じに扱わないことです。
| 失敗の種類 | セッション | クールダウン |
|---|---|---|
| 失効が確定(トークンが通らない) | 破棄 | 消す |
| 障害・レート制限・原因不明 | 残す | 開始する |
「分からない失敗では捨てない」が方針です。
原因不明の失敗でセッションを破棄すると、Providerの障害時に全ユーザーが一斉ログアウトになってしまいます。
const waitSeconds = this.cooldownRemainingSeconds(sessionId);
if (waitSeconds !== undefined) {
  // クールダウン中は Provider にも失効チェックの DB にも送らない
  throw new SessionRefreshError('temporarily_unavailable', 'refresh is cooling down', {
    retryAfterSeconds: waitSeconds,
  });
}

try {
  await this.refreshWithProvider(sessionId);
} catch (err) {
  if (isTerminalRefreshFailure(err)) {
    this.cooldownUntilMs.delete(sessionId); // 失効確定: 待ちは使わない
    this.options.store.destroy(sessionId);
    throw new SessionRefreshError('session_expired', 'session is no longer valid');
  }
  const retryAfterSeconds = this.startCooldown(sessionId);
  throw new SessionRefreshError('temporarily_unavailable', 'refresh failed temporarily', {
    cause: err,
    ...(retryAfterSeconds !== undefined ? { retryAfterSeconds } : {}),
  });
}
HTTP層では、この例外を503に変換し、retryAfterSeconds を Retry-After ヘッダーへ写します。
診断文字列に String(err) を入れない
もう一つの修正は、エラーの診断情報(diagnostic)です。
ネットワーク例外のメッセージには、接続先のホスト名や名前解決に失敗した名前が含まれることがあります。
String(err) をそのままログや診断に入れると、内部情報が外へ出ます。
識別子として十分な情報だけに絞ります。
diagnostic: `network_error name=${err instanceof Error ? err.name : typeof err}`,
network_error name=TypeError のように型名だけなら、原因の切り分けには足り、内部情報は含まれません。
詳細が必要な場合は、アクセス制御された別の場所に cause として保持する形が安全です。
時刻を進めてテストする
now() を注入できる、または偽タイマーが使えると、「直後は503、待ちが明けたら回復」を短いテストで確認できます。
Vitestの例です。
it('クールダウン中は 503、明けたら回復する', async () => {
  vi.useFakeTimers();
  providerDown();

  expect(await service.me(sessionId)).toEqual({
    status: 503,
    error: 'session_refresh_unavailable',
  });

  providerRecovered();
  vi.setSystemTime(Date.now() + 6_000); // 既定 5 秒を超える
  expect(okOf(await service.me(sessionId)).view.appUserId).toBe(expectedUser);
});
加えて、クールダウン中にProviderへの呼び出し回数が増えないことも検証しておくと、狙いどおりに間引けていることが確認できます。
つまづきやすいポイント
- 同時リクエストだけ畳んで満足する: 逐次リクエストは単一フライトをすり抜けます。時間方向のクールダウンを別に用意してください。
- 一時失敗でセッションを破棄する: 一斉ログアウトの原因になります。失効が確定した失敗だけを破棄の対象にします。
- 待ち時間が0秒になる: 切り捨てると
Retry-After: 0になり、クライアントが即座に再試行します。切り上げて1以上にします。 - クールダウン記録が増え続ける: セッションごとの
Mapは放置するとメモリを食います。掃除の仕組みを入れてください。なお記録はプロセスローカルなので、複数インスタンス構成では各インスタンスが別々に待つ点も把握しておく必要があります。
まとめ
認証Providerの障害中は、リフレッシュを減らすことが最大の協力になります。
単一フライトに加えてセッション単位のクールダウンを入れ、retryAfterSeconds 付きの503でクライアントに待ち時間を伝えましょう。
失敗の種類で破棄と継続を分けること、診断文字列から内部情報を除くことも、同時に押さえておきたい点です。