
はじめに
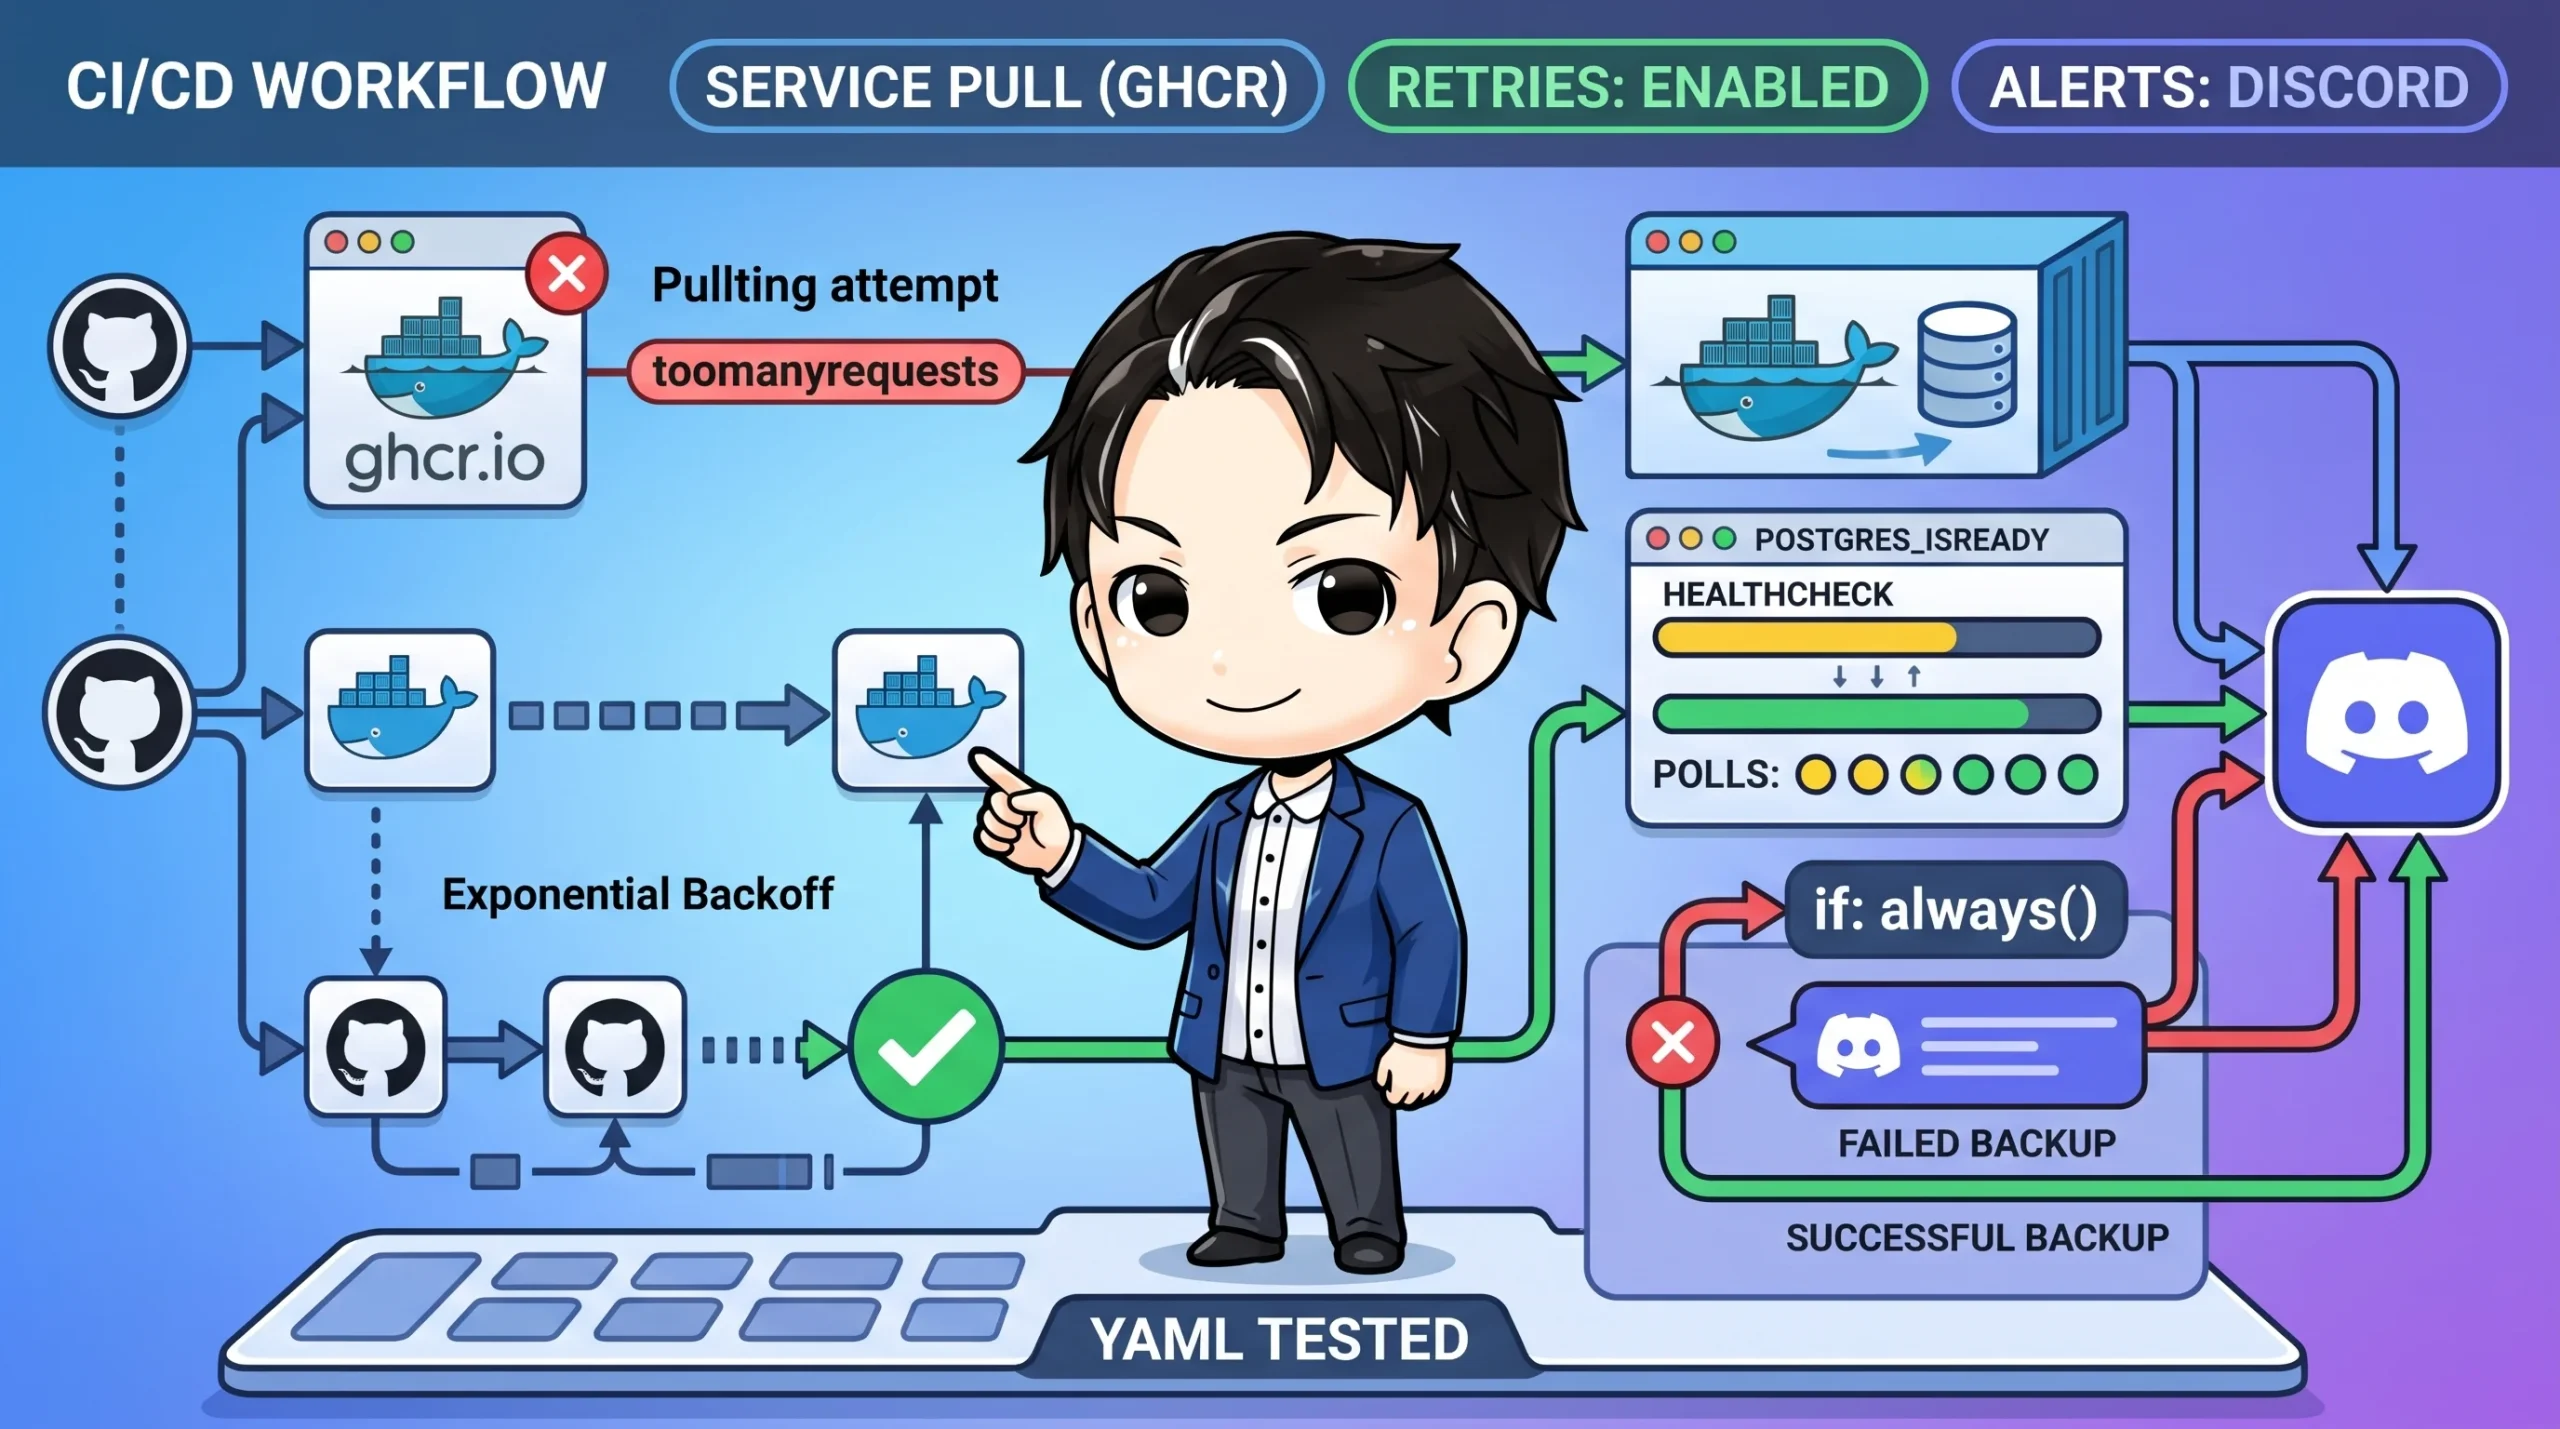
GitHub Actions の services: でコンテナレジストリ(ghcr.io)から Postgres イメージを取得していると、pull はジョブ初期化時に1回だけ実行されます。
再試行の仕組みはありません。
一時的なレート制限(toomanyrequests)に当たると、本体の処理に到達する前にジョブが落ちます。
実運用しているサービスの日次バックアップでは、これが起きました。
しかも失敗時の通知経路がなく、バックアップが丸ごと静かに失敗していました。
この記事では、次の2点で解決した方法を紹介します。
services:をやめて、通常の step でdocker pullを指数バックオフ付きで再試行し、docker runで起動する- 通知 job を
if: always()にして、失敗・キャンセル時も通知する
こんな人におすすめ
- GitHub Actions の
services:が pull 失敗で落ちた経験がある人 - 定期実行のバックアップや復元検証を CI で回している人
- 「失敗時だけ通知」を安全に組みたい人
- ワークフロー YAML の退行をテストで防ぎたい人
なぜ services: では吸収できないのか
services: はランナーがコンテナを起動してくれる便利な機能です。
一方で、pull の再試行回数や待ち時間を制御する手段がありません。
レジストリ起因の一時障害を吸収したいなら、step に降ろして自前でリトライするのが確実です。
その代わり、services: が裏でやってくれていた次の処理も自分で書く必要があります。
- ヘルスチェック(起動完了の待機)
- 後始末(コンテナの削除)
pull を指数バックオフで再試行する step
最大5回、初期待機30秒、失敗ごとに2倍(30→60→120…)にします。
最終試行では待たずに ::error:: を出して即終了します。
- name: Start restore-check Postgres
  env:
    RESTORE_CHECK_IMAGE: ghcr.io/example/postgres:17.x
    RESTORE_CHECK_CONTAINER: restore-check-db
  run: |
    set -euo pipefail
    docker rm -f "$RESTORE_CHECK_CONTAINER" 2>/dev/null || true

    max_attempts=5
    delay_seconds=30
    for attempt in $(seq 1 "$max_attempts"); do
      if docker pull "$RESTORE_CHECK_IMAGE"; then
        break
      fi
      if [ "$attempt" -eq "$max_attempts" ]; then
        echo "::error::image pull failed after ${max_attempts} attempts"
        exit 1
      fi
      sleep "$delay_seconds"
      delay_seconds=$((delay_seconds * 2))
    done
開始前に docker rm -f しておくと、同じランナー上での再実行にも強くなります。
最終試行のあとに無駄に待たないのもポイントです。
ヘルスチェックを自前で再現する
pull のあとは docker run で起動し、--health-* オプションを付けます。
さらに pg_isready を最大60回×5秒でポーリングして、起動完了を待ちます。
ready=0
for wait_attempt in $(seq 1 60); do
  if docker exec "$RESTORE_CHECK_CONTAINER" pg_isready -U postgres -d postgres >/dev/null 2>&1; then
    ready=1
    break
  fi
  sleep 5
done
if [ "$ready" -ne 1 ]; then
  docker logs "$RESTORE_CHECK_CONTAINER" || true
  exit 1
fi
タイムアウト時に docker logs を出しておくと、原因調査がかなり楽になります。
ready を事前に初期化しておくのも忘れないでください。set -u 下では未定義変数の参照でエラーになります。
後始末は if: always() の step で行います。
- name: Cleanup restore-check Postgres
  if: always()
  run: docker rm -f restore-check-db || true
失敗時だけ通知する設計
もう1つの問題は、失敗が誰にも伝わらなかったことです。
通知 job を if: always() にして、job の結果に応じて status を切り替えます。
notify:
  needs: backup
  if: always()
  uses: ./.github/workflows/_notify-discord.yml
  with:
    status: ${{ needs.backup.result == 'success' && needs.backup.outputs.sanity_status || needs.backup.result }}
    notify_on_success: false
成功時は出力値(警告判定など)を、それ以外は job の結果(failure / cancelled)を渡します。
notify_on_success: false を維持すれば、正常時の通知ノイズは増えません。
ワークフロー YAML 自体をテストで固定する
設定の退行を防ぐため、YAML をパースして次の点を検証するテストを置きました。
notify.ifがalways()であることstatus式が意図どおりであることservicesが存在しないこと- 再試行 step が存在し、パラメータが想定どおりであること
CI の設定は壊れても気づきにくいので、この種のテストは費用対効果が高いと感じます。
つまづきやすいポイント
a && b || cは b が空文字だと c に落ちます。成功時の出力が空になりうる場合、意図しないステータスが通知に渡ります。出力が必ず非空になるようにするか、式を見直してくださいservices:を外すと後始末が自動で行われません。docker rm -fをif: always()の step に入れ忘れると、ランナーにコンテナが残ります- 最終試行でも
sleepしてしまうと、失敗確定までの時間が無駄に延びます。最終試行は待たずに終了させましょう - 通知 job の
if: always()は、キャンセル時も実行されます。通知先に流したくない場合は条件を調整してください
まとめ
services: の pull は再試行できないため、一時的なレート制限でジョブが落ちることがあります。
step に降ろして指数バックオフで再試行し、ヘルスチェックと後始末も自前で書くことで吸収できます。
あわせて、通知 job を if: always() にして失敗時に確実に気づける状態にしておくと、静かな失敗を防げます。
ワークフロー YAML をテストで固定しておけば、設定の退行も防げます。