
はじめに
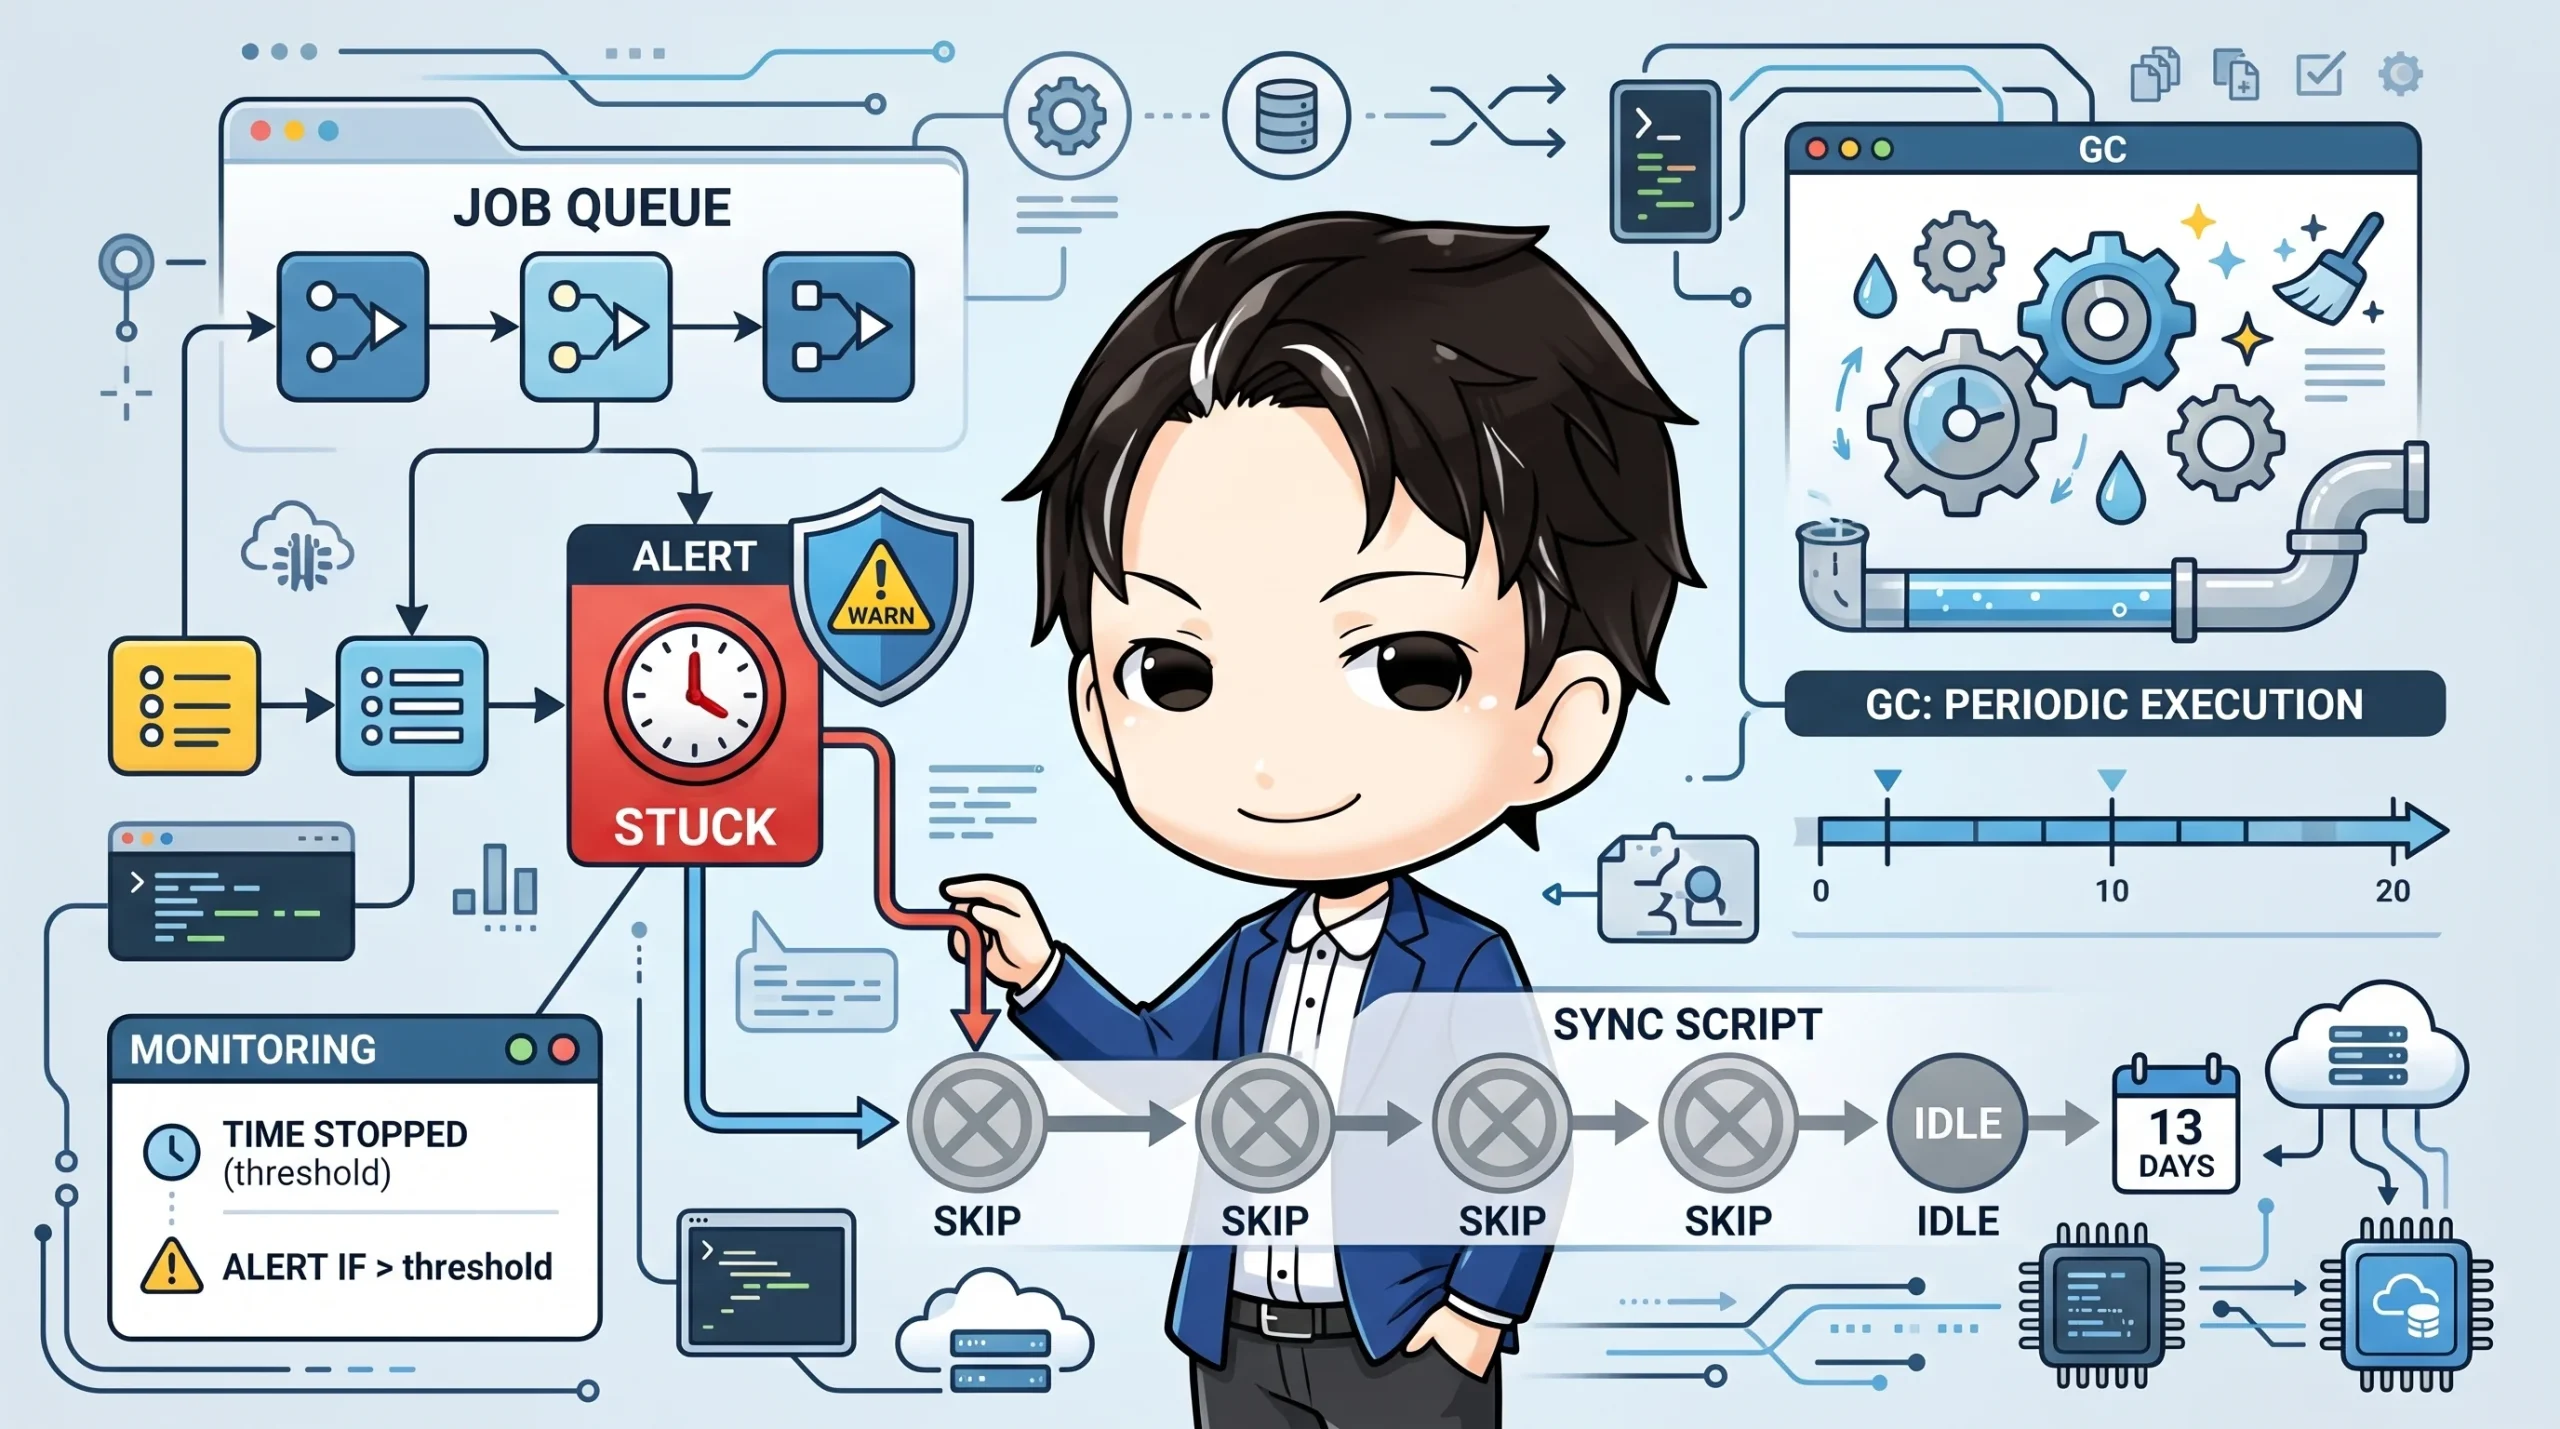
ジョブキューの「実行中」エントリは、ワーカーが crash すると完了にも再投入にも進めず、そのまま残ります。
あるプロジェクトでは、同期スクリプトが「ジョブ実行中は更新しない」という安全側の設計だったため、この孤児エントリのせいで13日間も何もせずスキップし続けました。
スキップは「失敗」ではないので、アラートも鳴らず、誰も気づけませんでした。
この記事では、対策として入れた2つの仕組みを紹介します。
1つは、定義済みなのに誰からも呼ばれていなかった GC(回収処理)を定期実行すること。
もう1つは、「同じ理由で止まり続けている長さ」を state ファイルに記録し、閾値を超えたら WARN することです。
コードはシェルスクリプトですが、考え方は言語を問わず使えます。
こんな人におすすめ
- シェルスクリプトで簡易ジョブキューや同期処理を運用している方
- 「作業中なら何もしない」型の排他制御を入れていて、静かな停止が心配な方
- cron や launchd で回している定期タスクの監視を見直したい方
- 掃除系コマンドを作ったものの、呼び出し元があるか自信がない方
罠1: 安全側のスキップは、長く続くと障害になる
「作業中なら何もしない」は正しい判断です。
ただし、その状態が終わらない場合、スクリプトは毎回正常終了のまま何もしません。
監視はエラー終了や例外を見ているので、反応しません。
ここで見るべきなのは、スキップした回数ではなく継続時間です。
回数は実行間隔を変えるたびに意味が変わりますが、「何時間止まっているか」は間隔に依存しません。
罠2: 回収処理が定義されているのに呼ばれていない
今回の根本原因は、孤児エントリを回収する gc コマンドが存在していたのに、どこからも呼ばれていなかったことでした。
掃除系のコマンドを作ったら、誰がいつ呼ぶかまでセットで確認する必要があります。
定期実行はヘルスチェック側に組み込みました。
呼び出し周期より長い間隔にしたいので、state ファイルの epoch で自前の throttle を持たせています。
if [ "$(( _now_epoch - _last_gc ))" -lt "$DBCI_GC_INTERVAL_S" ]; then
  log_info "gc: 前回から間もないため skip"
else
  echo "$_now_epoch" > "$DBCI_GC_STATE"
  _gc_n="$(DBCI_ROOT="$root" "$QUEUE_SH" gc 2>"$_gc_err")"; _gc_rc=$?
  if [ "$_gc_rc" -ne 0 ]; then
    log_warn "gc が rc=$_gc_rc で失敗"
  elif [ "$_gc_n" -gt 0 ]; then
    # 回収は「何かが途中で落ちた」痕跡なので incident に残す
    record_incident info gc-reclaimed "count=$_gc_n"
  fi
fi
ポイントは次の3つです。
- 間隔は環境変数で変えられ、無効化もできるので、ロールバックが簡単です。
- 回収件数が1件以上のときは、何かが途中で落ちた痕跡として incident に残します。
- GC は実行中のジョブに触れません。claim したプロセスが生きていて timeout 内なら対象外にし、回収分は success ではなく error / expired として残します。
罠3: 停止の長さを state ファイルに記録する
同期スクリプト側では、スキップするたびに「いつから止まっているか」を記録します。
mark_stuck() {
  [ "$DRY_RUN" = "1" ] && return 0
  local since=""
  [ -f "$STATE" ] && since="$(grep '^stuck_since_epoch=' "$STATE" | head -1 | cut -d= -f2)"
  case "$since" in ''|*[!0-9]*) since="$NOW_EPOCH" ;; esac
  # 理由は 1 行に収める (改行を含んでも読み手が壊れないように)
  printf 'stuck_since_epoch=%s\nlast_check_epoch=%s\nlast_reason=%s\n' \
    "$since" "$NOW_EPOCH" "$(printf '%s' "$*" | tr '\n' ' ' | cut -c1-300)" > "$STATE"
}
clear_stuck() { [ "$DRY_RUN" = "1" ] && return 0; rm -f "$STATE"; }
skip() { log "skip: $*"; mark_stuck "$*"; exit 0; }
既存の skip 関数に1行足すだけで、すべてのスキップ経路が記録対象になります。
設計上の工夫は次のとおりです。
stuck_since_epochは、スキップの理由が変わっても最初に止まった時刻のまま据え置きます。理由を問わず「止まっている長さ」を見たいからです。- 復帰(追随成功、またはすでに最新)したら
clear_stuckで state を消します。 - 理由は改行を除き300文字に切り詰め、読み手側が壊れないようにします。
罠4: 監視は state を読むだけにする
監視側は state ファイルを読み、停止時間が閾値を超えたら WARN します。
_ss_age=$(( NOW_EPOCH - _ss_since ))
if [ "$_ss_age" -ge "$STATION_SYNC_STALL_S" ]; then   # 既定 6h
  log_warn "$(( _ss_age / 3600 ))時間 追随できていない。最後の理由: ${_ss_reason:-不明}"
fi
ネットワークを使う既存チェックとは独立したスイッチにしたので、毎サイクル軽く回せます。
また、同期側は孤児かどうかを kill -0 で確認して、スキップ理由に書くだけにしています。
判定にも削除にも使いません。原因は名指しできる一方で、回収の権限は GC にだけ残り、広がりません。
つまづきやすいポイント
- スキップを成功扱いにしている: 終了コードが0のままだと、既存の監視では拾えません。スキップ専用の記録が必要です。
- 理由が変わるたびに開始時刻をリセットしてしまう: 理由が揺れるケースで、長期停止が検知できなくなります。
- テストが空振りする: GC の呼び出しを外す変異を入れ、テストが5件落ちることを確認しました。呼び出しの有無を検証するテストは、こうして効き目を確かめると安心です。
- 定期タスクを持つホストが1台だけ: そのホストを撤去すると役目も消えます。移し忘れの検知は今後の課題です。
まとめ
安全側のスキップは、継続時間を監視しないと静かな停止になります。
回収処理は、定義するだけでなく呼び出し元までセットで確認してください。
「止まっている長さ」を state ファイルに残し、閾値で WARN するだけでも、今回のような長期停止は早期に見つけやすくなります。
原因の推定と回収の責務を分けておくと、権限を広げずに運用できます。