
はじめに
夜間に自動実行される監視ジョブが失敗するたびに、GitHub Issueを自動起票する仕組みは便利です。
しかし「失敗したら新規issueを作る」だけの実装だと、落とし穴があります。
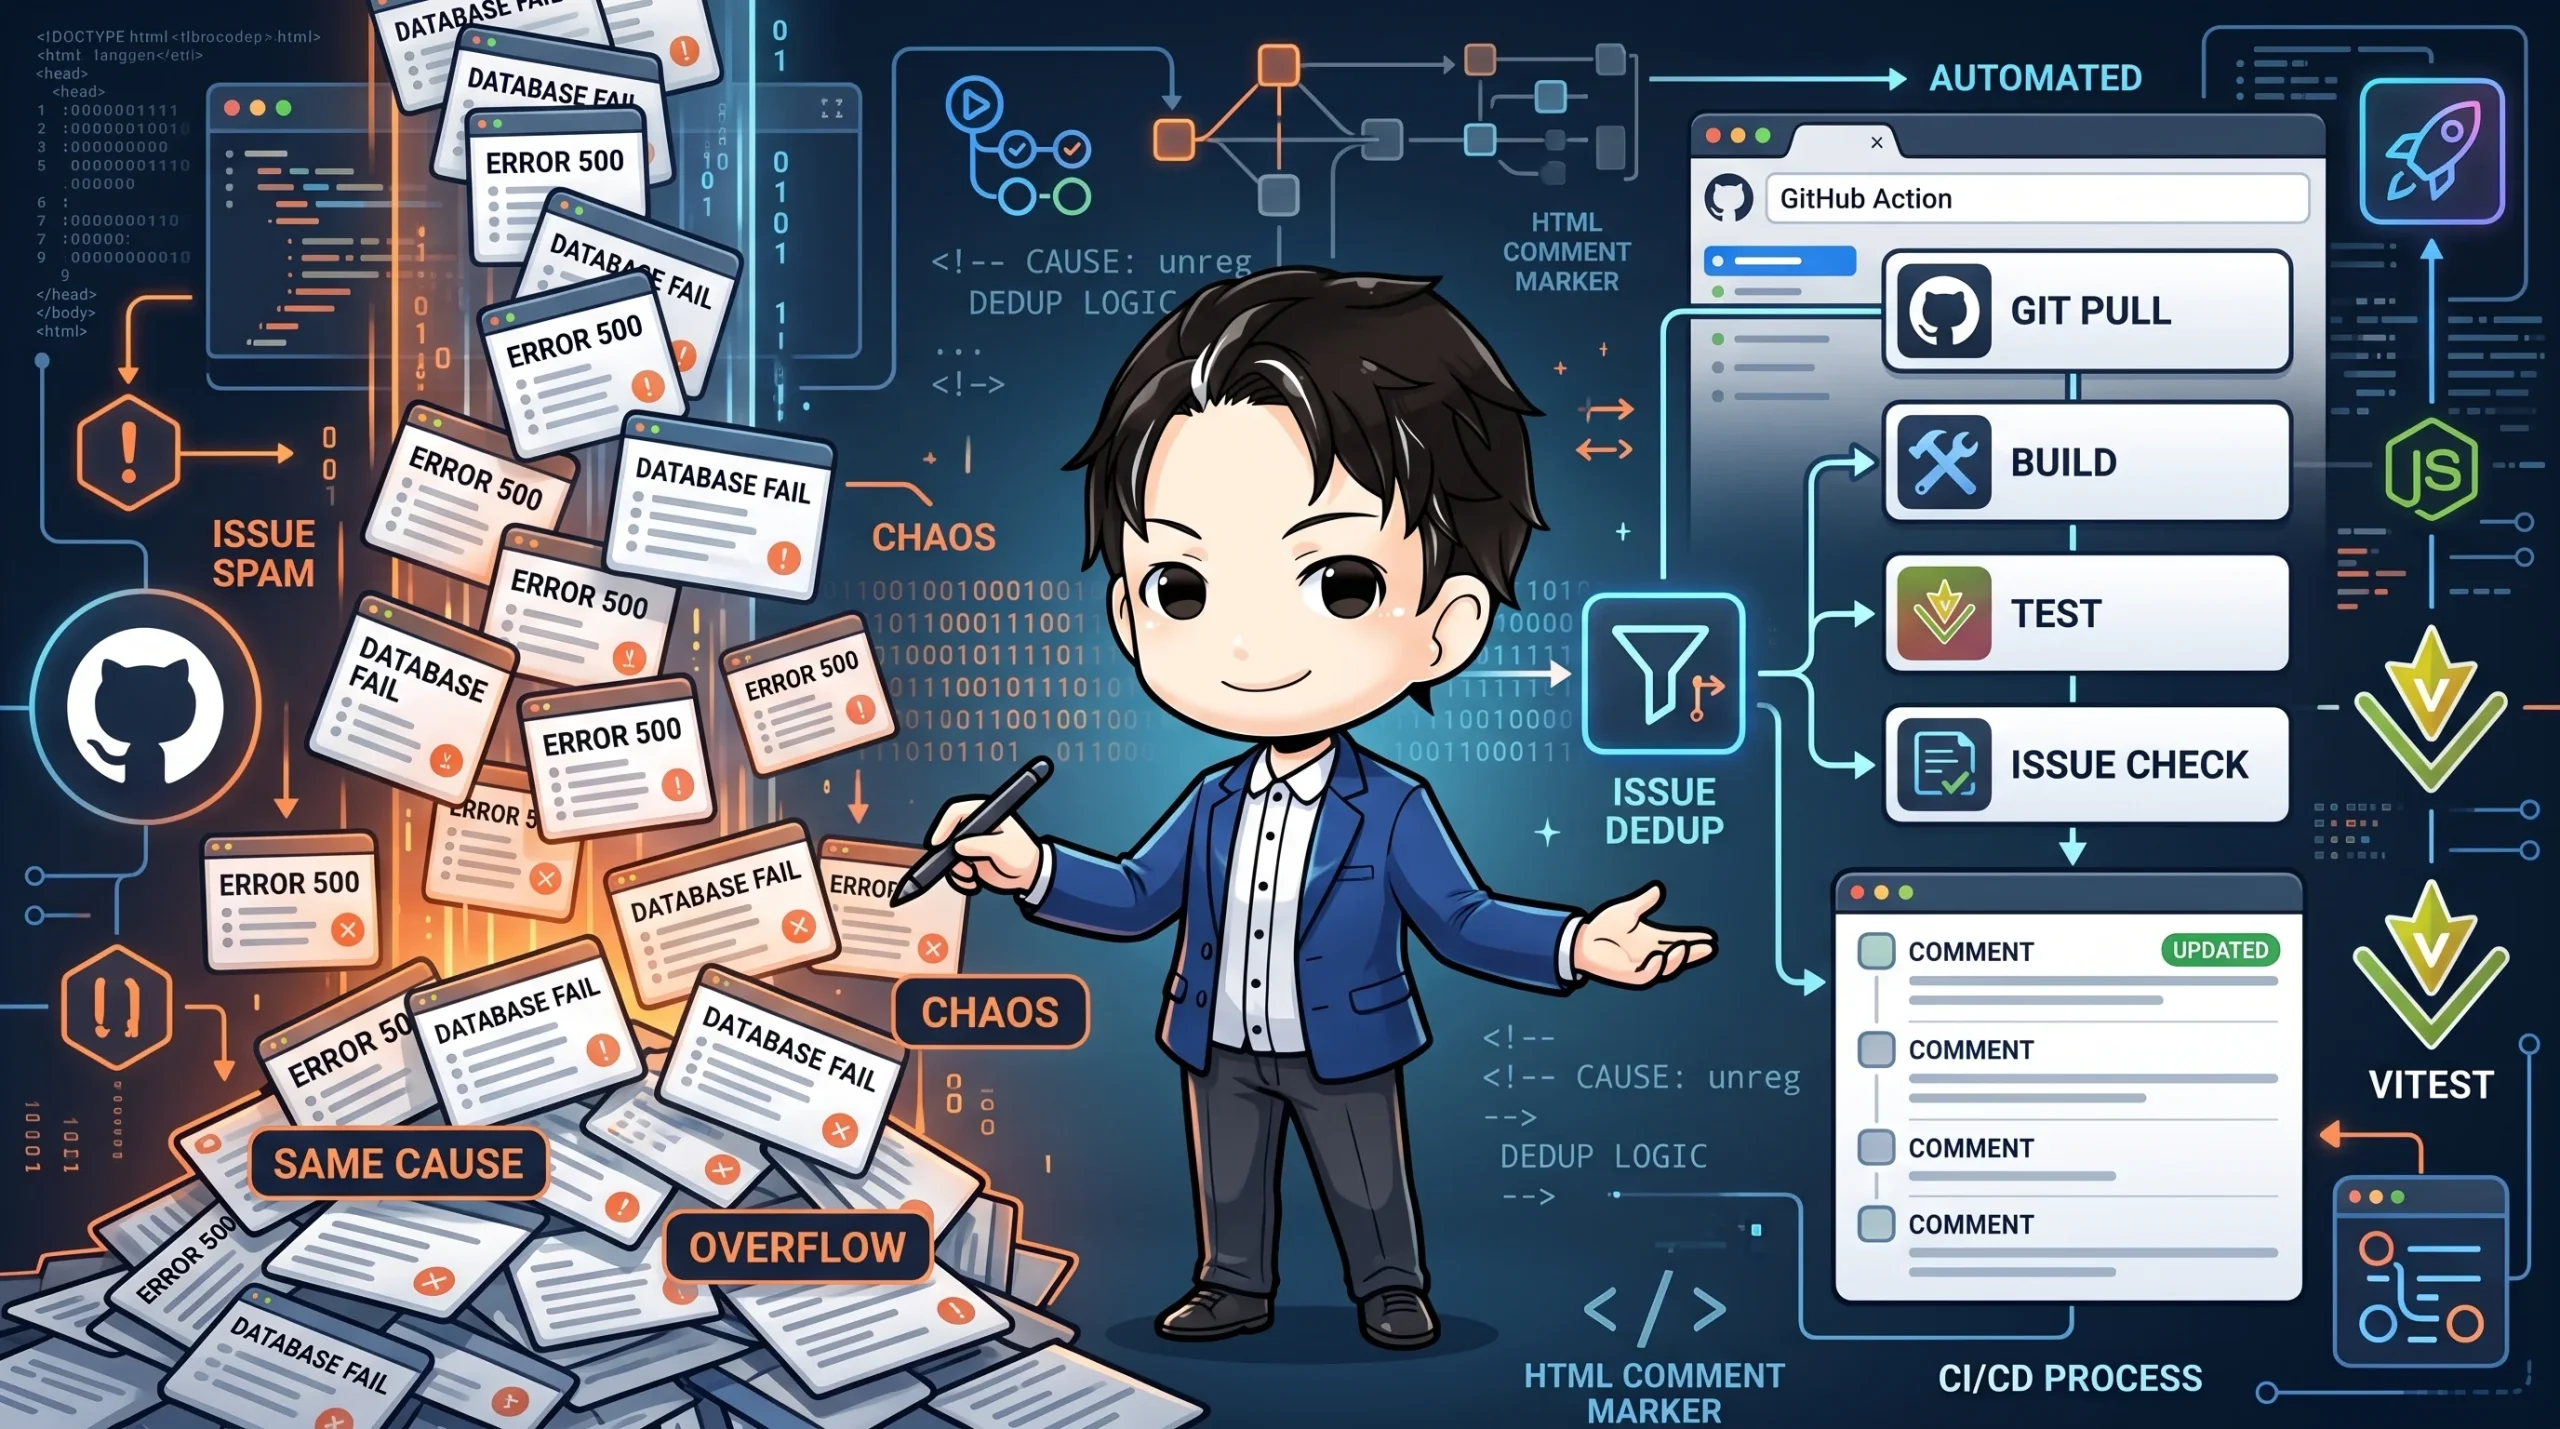
同じ根本原因の失敗が数日続くだけで、毎晩1件ずつissueが積み上がってしまうのです。
数日後には、同じ症状のissueが5〜6件並ぶ状態になります。
どれが最新の状況を反映している「本流のスレッド」なのか、ぱっと見て判断できません。
この記事では、この「自動起票の増殖」を、同一原因のopenなissueがあれば新規発行せず追記コメントする、いわゆるdedup(重複排除)ロジックで解消した設計を紹介します。
インラインのbashスクリプトが70行を超えて複雑化してきたタイミングでNode.jsに切り出した、という移行判断の背景も含めて解説します。
こんな人におすすめ
- CI/CDの監視ワークフローにGitHub Issue自動起票を組み込んでいる方
- インラインbashスクリプトが複雑化してきて、Node.js移行のタイミングを探している方
- API経由で作成したIssueの「重複」に悩んでいる方
- 冪等性のあるバッチ処理を書きたい方
- 純粋関数を切り出してユニットテストしやすい構成にしたい方
増殖の原因は「存在チェック」の欠如
issueが積み上がる原因はシンプルです。
発行前に「同じ原因のopenなissueが既にあるか」を検索するステップが、最初から実装に組み込まれていませんでした。
あれば追記コメント、なければ新規作成、という「upsertパターン」がなかったのです。
CIの自動起票機能を実装するときは、このupsertパターンを最初からデフォルトにしておく価値があります。
後から追加するより、設計段階で組み込むほうがずっと楽だからです。
HTMLコメントマーカーで原因を機械可読にする
同一原因かどうかを判定するために、issue本文の冒頭にHTMLコメントの不可視マーカーを埋め込みます。
export function causeMarker(cause) {
  return `<!-- monitoring-check: cause=${cause} -->`
}

export function bodyHasCause(body, cause) {
  if (!body || !cause) return false
  // 後続が単語文字なら別causeのprefixとみなして不一致にする
  const re = new RegExp(`cause=${escapeRegExp(cause)}(?![A-Za-z0-9_])`)
  return re.test(body)
}
<!-- monitoring-check: cause=unregistered --> のようなマーカーは、人間が読む本文を壊さずにメタデータを運べます。
後からAPIで取得したissue本文を正規表現で解析すれば、cause を確実に判定できるという仕組みです。
さらに、この関数はマーカーが無い既存issueにも対応できます。
メトリクス行などに含まれる cause=<x> トークンを正規表現で拾えるようにしてあるため、新機能導入前の「レガシーissue」との互換性を、最小コストで確保できます。
トークン境界で誤検出を防ぐ
正規表現で文字列マッチングをするとき、見落としがちな罠があります。
cause=unregistered と cause=unregistered_extra は、prefixが同じなので単純な部分一致だと区別できません。
これを防ぐために、(?![A-Za-z0-9_]) という否定先読みアサーションを末尾に付けています。
const re = new RegExp(`cause=${escapeRegExp(cause)}(?![A-Za-z0-9_])`)
これは「マッチした直後が英数字・アンダースコアでないこと」を要求する書き方です。
同じprefixを持つ別の原因が存在しうる場合は、この境界チェックがほぼ必須になります。
複数一致時は最小番号をcanonicalにする
検索の結果、同一原因のopenなissueが複数見つかることもあります。
その場合は、番号が最小のissue(=最初に報告されたスレッド)をcanonicalとして扱います。
export function selectExistingOpenIssue(issues, { cause }) {
  const matches = (issues ?? [])
    .filter(isOpenIssue) // PR・closedを除外
    .filter((it) => typeof it.title === 'string' && it.title.startsWith(TITLE_PREFIX))
    .filter((it) => bodyHasCause(it.body, cause))
  if (matches.length === 0) return null
  // 複数一致なら最古(最小number)をcanonical threadとして返す
  return matches.reduce((min, it) => (it.number < min.number ? it : min))
}
「最初に報告されたスレッドに集約する」というルールは直感的で、手動での集約作業も人に説明しやすいのが利点です。
この関数は issues 配列を引数で受け取る純粋関数として設計してあります。
実際にAPIを呼び出す run() 関数とは分離してあるため、モックなしでロジックだけを単体テストできます。
upsertの全体フローとラベル作成の冪等化
判定ロジックが決まれば、あとは「既存issueがあればコメント、なければ新規作成」というシンプルな分岐です。
const existing = selectExistingOpenIssue(openIssues, { cause })

if (existing) {
  // dedup: 既存issueにコメント追記
  await fetch(`${apiBase}/repos/${repo}/issues/${existing.number}/comments`, {
    method: 'POST',
    body: JSON.stringify({ body: buildDedupComment({ /* ... */ }) }),
  })
  emit({ action: 'commented', issue_number: existing.number })
  return 0
}

// 新規発行(ラベル存在保証はallSettledで冪等に)
await Promise.allSettled(
  ENSURE_LABELS.map((label) => fetch(`${apiBase}/repos/${repo}/labels`, { /* ... */ }))
)
const res = await fetch(`${apiBase}/repos/${repo}/issues`, {
  method: 'POST',
  body: JSON.stringify({ title, body: buildNewIssueBody({ /* ... */ }), labels: ISSUE_LABELS }),
})
emit({ action: 'created', issue_number: createdNumber })
ここで注目したいのが Promise.allSettled の使い方です。
ラベル作成APIは、ラベルが既に存在すると422エラーを返します。
Promise.all を使ってしまうと、既存ラベルが1つでもあるだけで全体の処理が失敗してしまいます。
allSettled で結果を無視する形にしておけば、個々の失敗に関わらず処理を続行できる、ベストエフォート型の冪等な保証になります。
「ラベルの存在を保証したいだけで、失敗理由には興味がない」という場面では、この使い分けが効いてきます。
つまづきやすいポイント
- 正規表現のトークン境界を書き忘れると、prefixが同じ別の原因を誤って同一視してしまいます
Promise.allでラベル作成をまとめると、既存ラベルがあるだけで処理全体が失敗します- 純粋関数とI/Oを分離しておかないと、テストのたびに実際のAPI呼び出しが必要になり、テストが書きにくくなります
- レガシーissueとの互換性を後回しにすると、新方式への移行時に大量の重複issueが残ったままになります
- インラインbashが70行を超えたあたりは、Node.jsなど条件分岐をテストしやすい言語への移行を検討する目安になります
まとめ
自動起票の仕組みは、「失敗したら作る」だけでは同じ原因のissueを際限なく積み上げてしまいます。
同一原因のopenなissueを検索し、あれば追記・なければ新規作成というupsertパターンを組み込むことで、この増殖を防げます。
HTMLコメントによる機械可読マーカーと、既存データへの正規表現フォールバックを組み合わせれば、レガシーissueとの互換性も維持できます。
純粋関数とI/Oを分離した設計にしておくと、判定ロジックだけを高速にユニットテストできるようになります。
CI監視の自動起票を実装・運用している方は、一度dedupの観点で見直してみる価値があるはずです。