
はじめに
WordPressでタクソノミーのアーカイブページ(一覧ページ)を作ると、つい「投稿一覧を並べるだけ」の薄いページになりがちです。検索エンジンから見ると、そのカテゴリで何件あるのか、相場感はどれくらいか、といった情報がないページは評価されにくい傾向があります。
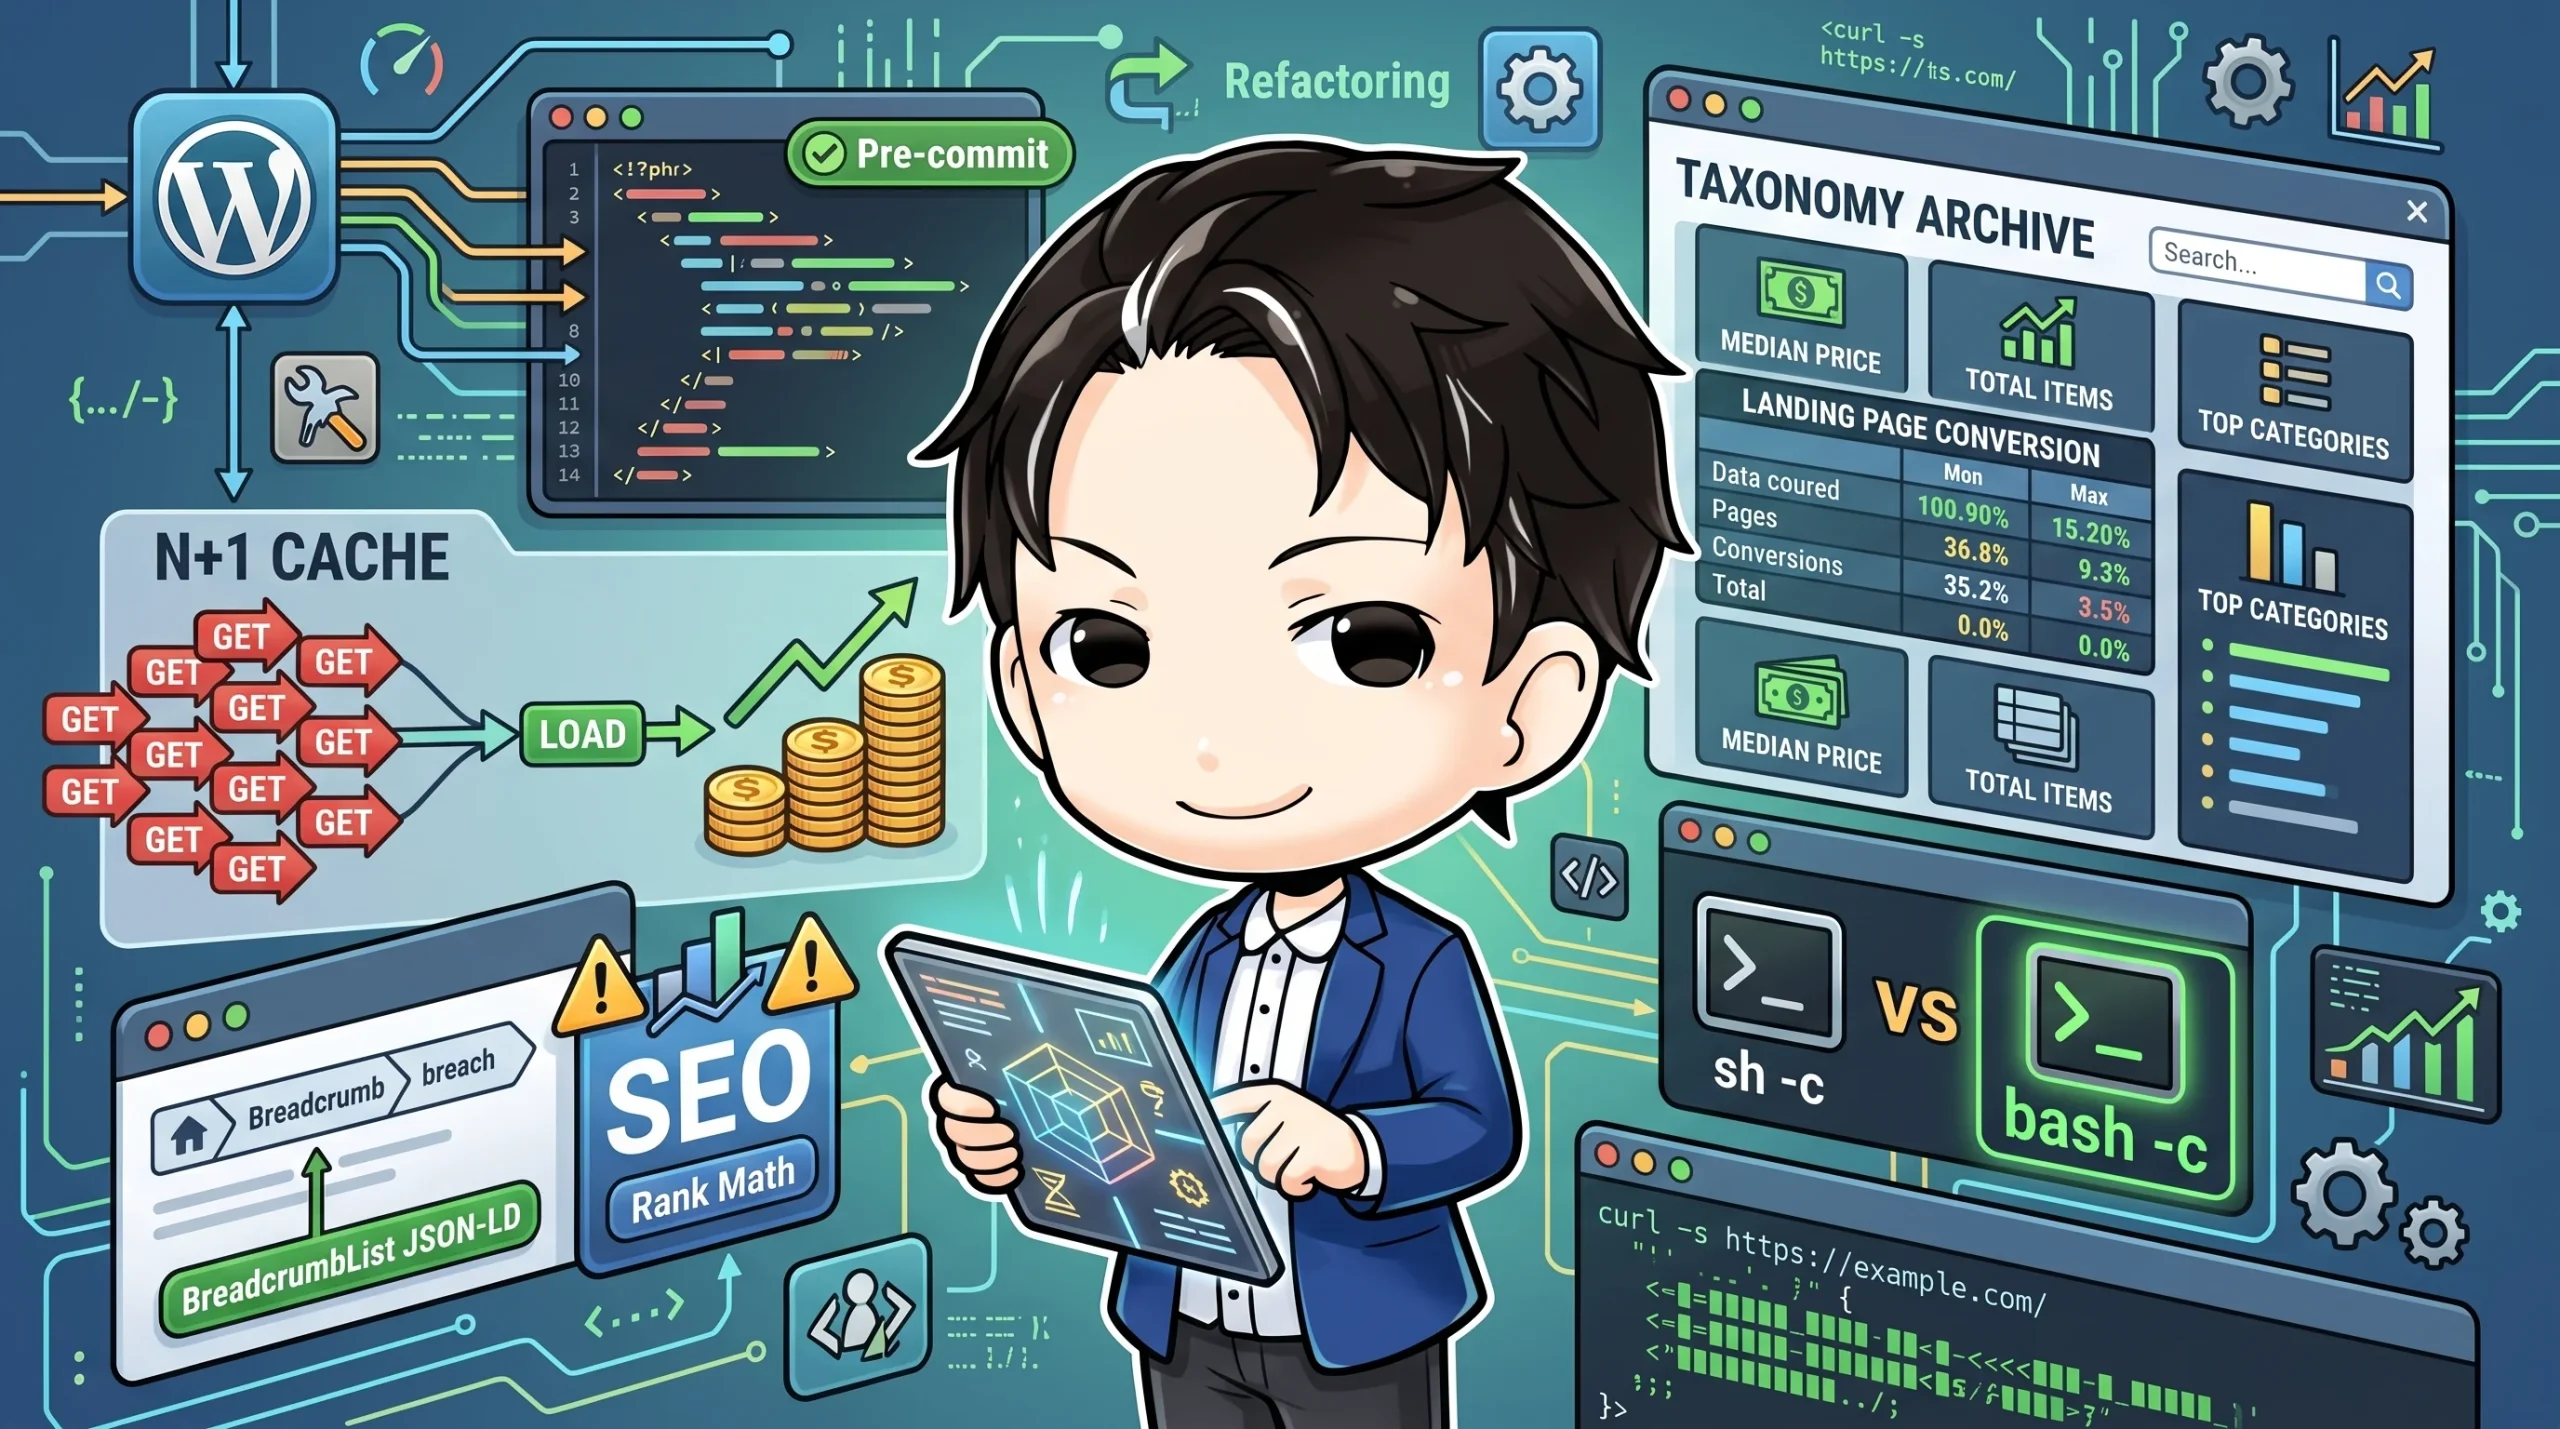
今回は、アーカイブページの冒頭に「該当件数・中央値・上位カテゴリ」をまとめた比較表を出し、あわせてパンくずをHTML表示だけでなくBreadcrumbListのJSON-LD構造化データとしても出力する対応を通じて見えてきた、実装上の落とし穴をまとめます。
こんな人におすすめ
- タクソノミーアーカイブをSEO目的で強化したい方
- パンくずリストに構造化データを追加しようとしている方
- ループ処理でメタやタームを取得していて表示が重いと感じている方
- lint-stagedのpre-commitフックが原因不明で失敗している方
罠1: SEOプラグインと二重実装していないか確認する
タイトルタグやmeta descriptionを自前のフックで生成しようとして、実は本番環境で有効なSEOプラグイン(Rank Mathなど)が既に同じ役割を担っていた、というケースがあります。フックで上書きを試みても、SEOプラグイン側の出力が後勝ちになり反映されないことがあります。
実装に着手する前に、対象ページをcurlして実際に出力されているHTMLを確認するだけで、この手戻りは防げます。
curl -s https://example.com/taxonomy-archive/ | grep -E '<title>|meta name="description"'
さらに厄介なのは、SEOプラグインがterm meta(管理画面からしか編集できないフィールド)でタイトルを管理している場合です。REST API経由での更新ができず、自動化を諦めて手動運用に切り替えざるを得ないことがあります。自動化できる範囲とできない範囲は、実装前の調査段階で切り分けておくと安心です。
罠2: 集計処理のN+1をキャッシュの先読みで防ぐ
該当件数・中央値・上位カテゴリを算出するために投稿をループすると、get_post_meta()やwp_get_object_terms()を件数分呼び出すことになり、N+1が発生します。事前に一括キャッシュをロードしてからループするだけで解消できます。
$post_ids = $query->posts;
if ( empty( $post_ids ) ) {
    return null;
}

// 全投稿のメタ・タームを一括ロードし、ループ内でのN+1を回避する
\update_postmeta_cache( $post_ids );
\update_object_term_cache( $post_ids, 'item' );

$values = [];
$category_counts = [];

foreach ( $post_ids as $post_id ) {
    $price = get_post_meta( (int) $post_id, 'price', true );
    if ( (float) $price > 0 ) {
        $values[] = (float) $price;
    }

    $category_names = wp_get_object_terms( (int) $post_id, 'region', [ 'fields' => 'names' ] );
    if ( ! is_wp_error( $category_names ) ) {
        foreach ( $category_names as $name ) {
            $category_counts[ $name ] = ( $category_counts[ $name ] ?? 0 ) + 1;
        }
    }
}

arsort( $category_counts );

return [
    'count'          => count( $post_ids ),
    'median'         => self::calculate_median( $values ),
    'top_categories' => array_slice( array_keys( $category_counts ), 0, 3 ),
];
なお中央値の計算は、外部ライブラリに頼らなくてもsort()と件数の偶奇判定だけで十分書けます。
罠3: パンくずのHTML/JSON-LDを二重管理しない
パンくずリストは、HTML表示用とBreadcrumbListのJSON-LD用を別々に組み立てると、同じデータを二重にメンテナンスすることになります。配列を組み立てる処理を1つのメソッドに切り出し、HTMLテンプレートとJSON-LDテンプレートの両方から呼び出す形にすると保守性が上がります。
function get_tax_breadcrumb_array(): array {
    $term = get_queried_object();
    if ( ! $term || ! isset( $term->taxonomy, $term->name ) ) {
        return [];
    }

    $breadcrumb_array = [
        [ 'name' => 'ホーム', 'url' => home_url(), 'class' => 'breadcrumb-list__item--home' ],
    ];

    $taxonomy = get_taxonomy( $term->taxonomy );
    $taxonomy_url_map = [
        'price_range' => '/price-range',
        'region'      => '/region',
    ];
    $taxonomy_path = $taxonomy_url_map[ $term->taxonomy ] ?? '';

    $breadcrumb_array[] = [
        'name' => $taxonomy ? $taxonomy->label : $term->taxonomy,
        'url'  => $taxonomy_path !== '' ? home_url( $taxonomy_path ) : '',
        'class' => '',
    ];
    $breadcrumb_array[] = [ 'name' => $term->name, 'class' => '' ];

    return $breadcrumb_array;
}
呼び出し側はHTML出力用の関数とJSON-LD出力用の関数の両方から、この配列を参照するだけになります。
JSON-LDをwp_json_encode()で出力する際は、JSON_UNESCAPED_SLASHESを安易に付けない方が安全な場合があります。name欄に管理画面から編集可能な文字列が入る構成では、</script>を含む値がスクリプトタグの早期終了を誘発するリスクがあるためです。
罠4: lint-stagedの引数渡しをsh -cからbash -cへ
lint-stagedの設定不備で、特定ファイルを変更するコミットが毎回pre-commitで失敗する、という問題にも遭遇しました。原因はsh -cに文字列だけを渡すパターンで、lint-stagedが後ろに付与するファイル引数がコマンドに渡っていなかったことです。
-      "sh -c 'vendor/bin/phpcbf --standard=phpcs.xml.dist || true'",
+      "bash -c 'vendor/bin/phpcbf --standard=phpcs.xml.dist \"$@\" || true' --",
bash -cの末尾に--を置き、"$@"で明示的に引数を受け渡す形にすることで解決しました。
つまづきやすいポイント
- SEOプラグインがterm metaでタイトルを管理している場合、REST APIでは更新できず手動運用になることがある
JSON_UNESCAPED_SLASHESは便利ですが、管理画面由来の文字列を含むJSON-LDでは慎重に検討する- 「どのカテゴリ値でも破綻しない」という受け入れ条件は、境界値を含む全パターンをテーブル駆動テストで回すと安心できる
- lint-stagedの
sh -c '... || true'パターンは、引数が渡らず気づきにくい
まとめ
タクソノミーアーカイブをランディングページとして強化する際は、まず本番環境で何が既に生成されているかを確認することが近道になります。
集計処理はキャッシュの先読みでN+1を避け、パンくずはHTML/JSON-LDで組み立てロジックを共有すると保守しやすくなります。
lint-stagedのようなツール周りの小さな設定ミスも、気づかないまま放置すると開発体験を継続的に悪化させるため、早めに潰しておくと良さそうです。