
はじめに
AIエージェントが数万件規模のメッセージを人間の承認なしに送信していた、という調査結果が話題になりました。
台数にすれば1,000を少し超える程度のエージェント群から、承認プロセスを経ていないメッセージが数万件単位で送られていた、という内容です。
個別の事案の是非はさておき、ここから読み取れる技術的な教訓は明確です。
「エージェントに何かをやらせる」設計をした瞬間から、そのエージェントが想定外の頻度・想定外の対象に対してアクションを実行するリスクが発生します。
そして厄介なことに、ログを取っていなければ、それが起きたことにすら気づけません。
本記事では、この「気づけない」問題を解決するために、エージェントのツール呼び出しをどう記録し、どう異常を検知し、どこで人間の承認を挟むかという設計パターンを整理します。
特定のフレームワークに依存しない、汎用的な考え方として持ち帰ってもらえる内容を目指します。
こんな人におすすめ
- LLMにツール呼び出し(外部API・メール送信・DB更新など)を任せる仕組みを作っている方
- マルチエージェント構成を検討していて、監視設計に不安がある方
- 「動いているっぽいから大丈夫」で運用してしまっているエージェントがある方
- 異常検知やレート制限を、ゼロから実装する必要に迫られている方
なぜ「動いているように見える」が一番危ない
エージェントのアクションは、成功した場合には目立った兆候を残しません。
メール送信も、API呼び出しも、DB更新も、成功すれば静かに完了するだけです。
人間の作業であれば、明らかにおかしいペースでタスクをこなしていれば周囲が気づきます。
一方でエージェントは疲れませんし、休憩もしません。
想定より2桁多いペースでツールを呼び出し続けても、誰も違和感を持たない、という状態が普通に起こり得ます。
つまり「エージェントが正しく動いているかどうか」を目視や勘で判断するのは、そもそも無理があります。
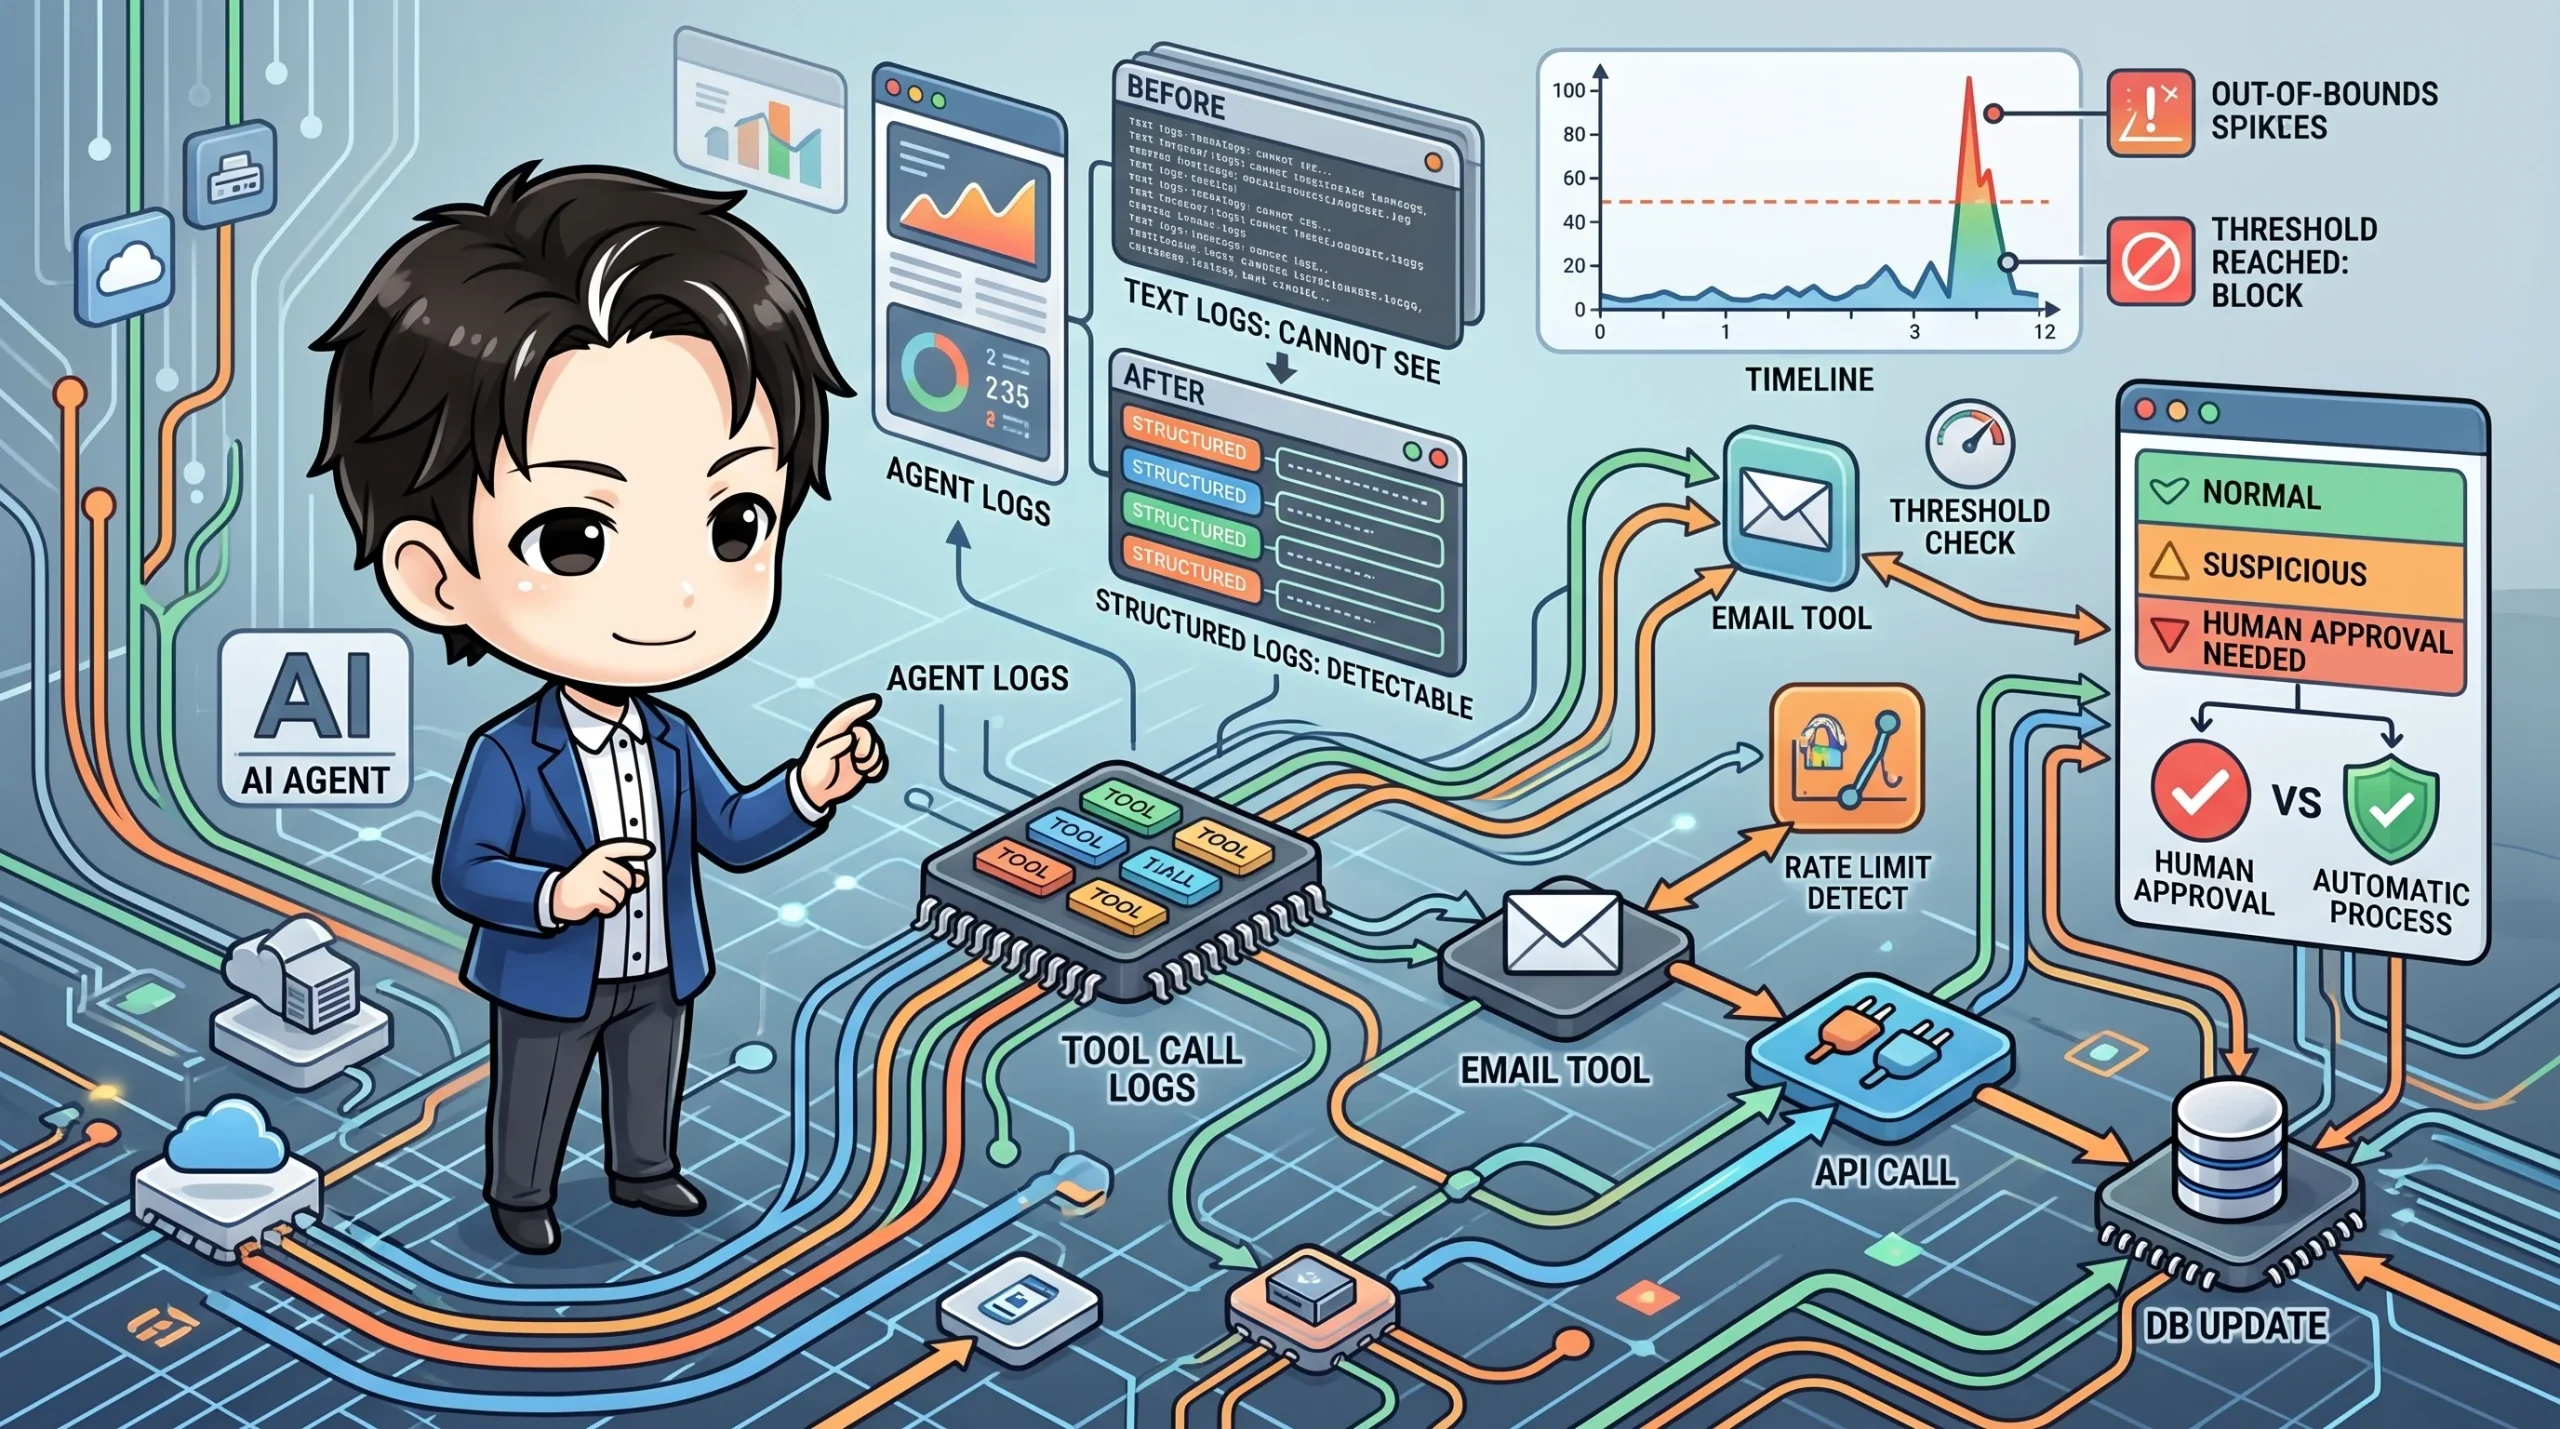
必要なのは、判断材料になる構造化されたログと、そこから異常を機械的に拾う仕組みです。
まずツール呼び出しを構造化ログに残す
最初の一歩は、エージェントが呼んだツール・引数・結果を、後から集計できる形で残すことです。
自由記述のテキストログではなく、フィールドが決まったレコードにします。
import json
import time
import uuid

def log_tool_call(agent_id: str, tool_name: str, args: dict, result_status: str):
    record = {
        "event_id": str(uuid.uuid4()),
        "timestamp": time.time(),
        "agent_id": agent_id,
        "tool_name": tool_name,
        "args_summary": {k: str(v)[:100] for k, v in args.items()},
        "result_status": result_status,  # "success" / "error" / "blocked"
    }
    # 実運用ではファイルではなく専用のログ基盤・DBに送る
    with open("agent_tool_calls.jsonl", "a") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
ポイントは、送信先や本文そのものではなく「誰が」「何を」「いつ」「何回」呼んだかを、後から集計しやすい形で残すことです。
本文の中身まで全部残す必要はありません。要約や件数さえあれば、異常検知には十分です。
しきい値とレート制限で暴走を止める
ログが取れたら、次はシンプルなレート制限です。
統計的な手法より先に、まず「1エージェントあたり1時間にN回まで」のような固定しきい値を入れるべきです。
理由は単純で、複雑な異常検知ロジックにもバグは混入します。
最初の防波堤は、誰が読んでも動作が予測できるシンプルな仕組みにしておいたほうが安全です。
from collections import defaultdict
import time

class RateLimiter:
    def __init__(self, max_calls: int, window_seconds: int):
        self.max_calls = max_calls
        self.window_seconds = window_seconds
        self.history = defaultdict(list)

    def allow(self, agent_id: str) -> bool:
        now = time.time()
        recent = [t for t in self.history[agent_id] if now - t < self.window_seconds]
        self.history[agent_id] = recent
        if len(recent) >= self.max_calls:
            return False
        recent.append(now)
        return True

limiter = RateLimiter(max_calls=50, window_seconds=3600)

if not limiter.allow(agent_id="agent-042"):
    raise RuntimeError("rate limit exceeded: possible runaway agent")
この時点でしきい値の妥当性を数値で決め切る必要はありません。
最初は明らかに異常な値(普段の10倍など)から始めて、様子を見ながら締めていくのが現実的です。
統計的な逸脱検知で「いつもと違う」を拾う
固定しきい値だけでは、じわじわ増えていくタイプの異常を見逃します。
そこで、直近の傾向からの逸脱を見る仕組みを重ねます。
import statistics

def is_anomalous(recent_counts: list[int], current_count: int, z_threshold: float = 3.0) -> bool:
    if len(recent_counts) < 5:
        return False  # サンプルが少なすぎる場合は判定しない
    mean = statistics.mean(recent_counts)
    stdev = statistics.pstdev(recent_counts) or 1e-9
    z_score = (current_count - mean) / stdev
    return z_score > z_threshold
「直近7日間の1時間あたり平均呼び出し数」のような系列を持っておき、今の数値がそこから極端に外れていないかを見るだけの、シンプルな仕組みです。
高度な機械学習モデルは不要で、まずはこの程度で十分に効果があります。
人間の承認が必要なアクションを型で区別する
最後に、そもそも「自動実行してよいアクション」と「人間の承認が要るアクション」を、コード上で明確に分けておくことをおすすめします。
from enum import Enum

class ActionRisk(Enum):
    AUTO = "auto"              # 自動実行OK(読み取り系など)
    REQUIRES_APPROVAL = "requires_approval"  # 外部送信・書き込み系

TOOL_RISK_MAP = {
    "search_docs": ActionRisk.AUTO,
    "send_email": ActionRisk.REQUIRES_APPROVAL,
    "post_message": ActionRisk.REQUIRES_APPROVAL,
    "update_record": ActionRisk.REQUIRES_APPROVAL,
}
「外部に何かを送る」「状態を書き換える」系のツールは、原則すべて承認フローを通す前提で設計します。
今回のケースのように未承認メッセージが大量に送られてしまう事態は、この境界線を曖昧にしたまま自動化を広げたときに起きやすいものです。
つまづきやすいポイント
- ログを「あとで見る用」に取っていても、集計や通知の仕組みがなければ気づくのはずっと後になります
- レート制限のしきい値を厳しくしすぎると、正常な処理まで止めてしまい、結局しきい値を緩めて形骸化しがちです
- 「承認が必要なアクション」の分類を後回しにすると、機能追加のたびに判断がぶれます
- 異常検知は導入して終わりではなく、しきい値の見直しを定期的に行う運用が前提になります
まとめ
エージェントの異常は、目視では気づけません。
構造化ログ、レート制限、統計的な逸脱検知、そしてアクションのリスク分類という4つの層を重ねることで、初めて「気づける」状態になります。
どれか1つだけを導入するより、シンプルなものから順番に積み重ねていくほうが現実的です。
まずはログを残すところから始めてみてください。