
はじめに
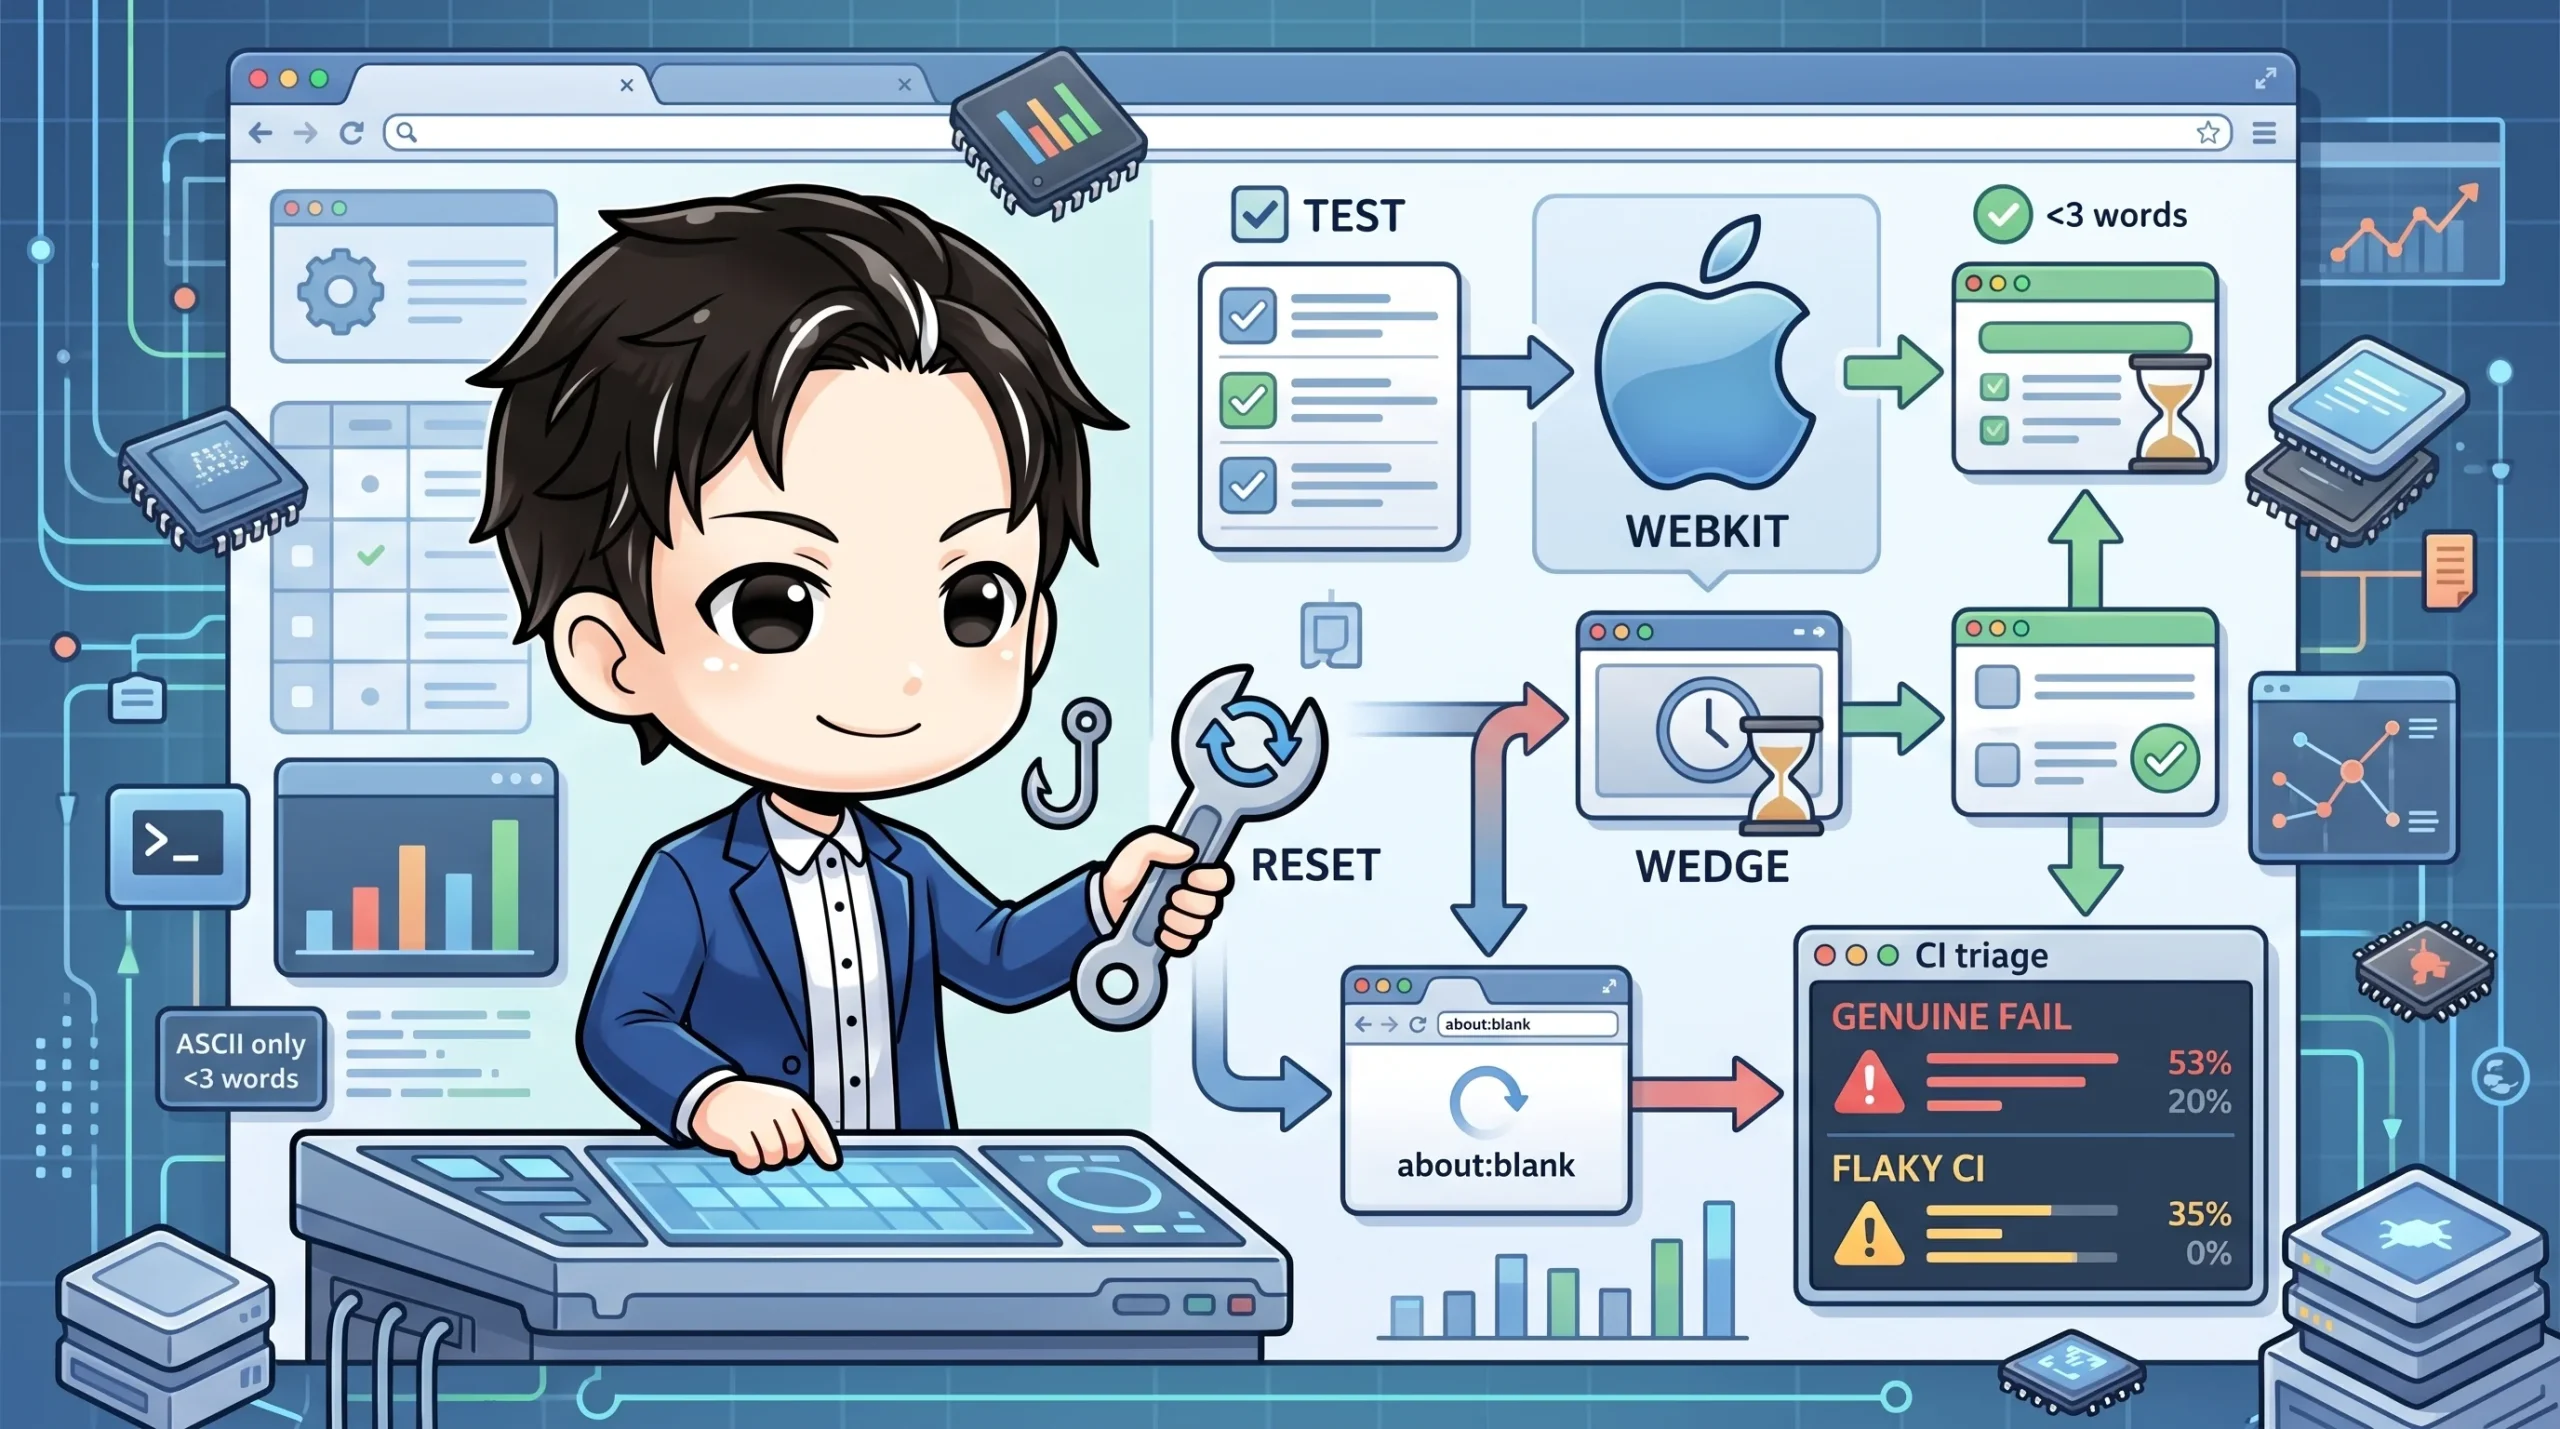
Playwrightでnightly E2Eを回していると、特定のブラウザだけが断続的に失敗する、というケースに出くわすことがあります。特にwebkitは他のブラウザと挙動が違う場面が多く、page.gotoやpage.reloadがwaitUntil: 'commit'(HTTPレスポンスヘッダを受信するフェーズ)でタイムアウトし、そのままブラウザが応答しなくなる、いわゆる「wedge」状態に陥ることがあります。
厄介なのは、Playwrightのtest-level retry(新しいcontextを作り直すリトライ)では回復するのに、同一context内での単純な再実行では同じ状態を踏み続けてしまう点です。さらに、こうしたインフラ起因のflaky(不安定なテスト)を、実装バグによるgenuineな失敗と同じ閾値でIssue化してしまうと、triageのノイズが増えて本当に見るべき回帰を見逃しやすくなります。
この記事では、同一ブラウザcontext内でwedgeから安全に抜ける方法と、flakyの原因を機械的に分類してCIアラートの閾値を分ける設計について、汎用的に使える形で整理します。
こんな人におすすめ
- Playwright E2Eをnightlyで運用しており、特定ブラウザだけが不安定なテストに悩んでいる方
- ナビゲーション系のタイムアウトでブラウザやページが固まる現象に遭遇したことがある方
- flakyテストのIssueが荒れて、インフラ起因のノイズと本物のバグが混在してしまっている方
- CIのアラート閾値をブラウザやエラー種別ごとに調整したい方
- Playwrightのretry戦略を見直したい方
「wedge」の正体はin-flightなdocument loader
webkitのwedgeは、page.gotoがcommitフェーズでタイムアウトした後も、そのdocument loadリクエスト自体はブラウザ内部で生き続けていることが原因だと考えられます。同一context内で再度page.gotoを呼んでも、同じloaderを踏み直すことになるため、単純なリトライでは状況が変わりません。
この性質を理解しておくと、「なぜリトライ回数を増やしても直らないのか」という疑問への説明がつきます。対処すべきは回数ではなく、loaderの状態そのものです。
about:blankへ逃がしてwedgeをリセットする
ネットワーク通信を一切伴わないabout:blankへの遷移は、commit timeoutでwedgeする心配がありません。これをリセット手段として使うことで、context再生成に頼らずin-contextで復帰できる確率を上げられます。
async function resetWedgedNavigation(page: Page): Promise<void> {
  await page.goto('about:blank', { waitUntil: 'commit', timeout: 5_000 })
}

export async function gotoAppPath(page: Page, path: string): Promise<void> {
  await navigateWithCommitRetry(
    (options) => page.goto(path, options),
    () => resetWedgedNavigation(page),
  )
}
ポイントは、about:blank自体にも短いtimeout(この例では5秒)を設定していることです。実際にはネットワーク不要なのでほぼ即座に完了しますが、万一詰まった場合でも短時間で切り上げられるようにしておくと安心です。
リカバリーフックが失敗してもワーストケースを悪化させない
リセット処理を組み込む際に気をつけたいのは、「リセット自体が失敗したときにどうなるか」です。ここでは、リセットに失敗してもnavigationを諦めずに次のattemptへ進む、best-effort方式を採用しています。
export type CommitNavigationRecovery = () => Promise<void>

export async function navigateWithCommitRetry(
  navigate: CommitNavigation,
  recover?: CommitNavigationRecovery,
): Promise<void> {
  for (let attempt = 0; attempt < NAVIGATION_COMMIT_MAX_ATTEMPTS; attempt++) {
    try {
      await navigate({ waitUntil: 'commit', timeout: NAVIGATION_COMMIT_TIMEOUT_MS })
      return
    } catch (error) {
      const isLastAttempt = attempt === NAVIGATION_COMMIT_MAX_ATTEMPTS - 1
      if (!isNavigationTimeoutError(error) || isLastAttempt) throw error
      if (recover) {
        try {
          await recover()
        } catch {
          // best-effort: リセットが失敗しても従来の単純リトライに劣化するだけにする
        }
      }
    }
  }
}
recoverをoptionalにしているのは、既存の呼び出し側のシグネチャを変えずに導入できるようにするためです。フック自体の失敗を内側のtry-catchで握りつぶすことで、「フックを追加してもワーストケースは従来のリトライと同じ」という設計にしています。新しい仕組みを足すときに、失敗時の挙動が既存より悪化しないことを保証しておくと、導入のハードルが下がります。
flakyの原因を機械的に分類してCIノイズを減らす
インフラ起因のself-healing flaky(コンテキストを作り直せば直るタイプの不安定さ)と、実装バグによるgenuineな失敗を同じ閾値で扱うと、triageのノイズが増えてしまいます。そこで、エラーメッセージから原因を分類するロジックを用意します。
export const WEBKIT_COLD_LOAD_NAV_STALL = 'webkit-cold-load-nav-stall'
export const FLAKY_CAUSE_OTHER = 'other'

export function classifyFlakyCause(errorMessage) {
  if (typeof errorMessage !== 'string' || errorMessage.length === 0) return FLAKY_CAUSE_OTHER
  const normalized = errorMessage.toLowerCase()
  const isNavTimeout =
    (normalized.includes('page.goto') || normalized.includes('page.reload')) &&
    normalized.includes('timeout') &&
    normalized.includes('exceeded')
  const isCommitWait =
    normalized.includes('waiting until "commit"') || normalized.includes("waiting until 'commit'")
  return isNavTimeout && isCommitWait ? WEBKIT_COLD_LOAD_NAV_STALL : FLAKY_CAUSE_OTHER
}
page.gotoまたはpage.reloadのtimeoutで、かつwaiting until "commit"を含む場合のみcold-load stallと判定し、それ以外はすべてgenuine(本物の失敗)として扱います。原因が特定できないケースをあえて緩い閾値に倒さず、厳しい閾値側に倒しておくことで、監視の感度を下げずに済みます。
ブラウザ別に閾値を変える
分類したcauseをもとに、ブラウザごとに異なる閾値を適用します。
export function resolveFlakyBuckets(flaky, browser) {
  if (browser === 'webkit') return partitionFlakyByCause(flaky)
  // webkit以外は全件genuine扱い(緩い閾値で回帰を見逃さないため)
  return { coldLoad: [], genuine: flaky ?? [] }
}

export function shouldFileIssue({ genuine, coldLoad, threshold, coldLoadThreshold }) {
  return genuine.length >= threshold || coldLoad.length >= coldLoadThreshold
}
webkitのcold-load stallはcontext再生成で自動回復するインフラ起因のflakyなので、webkit jobにのみ高めの閾値を適用します。一方、他のブラウザのcommit timeoutは引き続きgenuine扱い(低い閾値)のままにしておくことで、本物の回帰を見逃さないようにしています。閾値自体は環境変数で外から制御できるようにしておくと、後から調整しやすくなります。
つまづきやすいポイント
- 文字列マッチによる原因分類は、Playwright側のエラーメッセージフォーマットが変わると追従できなくなるリスクがあります。フォールバック先を安全側(genuine扱い)にしておくことが重要です
- リカバリーフックがいつ発火するかは、単体テストで明示しておかないと意図が伝わりにくくなります。「失敗attemptの後・次retryの前」だけで、成功後や最終attempt後には走らないことを確認しておくと安心です
- 閾値の緩和はwedgeするブラウザ・原因に限定して適用し、それ以外は従来通り厳しい閾値のままにしておかないと、本来検知すべき回帰まで見逃してしまいます
- リセット処理自体にも短いtimeoutを設定しておかないと、リセットのつもりが新たな待ち時間を生む可能性があります
まとめ
同一ブラウザcontext内でナビゲーションが固まる現象は、ネットワーク通信を伴わない遷移でloaderをリセットすることで、context再生成に頼らず復帰できる場合があります。リカバリー処理はbest-effortにして、失敗時のワーストケースが既存のリトライと変わらないように設計するのがポイントです。
また、CIのflaky対策としては、原因を機械的に分類し、インフラ起因のものにだけ緩い閾値を適用する一方、原因不明なものは安全側(厳しい閾値)に倒しておくことで、ノイズを減らしつつ本物の回帰を見逃さない設計にできます。ブラウザ固有の癖に振り回されがちな部分ですが、分類と閾値分けという考え方自体は他のインフラ起因flakyにも応用できそうです。