
はじめに
Google DeepMindの気象予測モデルが、温度予報の解像度を25kmから5kmへと大きく引き上げたという発表がありました。
注目したいのは「解像度が上がった」という結果そのものより、そこに至るアプローチです。
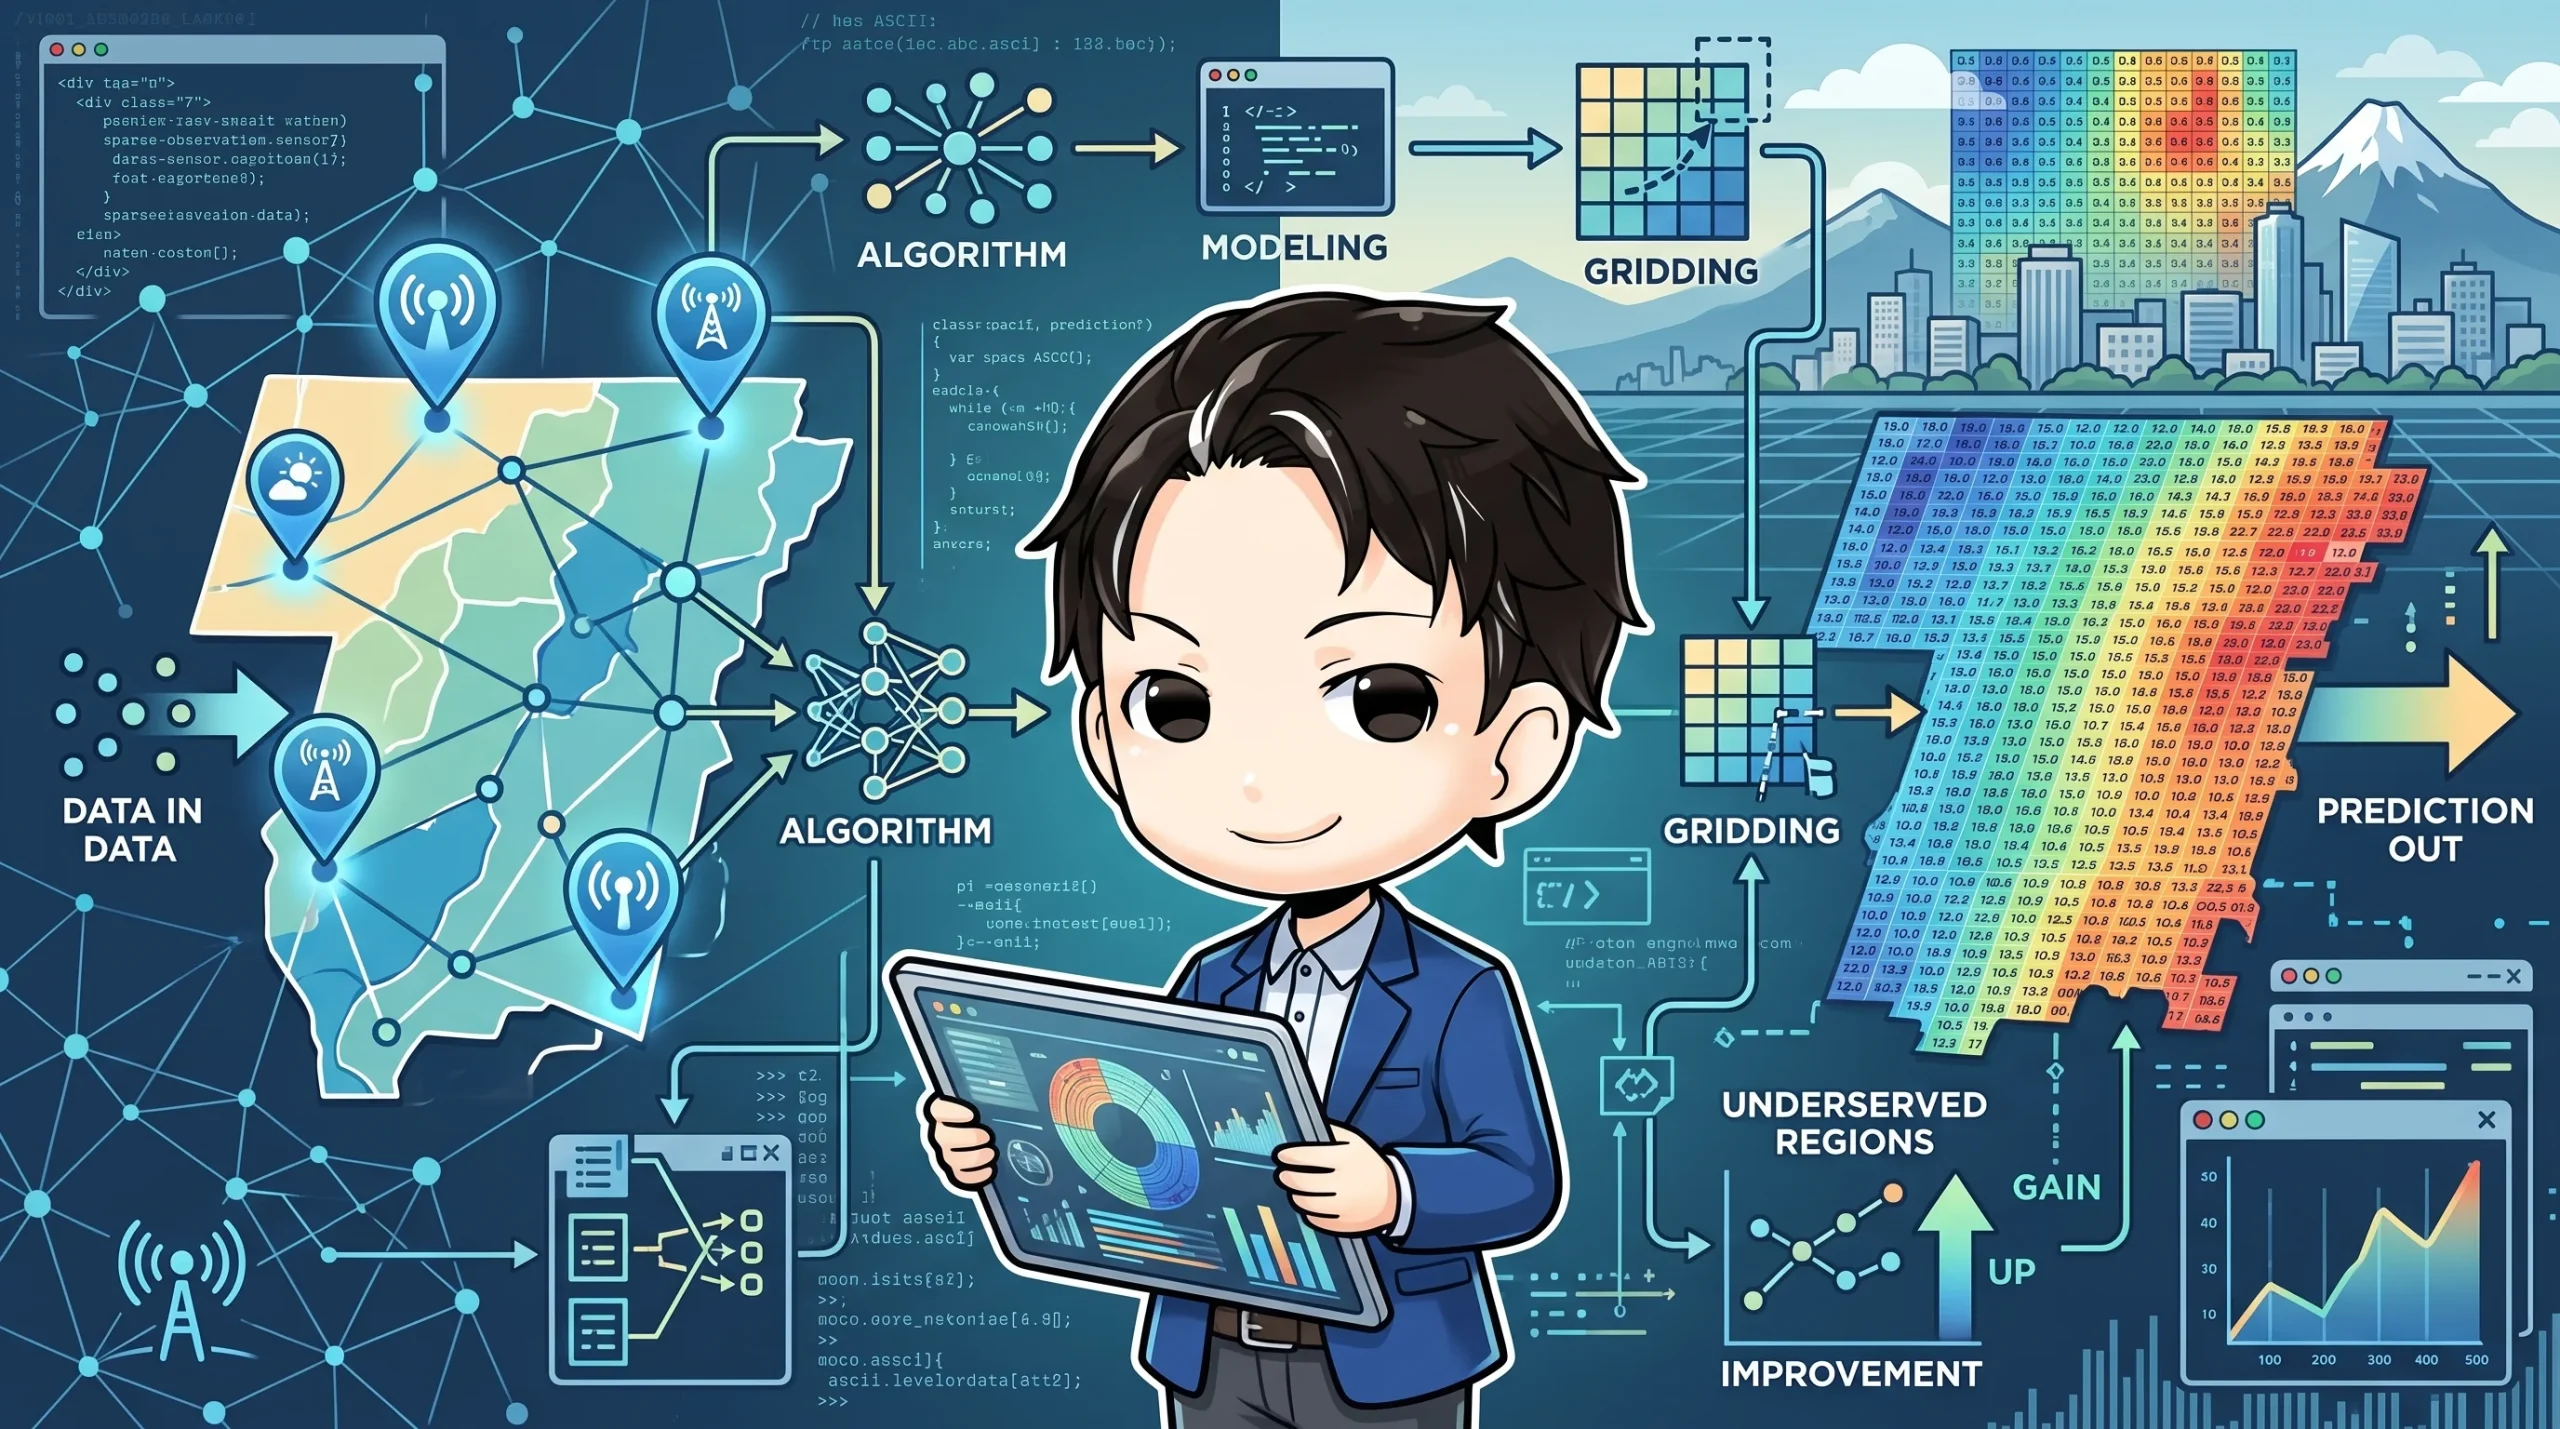
従来の再解析データ(すでに格子状に整形された観測データ)を経由するのではなく、観測データを直接学習に使うことで、局所的な気候差(マイクロクライメイト)まで捉えられるようになったとされています。
特に、これまで観測点が少なかった地域(underserved地域)で精度改善が大きかった点は、示唆に富んでいます。
これは気象予報に限った話ではありません。
「疎な観測点データから、どうやって高解像度な空間予測をつくるか」は、IoTセンサー、店舗の来店予測、物流の需要予測など、地理的・空間的な粒度を扱う多くのプロダクトに共通する設計課題です。
本記事では、この課題を技術的に分解し、実装のとっかかりになる考え方とコード例を整理します。
こんな人におすすめ
- センサーデータや観測点データから、より細かい粒度の空間予測を作りたいエンジニア
- IoTデバイスやPOSデータなど、まばらにしか手に入らないデータを扱っているデータエンジニア
- 空間補間・ダウンスケーリングという概念をなんとなくしか理解していない方
- グリッド(格子)ベースの予測モデルを設計・評価する機会がある方
- 「データが少ない地域ほど精度が悪くなる」という課題に心当たりがある方
なぜ「解像度を上げる」のは単純な補間では済まないのか
観測点は空間的に均一に配置されているわけではありません。
都市部には観測点が密集し、山間部や海上には観測点がほとんどない、というのが実態です。
ここで単純な線形補間や最近傍法を使うと、観測点が少ない領域では「なんとなく周辺の値を引き伸ばした」だけの予測になり、局所的な地形や気候の影響を反映できません。
import numpy as np
from scipy.interpolate import griddata

# 疎な観測点(緯度, 経度, 観測値)
points = np.array([[35.6, 139.7], [35.4, 139.9], [36.1, 140.0]])
values = np.array([28.5, 27.9, 26.8])

# 格子点を用意して単純補間
grid_lat, grid_lon = np.mgrid[35.0:36.5:0.05, 139.0:141.0:0.05]
grid_values = griddata(points, values, (grid_lat, grid_lon), method="linear")
このコード自体は動きますが、観測点から離れるほど信頼性が落ちる、という性質を明示的には扱えません。
解像度を上げるということは「情報量を増やす」ことであり、単に格子を細かく切るだけでは達成できないというのが出発点になります。
観測データ直学習というアプローチ
従来型の気象予測パイプラインは、生の観測データ→品質管理・格子化された再解析データ→予測モデル、という順番で処理されることが一般的でした。
この「格子化」の工程で情報が一部失われてしまいます。
観測データを直接学習に使うアプローチでは、この中間工程を挟まず、点データ(緯度・経度・時刻・観測値)をそのままモデルの入力として扱います。
モデル側が「どの観測点をどれだけ信頼するか」を学習で獲得する形です。
概念としては、疎な入力を密な出力にマッピングする関数を、ニューラルネットワークで表現すると考えると理解しやすくなります。
import torch
import torch.nn as nn

class SparseToGridModel(nn.Module):
    """疎な観測点(座標+観測値)から密な格子出力を推定する骨子モデル"""

    def __init__(self, hidden_dim=64):
        super().__init__()
        # 各観測点を (lat, lon, value) から特徴ベクトルへ
        self.point_encoder = nn.Sequential(
            nn.Linear(3, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, hidden_dim),
        )
        # 格子座標をクエリとして受け取り、値を予測
        self.grid_decoder = nn.Sequential(
            nn.Linear(hidden_dim + 2, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, 1),
        )

    def forward(self, points, query_coords):
        # points: (N, 3) = 観測点の (lat, lon, value)
        # query_coords: (M, 2) = 予測したい格子点の (lat, lon)
        point_features = self.point_encoder(points)
        context = point_features.mean(dim=0, keepdim=True)  # 簡易的な集約
        context = context.expand(query_coords.size(0), -1)
        decoder_input = torch.cat([context, query_coords], dim=1)
        return self.grid_decoder(decoder_input)
実際のモデルはAttentionベースの集約や、複数時刻の系列情報を使うなどはるかに複雑ですが、「観測点の特徴を集約し、任意の格子座標をクエリとして値を問い合わせる」という骨格は共通しています。
この構造にしておくと、観測点の数や配置が変わっても同じモデルで推論できるという利点があります。
underserved地域での精度をどう評価するか
解像度を上げること自体は目的ではなく、「これまで精度が悪かった場所でどれだけ改善したか」が本質的な価値になります。
そのため評価も、全体平均のRMSEだけでなく、観測点密度別にスコアを分けて見る必要があります。
import pandas as pd

def evaluate_by_density(predictions_df, density_col="obs_density", error_col="abs_error"):
    """観測点密度の区分ごとに誤差を集計する"""
    bins = [0, 1, 5, 20, float("inf")]
    labels = ["観測点なし", "疎", "中程度", "密"]
    predictions_df["density_bucket"] = pd.cut(
        predictions_df[density_col], bins=bins, labels=labels
    )
    return predictions_df.groupby("density_bucket")[error_col].mean()
このように地域を観測点密度で層別化して評価すると、「平均では改善しているように見えても、実は密な地域だけが良くなっている」といった見せかけの改善を見抜けます。
underserved地域の精度改善を謳うプロダクトであれば、この層別評価は最低限の説明責任だと考えています。
自分のドメインに応用するには
気象データでなくても、この設計パターンはそのまま転用できます。
- 店舗の売上予測: POSデータがある店舗(密)とない地域(疎)を区別して予測モデルを組む
- IoTセンサーの異常検知: センサー設置密度の低いエリアの推定精度を別枠で評価する
- 物流の需要予測: 配送実績が少ない新規エリアへの拡張時に、既存エリアのパターンをどう転移させるか設計する
共通しているのは、「データが疎な場所ほど、モデルの不確実性を明示的に扱う」という姿勢です。
点推定だけでなく、信頼区間や不確実性スコアを出力に含めておくと、後工程での意思決定がしやすくなります。
つまづきやすいポイント
- 観測点の分布そのものにバイアスがある(都市部偏重など)ため、単純な精度改善だけを見ると「疎な地域の改善」を正しく評価できないことがあります
- 格子解像度を上げても、入力側の観測密度がボトルネックになっている場合、見た目の解像度が上がるだけで実質的な情報量は増えないことがあります
- 評価指標にRMSEなどの平均的な誤差だけを使うと、極端な気象イベントのような「まれだが重要な事象」の予測精度が見えにくくなります
- 疎なデータに対して表現力の高いモデルを使うと、過学習によって観測点周辺だけ異常に自信過�well なる(いわゆる過学習した補間)ことがあるため、正則化や不確実性の明示が重要です
まとめ
観測データを直接学習に使うことで解像度を大きく引き上げるというアプローチは、気象予測に限らず、疎なデータから高解像度な空間予測をつくりたい場面で応用できる考え方です。
ポイントは、単純な補間ではなく「観測点の特徴を集約し、任意の座標をクエリとして値を問い合わせる」構造にすること、そして評価を観測密度別に層別化することです。
自分のプロダクトでも、データが疎な領域をどう扱っているか、一度見直してみる価値はありそうです。